Rohan Paul (@rohanpaul_ai) · 2026/10/15 19:26:19
LLM 替代专用奖励模型驱动药物生成:免训练目标评分实现 DPO 冷启动优化
研究人员提出一种无需训练特定任务奖励模型的分子生成方法,直接利用大语言模型(LLM)根据自然语言目标对候选分子进行排序。该方法通过“由易到难”的渐进式目标设定解决 RLHF/DPO 中的冷启动问题,在基准测试中以 69.06 分超越传统基于真实评分函数训练的 SOTA 方法(57.04 分),显著降低了小团队进入生成式药物设计的门槛。
报道全文原始报道全文
Rohan Paul (@rohanpaul_ai) · 2026-10-15 11
现在,你可以用通俗的自然语言描述需求,让药物设计模型去实现它。
通常情况下,为了让模型生成更优的药物候选分子,你需要针对特定目标训练一个奖励模型(reward model)。而在这项工作中,他们省去了这一步,转而让 LLM 通过阅读你的英文目标来对输出结果进行评分。
对于那些无力为自身靶点构建打分模型的实验室来说,现在终于有了一条通往可控生成器的路径。这正是阻碍小团队进入生成式设计领域的门槛,如今这道门槛已被跨越。
RLHF 普遍存在冷启动问题:如果基础模型从未产生过优质输出,就无从排序。因此,LLM 会先设定一个较容易达成的目标并据此评分,随着模型能力的提升,再逐步提高标准。
基础分子模型在 38,500 个样本中未能产出任何可用命中结果。经过几轮这样的迭代后,它在 512 个样本的批次中成功产出了一个。
LLM 给出的分数经常完全错误,但这并不重要,因为 DPO 只需要知道“A 比 B 好”,而不需要精确的数值。
由 LLM 评分引导的模型表现优于那些直接针对真实打分函数训练的模型版本(得分分别为 69.06 vs 57.04),尽管前者从未见过任何一个真实分数。
↳ 引用 @r_de_santi (Riccardo De Santi): 我们正在将自然语言控制引入任何科学生成器。
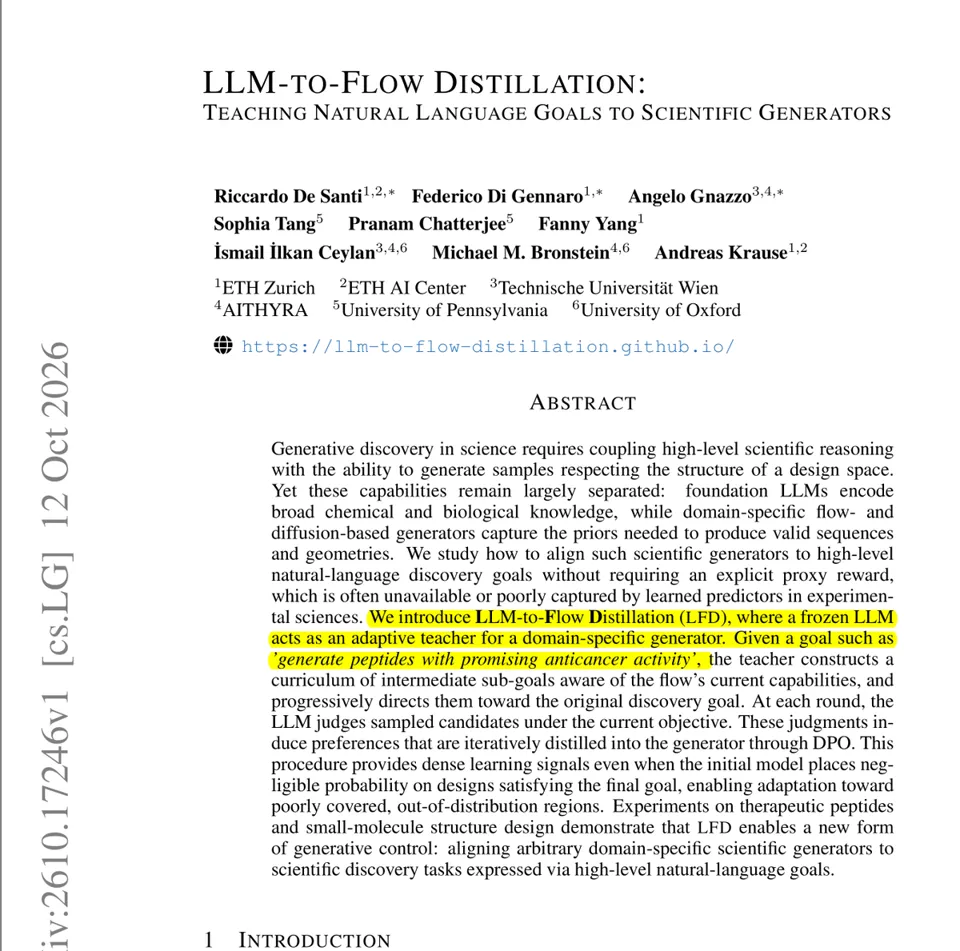
我们非常兴奋地推出 LLM-to-Flow Distillation (LFD),这是一种使科学生成器适应高层级自然语言发现目标的方法。
从诸如“设计具有潜在抗癌活性的肽”或“设计与 D2 多巴胺受体结合的小分子”等文本目标出发,LFD 通过对 LLM 生成的子目标进行迭代式 DPO,将高层级目标相关的知识从 LLM 蒸馏到科学生成器中。
🔥 LFD 不需要任务特定的代理奖励,可通过 API 访问与任何前沿 LLM 配合使用,并在保留的计算评估中超越了 FlowGRPO 和 DiffusionNFT 等最先进的奖励引导方法。(1/6)