返回全部资讯
Meta 发布 Muse Wonder 前沿模型:依托 Prometheus 数据中心实现超大规模训练,SWE-Marathon 基准超越 Opus 5.5Rohan Paul (@rohanpaul_ai)T2基座大模型
Rohan Paul (@rohanpaul_ai) · 2026/10/13 02:40:39
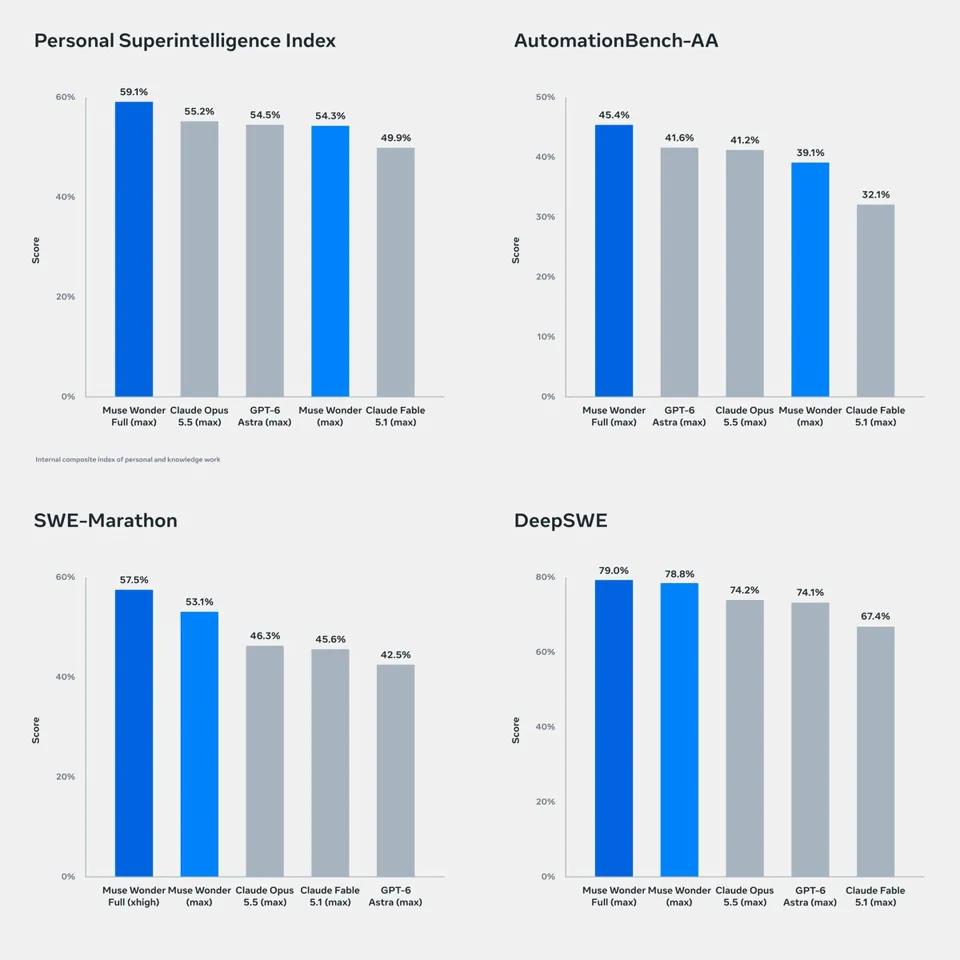
Meta 发布 Muse Wonder 大模型:SWE-Marathon 基准得分 57.5,超越 Claude Opus 5.5 与 GPT-6 Astra
出处作者 / 发布主体:Rohan Paul (@rohanpaul_ai)原标题:Meta is so back. in each of these benchmarks Muse Wonder beats both Opus 5.5 and GPT-6 Astra
78AI 研判分
核心综述
Meta 正式推出其最新前沿大模型 Muse Wonder,宣称在个人与专业智能体任务上达到 SOTA。该模型在衡量长程自主编码能力的 SWE-Marathon 基准中取得 57.5 分,显著高于 Anthropic 的 Claude Opus 5.5(46.3 分)及 OpenAI 的 GPT-6 Astra。这一结果标志着 Meta 在复杂软件工程代理领域重新确立技术优势。
报道全文原始报道全文
Rohan Paul (@rohanpaul_ai) · 2026-10-12 18
Meta 强势回归。在每一项基准测试中,Muse Wonder 均超越了 Opus 5.5 和 GPT-6 Astra。
差距最大的是 SWE-Marathon。该测试旨在评估 AI Agent 能否独立构建完整的软件项目(例如 C 编译器或 Slack 克隆版),耗时 2 到 10 小时不等,且只有当所有隐藏检查项全部通过时,才计入任务完成得分。
Muse Wonder 的完整得分为 57.5,而 Opus 5.5 为 46.3。
↳ 引用 @alexandr_wang (Alexandr Wang): 隆重推出 Muse Wonder
我们的全新前沿模型。在个人 Agent 和专业 Agent 领域均达到最先进水平(SOTA)。
这是我们迄今规模最大、能力最强的模型——足以与那些“巨头”一较高下