2015 年 CNN 在皮肤癌诊断中超越前沿大模型
一项对比测试显示,基于2015年Inception v3架构微调的卷积神经网络在皮肤癌诊断任务上表现优于GPT-6和Claude等前沿多模态大模型。在包含200个活检证实病变的数据集测试中,大模型将恶性黑色素瘤误判为良性病变并建议出院,而专用CNN准确识别了病情。该结果揭示了通用视觉语言模型在特定垂直医疗领域相较于传统专用小模型的局限性。
报道正文
本文目录7 个章节
这是一例黑色素瘤。
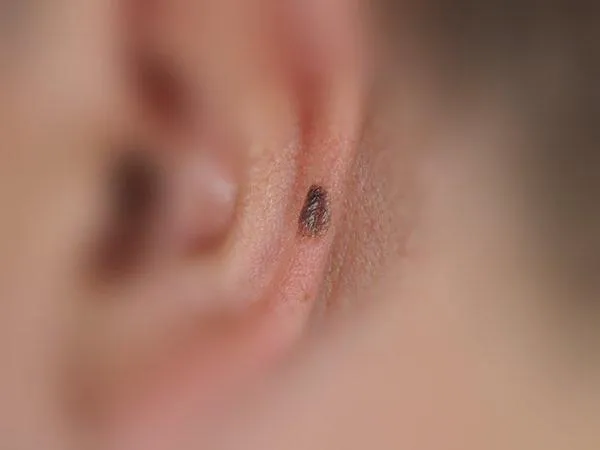
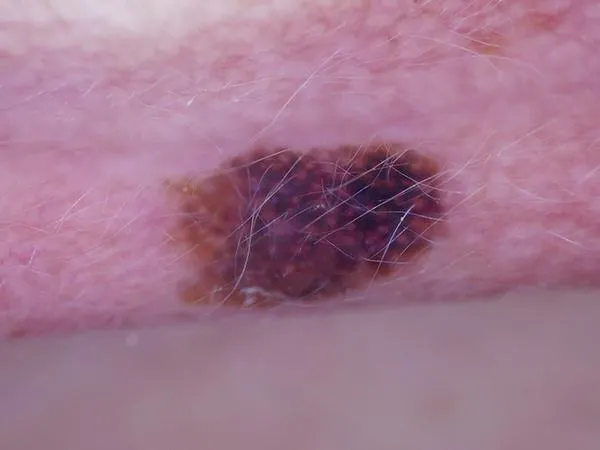
图 1. 耳部浸润性黑色素瘤,厚度小于 0.8 mm。两个 LLM 均将其诊断为脂溢性角化病,并认为患者可以出院。而 CNN 则正确识别为黑色素瘤。左侧为临床照片,右侧为皮肤镜图像。图片来源:MILK10k,MILK 研究团队,CC BY-NC。
我将这两张图像——一张临床照片和一张皮肤镜(皮肤显微镜)图像——展示给了 GPT-6 Astra 和 Claude Fable 5.1,这是 2026 年 10 月可用的两款最强大的 AI 模型。两者都判断这是脂溢性角化病,一种无害的疣状增生,并建议患者出院。随后,我将这些图像展示给经过微调的 Inception v3,这是一种由 Google 于 2015 年首次发布的卷积神经网络(CNN),此处基于公开皮肤科图像进行了微调。CNN 根据皮肤镜视图给出了正确答案。
这是我提供给这三个模型的 200 个经活检证实的病变之一。CNN 在 125 个案例中正确指出了诊断结果(共 6 种可能性),准确率为 62%。两个前沿 LLM 分别正确指出了 84 和 85 个案例,准确率约为 42%。一个已有十年历史的网络,仅经过约二十分钟的微调,就在识别皮肤癌方面击败了这两个模型。
测试#
这些病变来自 MILK10k,这是一个通过国际皮肤影像协作组织(International Skin Imaging Collaboration)于 2025 年发布的公共数据集。在该数据集中,每个病变都被拍摄了两次:一次是临床特写,另一次是通过皮肤科医生使用的带照明放大镜拍摄的皮肤镜图像。我随机抽取了 200 个经组织病理学确认的病变:
- 100 个不应出院的病变: 30 个黑色素瘤,25 个基底细胞癌,25 个鳞状细胞癌(包括 Bowen 病)以及 20 个日光性角化病。
- 100 个可安全出院的病变: 50 个良性痣(moles)和 50 个脂溢性角化病。
所有病变均经过活检,包括那些良性病变,因此这些病例更难诊断:一个人决定切除的痣,通常是让临床医生感到担忧的痣。
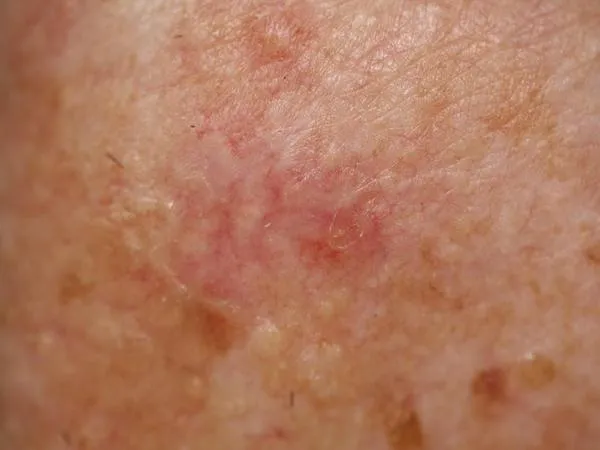
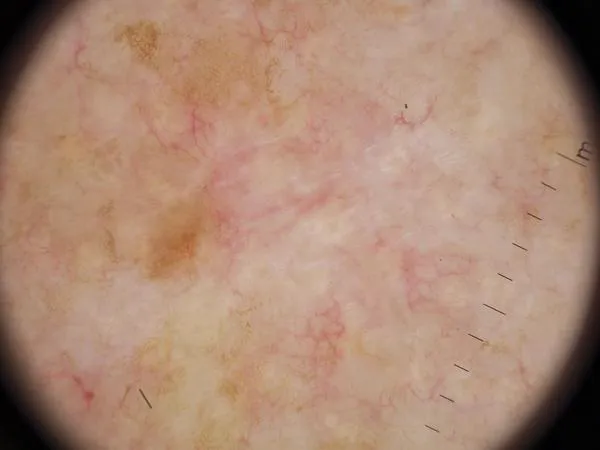
一名 75 岁男性躯干上的基底细胞癌。三个模型均回答正确。
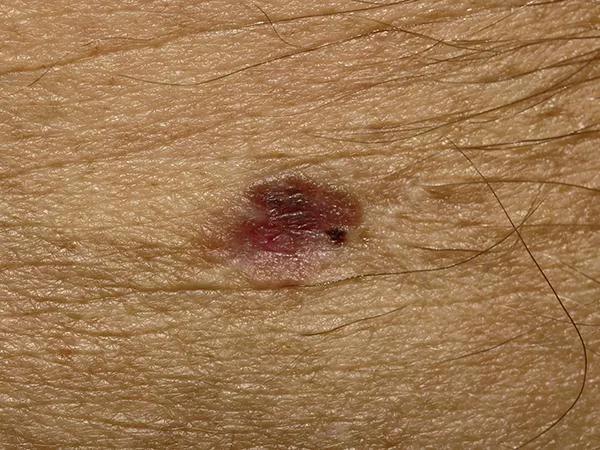
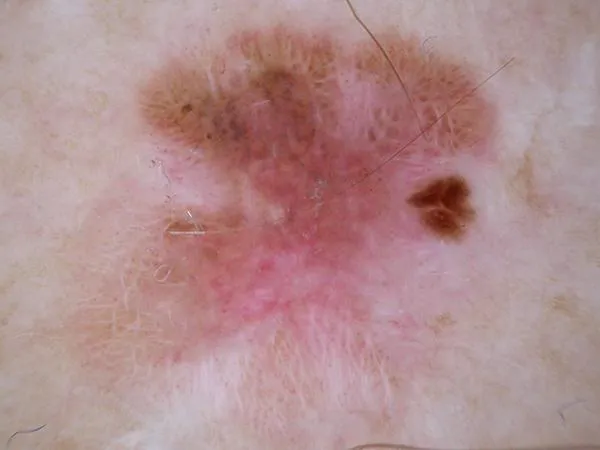
厚度小于 0.8 mm 的浸润性黑色素瘤,色素极少。GPT-6 Astra 将其判定为基底细胞癌(置信度 95%)。Claude Fable 5.1 和 CNN 将其判定为黑色素瘤。
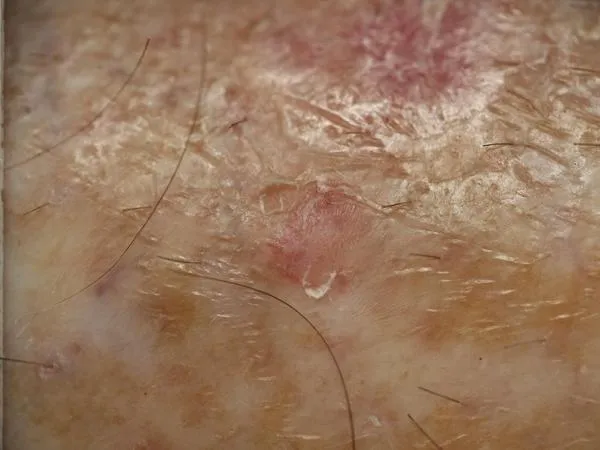
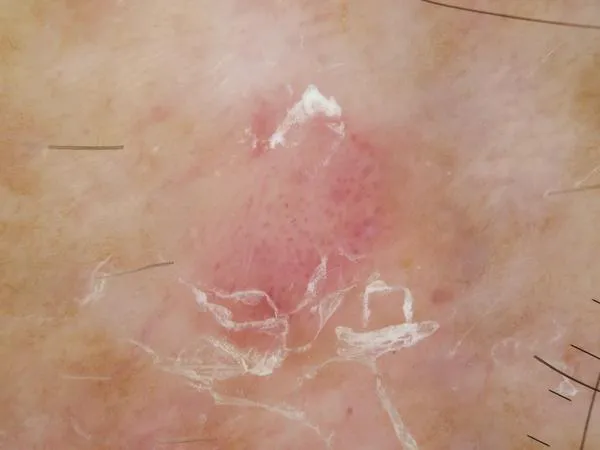
腿部脂溢性角化病。两个大语言模型(LLM)均将其判定为日光性角化病,而卷积神经网络(CNN)将其判定为鳞状细胞癌:三者皆错,但三者都会选择保留观察而非让患者出院。
图 2. 200 个测试病灶中的另外三个。左侧为临床照片,右侧为皮肤镜图像。图片来源:MILK10k,MILK 研究团队,CC BY-NC。
大语言模型(LLMs)仅被提供这两张图像,未获得其他信息,并被要求像临床医生使用它们那样,从六种诊断中给出最可能的诊断(或“不确定”)、置信度、第二选择,以及该病灶是否可以安全出院且无需治疗、活检或随访。两个模型在默认设置下接收相同的提示词,且均未拒绝任何病例。
CNN 并非刻意采用最先进(state-of-the-art)的技术。我使用了在普通照片上预训练的 Inception v3,然后在单块 H100 GPU 上,利用来自 ISIC Archive 的 68,011 张皮肤镜和临床图像对所有层进行了微调。这 200 个测试病灶以及同一病灶或患者的其他所有照片,在训练前已从数据集中移除(包括验证集),因此模型从未见过这些数据,且这些数据也未用于选择模型或设定阈值。模型对每个病灶的两张图像进行评分,并将大部分权重分配给皮肤镜图像以合并结果,最后从相同的六种诊断中做出选择。
你可以亲自尝试这个 CNN。值得注意的是,该模型足够小巧,完全可以通过 WebGPU 在手机浏览器中运行。没有任何数据被上传,其随机样本按钮也是从这同样的 200 个病灶中抽取。
诊断:62% 对比 42%#
图 3. 两个 LLM 和 CNN 的首选正确诊断率,它们均从相同的六种诊断中进行选择。标签显示的是具有该组织学特征的病灶中回答正确的数量。
总体而言,CNN 在大多数诊断上的准确率都更高。如果允许给出第二选择,它的正确率达到 200 例中的 173 例,而另外两个模型分别为 134 例和 138 例。在 30 例黑色素瘤中,它正确识别了 13 例,而其他模型分别识别了 8 例和 11 例。最大的差距出现在良性病变上:它识别出了 50 例痣中的 37 例和 50 例脂溢性角化病中的 26 例,相比之下,GPT-6 Astra 分别为 16 例和 13 例,Claude Fable 5.1 分别为 33 例和 6 例。在基底细胞癌方面,它比 GPT-6 Astra 少一例;在日光性角化病方面,它落后于两个 LLM。
这些模型的失败模式也各不相同。每个 LLM 都有一个偏好的答案:GPT-6 Astra 将 75 个病灶诊断为基底细胞癌,而实际只有 25 个是,其中包括 30 例黑色素瘤中的 14 例;Claude Fable 5.1 将 53 个病灶诊断为日光性角化病,而实际只有 20 个是。CNN 在黑色素瘤上的错误则呈现相反的趋势:在它判断错误的 17 例中,它将 8 例误判为色素痣,6 例误判为脂溢性角化病。
结果汇总表#
| GPT-6 Astra | Claude Fable 5.1 | CNN (Inception v3) | |
|---|---|---|---|
| 正确诊断数(共 200 例) | 84 (42%) | 85 (42%) | 125 (62%) |
| 第一或第二选择正确数 | 134 | 138 | 173 |
| 首选诊断为黑色素瘤数(共 30 例) | 8 | 11 | 13 |
| 保留的不安全病变数(共 100 例) | 97 | 96 | 预设阈值下为 77;匹配条件下为 98 或 99 |
| 放行的安全病变数(共 100 例) | 32 | 22 | 预设阈值下为 76 |
| 被放行的黑色素瘤数(共 30 例) | 3 | 4 | 预设阈值下为 18;匹配条件下为 2 或 1 |
注意事项#
- 样本量小。 200 个病变足以展示整体模式,但不足以对接近的结果进行排名;而仅 30 例黑色素瘤导致最关键指标的置信区间过宽。每个 LLM 案例仅运行一次;不同运行之间的答案存在差异。
- 疑难病例。 所有病变均经过活检确认。在来自档案库的常规图像上,CNN 区分应放行与不应放行的病变效果要好得多(ROC 曲线下面积为 0.96,而本研究中仅为 0.86)。
- 数据污染。 MILK10k 数据集自 2025 年起已公开,因此 LLM 可能在训练过程中见过该数据;如果确实如此,这反而可能提升了它们的表现。而 CNN 肯定未见过该数据。
- 非最先进水平。 Inception v3 只是一个基线模型。当前最先进的皮肤癌诊断 AI 使用基于更多数据训练的视觉 Transformer 集成模型,且基于这些模型构建的受监管产品性能显著更优。
以患者身份提问#
若以患者身份提问,仅提供临床照片并询问“我需要看医生吗?”,两个 LLM 在几乎所有情况下都建议就医,包括无害病变:对于另外 100 例经活检证实的黑色素瘤,分别有 99 和 98 例给出了就医建议。
结论#
一个小型、陈旧、专门化且采用过时架构的网络,在识别皮肤病变方面远优于两个前沿 LLM。
自行运行#
测试案例、提示词、所有 LLM 回复及评分代码均可在此下载,CNN 模型可在此获取。
我设计了测试方案并做出了临床判定。分析和初稿由 Claude Code(Anthropic 的编码工具,基于 Claude 模型运行)生成;所测试的两个 LLM 中有一个也来自 Anthropic。评分是通过脚本对照组织学结果完成的。
图片来自 MILK10k 数据集(MILK 研究团队,国际皮肤影像协作组),在 CC BY-NC 许可下使用。
Magnus Lynch 博士是盖伊医院(Guy's Hospital)的顾问皮肤科医生和 Mohs 外科医生,同时也是伦敦国王学院的名誉研究员(相当于副教授)。他的临床工作涵盖皮肤癌、Mohs 手术和面部重建手术以及激光治疗;他的研究方向包括皮肤癌和疤痕的细胞生物学,以及 AI 在皮肤病学中的应用。完整个人简介