Google 发布 PLE 基准:最强 AI Agent 工程任务仅得 50.6%
原标题:New Google paper finds that the best AI agent scores only 50.6% on physical engineering jobs, often ...
78AI 研判分
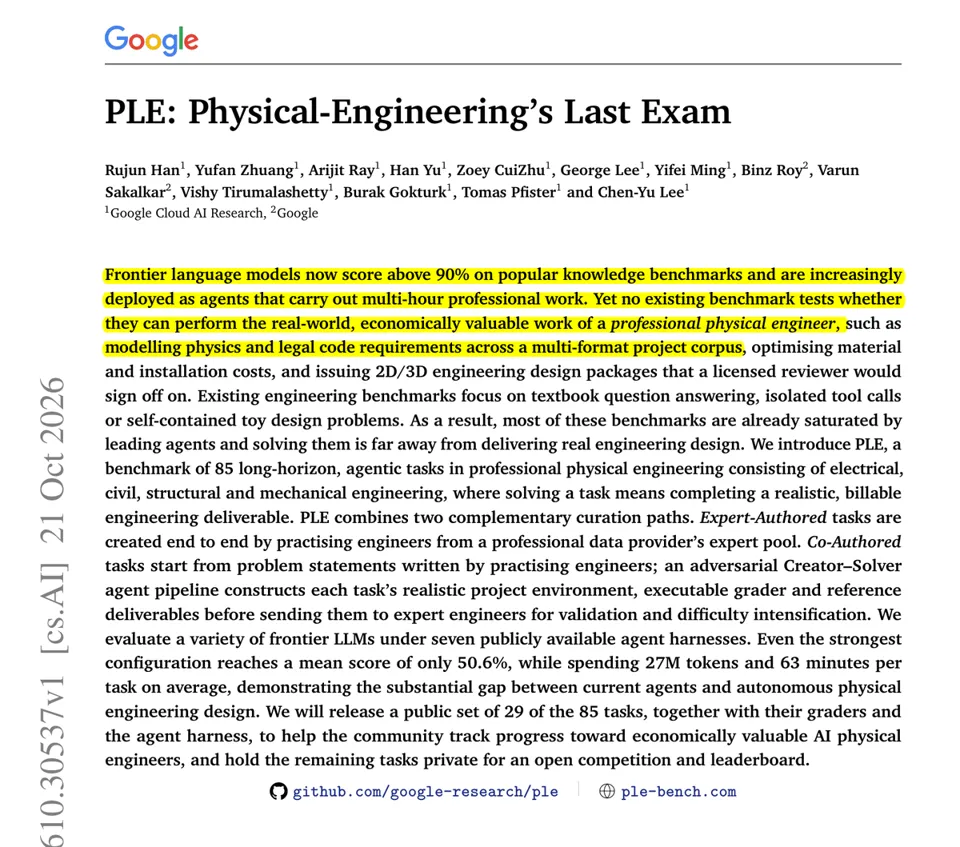
Google 推出面向真实物理工程任务的 PLE 基准,涵盖电气、土木等 85 个由执业工程师审核的任务。测试显示,表现最佳的 Claude Opus 5.5 得分仅为 50.6%,主要失败原因是未能满足硬性安全或可行性约束。该研究指出,现有 LLM 基准多偏向教科书问题,而真实工程场景需处理大量非结构化文件并严格遵守规范。
报道正文
Rohan Paul (@rohanpaul_ai) · 2026-10-28 22
谷歌最新论文发现,表现最佳的 AI Agent 在物理工程任务上的得分仅为 50.6%,失败原因通常是遗漏了严格的安全或可行性规则。
目前针对 LLM 的工程基准测试大多侧重于教科书式问题或玩具级难题,而顶尖的 Agent 已能轻松应对这些内容。然而,现实中的工程师需要处理海量的 PDF、电子表格和 CAD 文件,并必须输出符合规范且成本可控的设计方案。
研究团队构建了 PLE 数据集,包含 85 个电气、土木、结构和机械领域的真实任务,均由执业工程师编写或审核。Agent 在每个任务中需阅读约 61 个项目文件,并交付进度表、报告或 2D/3D 图纸。
Claude Opus 5.5(配合 Claude Code)在 14 个模型中位列第一,得分为 50.6%,平均每个任务消耗 2700 万 tokens,耗时 63 分钟。在设计类任务中,其输出满足了 91% 的约束条件,但仅有 41.3% 的结果满足所有硬性约束。
如果你正在构建工程类 Agent,请务必将严格的安全规范和代码限制作为设计输出的门槛,并在优化 Agent 框架之前优先投入精力进行模型选型。