Artificial Analysis (@ArtificialAnlys) · 2026/10/13 01:51:28
Artificial Analysis 上线 FrontierCode 1.1 榜单:以真实开源仓库合并标准评估代码智能体
Artificial Analysis 发布基于 Cognition FrontierCode 1.1 的评测榜单,该基准要求模型在真实开源仓库中完成能被维护者接受的代码修改。评测采用私有任务集与双重检查机制(单元测试+定性审查),旨在通过“可合并性”这一更贴近生产环境的指标,解决传统编码基准易过拟合测试用例的问题。
报道全文原始报道全文
Artificial Analysis (@ArtificialAnlys) · 2026-10-12 17
我们即将发布 FrontierCode 1.1 排行榜,这是由 Cognition 提供的一项私有评估基准,旨在测试模型完成编码任务的能力,其标准是这些更改能否被真实世界代码仓库的维护者实际合并。
@cognition 于 2026 年 6 月发布了 FrontierCode,并于 7 月更新至 1.1 版本。Cognition 与开源维护者合作构建了该数据集,每个任务的耗时超过 40 小时。每项任务要求 Agent 对真实的开源仓库进行修改,随后通过单元测试和定性测试来验证维护者在合并更改时所需的标准。
我们使用 Stirrup 开源参考框架运行 FrontierCode 1.1 Main(该基准共 150 个任务中的主要 100 个任务集),以确保不同模型之间进行公平对比。所有任务均为私有数据,以避免数据污染。每次尝试均依据“阻断性”和“非阻断性”标准进行评分:若未通过任何一项阻断性检查,得分为零;若全部通过,则得分介于 70% 至 100% 之间。
与其他编码评估不同,FrontierCode 基于实际使用情况,对成功有着更全面的视角。模型不仅需要通过单元测试,还会就其行为进行评估,例如是否进行了过度修改、产生了巨大的 diff、修改了无关范围之外的文件,或添加了无用的测试用例。我们认为这种方法在当前语境下极具价值:尽管模型在编码任务上已具备很强的能力,但其生成的更改往往仍需大量清理工作,才能被维护者接受并合并。
关键要点:
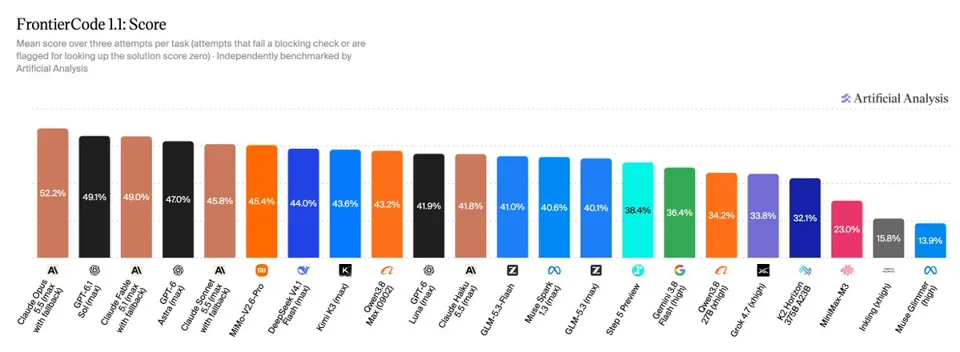
➤ 领先模型的失败率仍超过 40%:Claude Opus 5.5(max 模式带 fallback)以 52% 的得分位居榜首,其在 58% 的尝试中通过了阻断性检查。在我们为发布所评估的所有模型中,有 9 个任务在任何一次尝试中都未被任何模型通过。
➤ 排行榜头部竞争极为激烈:来自六家实验室的九个模型得分集中在 43% 至 52% 之间。MiMo-V2.6-Pro 以 45% 的得分成为领先的开放权重模型,紧随其后的是 DeepSeek V4.1 Flash (max) 和 Kimi K3 (max),两者得分均为 44%。
➤ GPT-6.1 Sol (max) 提供了最具性价比的性能:每任务成本仅为 $0.81,得分为 49%,与 Claude Fable 5.1 (max with fallback) 持平。这意味着它以不到 Anthropic 领先模型十分之一的单任务成本,实现了相当的性能表现。
感谢 @silasalberti、@ybenpan、@cl571128 以及 Cognition 团队的其他成员构建 FrontierCode,并与我们合作将其引入 Artificial Analysis——我们正努力尽快将 FrontierCode 添加到我们的编码智能体排行榜中。