Stanford HAI News · 2026/10/19 08:00:00
斯坦福团队发布医疗 AI 基准 强调临床工作流评估
针对大模型在医疗执照考试中高分但临床落地难的现状,研究团队构建了 MedHELM、PhysicianBench 等渐进式基准。这些工具旨在评估 AI 在真实电子病历系统中的端到端任务处理能力,而非单纯的知识问答。项目呼吁社区贡献特定工作流基准,以推动医疗 AI 从理论向实用转化。
报道全文原始报道全文
本文目录5 个章节
过去三年,我们构建了难度递增、更贴近现实的医疗 AI 基准测试。以下是我们的经验总结。
如今,大语言模型在执业医师资格考试中已接近满分,这激发了人们对 AI 在医疗健康领域潜力的热情。然而,在多项选择题考试中取得高分与在实际医疗系统中工作完全是两回事。执业资格考试考察的是给出正确答案的能力;而医疗系统则要求你打开病历,找到两年前的超声心动图报告,将其与今早的实验室检查结果进行核对,决定下一步行动方案,下达医嘱,并撰写病历记录。前者考察的是知识储备,后者考察的是你能否跨越时间、文档和软件系统完成多项任务。如果我们想知道 AI 是否具有临床实用价值,就必须针对实际处理的任务对其进行评估。
正是这一区别推动了我们三年来构建难度递增、更贴近现实的医疗 AI 基准测试的工作。我们首先推出了 MedHELM,这是一项系统性工程,旨在全面梳理临床任务图谱,并衡量当前最佳模型在这些任务上的表现。随后,我们深入开发了 PhysicianBench,该测试评估 AI 智能体能否在功能完整的电子健康记录(EHR)环境中端到端地完成真实临床任务;以及 HealthAdminBench,用于探索行政管理和工作流程方面的能力。
这些基准测试揭示了同样的结果:当前最佳的 AI 智能体只能完成不到一半的工作量。当智能体在不同步骤、文档和系统之间切换时,往往会丢失信息线索。
在这篇文章中,我们将介绍这些测试的构建方法、研究发现,以及缩小 AI “声称能做到”与“实际能做到”之间差距所需的努力。
MedHELM:描绘完整的工作全景
2023 年,在 MedAlign 项目中,15 位临床医生编写了 983 个他们通常会向患者病历提出的问题。当时表现最佳的模型 GPT-4 在其回复中出现了 35% 的错误率,这促使我们在 2024 年初构建了 MedHELM。
MedHELM 是我们尝试进行系统化 基于任务的评估 的一次实践。我们从需要完成的工作或任务出发,围绕这些任务设计测试。在 29 位临床医生的参与下,我们构建了一个包含五个类别、22 个子类别和 121 项任务的分类体系,反映了医疗护理中常见的工作内容。这些类别包括临床决策支持、临床笔记生成、患者沟通与教育、医学研究辅助以及行政与工作流(图 1)。
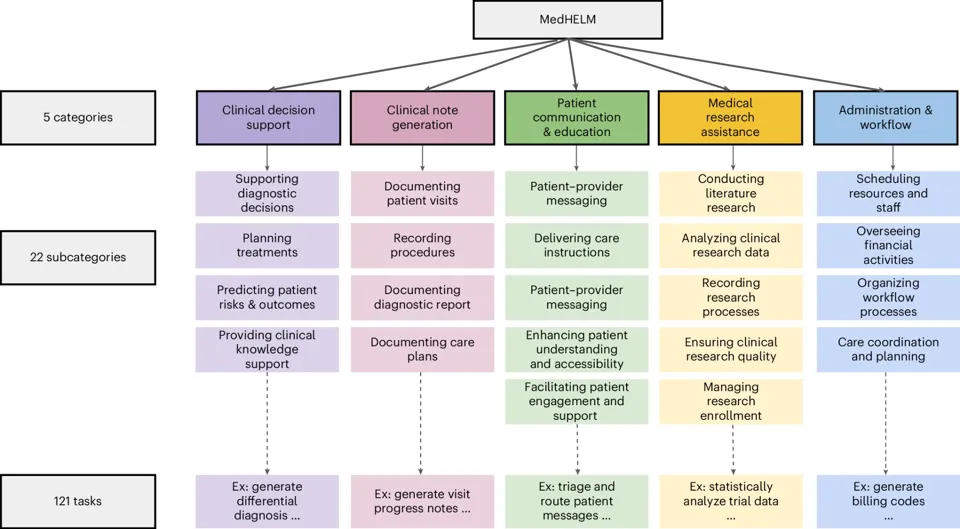
图 1:MedHELM 分类体系包含 5 个主要类别、22 个子类别和 121 项任务。图片源自 Bedi, S., Cui, H., Fuentes, M. et al. Nat Med 32, 943–951 (2026)。
我们汇集了 37 个基准数据集以覆盖每个子类别,并评估了九个前沿模型在这些基准上的表现。我们使用 LLM 评审团根据临床医生定义的标准进行评分,确保评审团与临床医生的一致性达到临床医生之间相互一致的水平。我们考察了“胜率”,即在所有基准的成对比较中,每个模型取得更优表现的占比(可能范围:0–1)。结果显示,LLM 模型在前五大类别中的最高和最低胜率如下:
- 临床笔记生成:0.74 至 0.85
- 患者沟通与教育:0.76 至 0.89
- 医学研究辅助:0.65 至 0.75
- 临床决策支持:0.63 至 0.77
- 行政与工作流:0.53 至 0.63
模型在临床决策支持和行政与工作流任务上持续表现不佳,而这恰恰是卫生系统最需要帮助以解决临床医生时间和行政成本问题的领域。仅在美国,行政支出每年就超过 1 万亿美元。潜在回报最大的类别得分最低。
任务即工作流
MedHELM 基准测试对单次响应进行评分:输入一个提示词,输出一段文本,然后对该文本进行评分。然而,在上述两个表现较弱的类别中,现实任务很少呈现这种形式。
事前授权(Prior Authorization)就是一个很好的例子。有人会在电子健康记录(EHR)中阅读医嘱,检查支付方的标准,提取支持性文档,填写门户表单,附加文件,提交申请,并将参考编号记录在病历中。专科会诊具有相同的结构:跨就诊检索数据、进行推理、下达医嘱以及记录文档。仅对模型在第 3 步生成的文本进行评分,无法告诉你第 7 步是否真正发生。
对于这些重要类别,我们需要一种不同类型的评估方法。给智能体提供一个环境、一个目标和一组工具,让它采取行动,然后检查环境中发生了什么变化。这正是 PhysicianBench 和 HealthAdminBench 背后的设计理念,前者探索临床决策支持与执行,后者探索行政管理与工作流。
机器学习风险预测鸿沟代表了“做出良好预测的模型”与“能改变患者实际结局的模型”之间的巨大差距。这些基准测试凸显了生成式 AI 鸿沟,即“模型所说的内容”与“模型实际能做的事情”之间的巨大差距。
PhysicianBench 和 MedAgentBench:AI 智能体能完成临床工作吗?
MedAgentBench 建立了 300 个基于真实患者的临床衍生任务,涵盖 10 个类别,由人类医生编写。这些任务基于虚拟电子健康记录计算环境中 100 名患者的真实档案。当该基准测试于 2025 年初发布时,即使是最好的前沿模型也只能达到不到 70% 的正确任务完成率。到 2026 年,随着智能体技术的进步,前沿模型的任务完成率已超过 90%。
PhysicianBench 进一步拓展了边界,包含 100 个长周期、多步骤任务,这些任务改编自初级保健医生与亚专科医生之间的真实医疗咨询,涵盖 21 个专业领域。每个任务都经过独立医生小组的审查。这些任务是在 EHR 沙盒环境中,针对合成重建的患者记录进行的。平均每个多步骤任务需要 27 次工具调用。
总体而言,评估任务结果共涉及 670 项检查,覆盖数据检索、临床推理、行动执行和文档记录。评分是基于执行结果的:特定任务的脚本会检查记录中是否存在正确的医嘱,而 LLM 则用于判断推理过程和笔记内容。
在 12 款模型中,表现最佳的 GPT-5.5 在单次尝试中完成了 46% 的任务。表现最佳的开源模型 DeepSeek V4-Pro 达到了 19%。一致性表现更差:GPT-5.5 在其三次运行中仅正确执行了 28% 的任务。
失败分析提供了更多洞察,因为临床推理方面仍存在局限,这解释了约一半的检查点失败原因。错误大多是不完整的推理和接近正确的结果,而完全错误的结论很少见。此外,还存在一种过去基准测试无法捕捉的失败类型。在行动执行失败中,GPT-5.5 有 62%,Claude Opus 4.6 有 73% 的情况是:智能体在笔记中写出了正确的操作,但从未在电子健康记录(EHR)系统中下达订单。AI 生成了措辞优美的文字并制定了良好的计划,但实际上并未完成工作。
HealthAdminBench:AI 智能体能做非临床工作吗?
HealthAdminBench 针对的是医疗系统努力和人员配置的大头:即发生在每次患者就诊背后的账单、授权和行政工作。幕后行政人员的数量正在迅速增长,并且可能已经以 10 的比例超过一线临床医生。我们花了超过 100 个小时观察斯坦福医疗中心的行政人员,构建了四个模拟 Web 环境:一个 EHR 系统、两个支付方门户和一个传真系统。AI 智能体能够像人类一样通过截图、点击和打字来操作这些环境。
共有 135 项任务分布在三个工作流程中(60 项预先授权、60 项申诉与拒付、15 项耐用医疗设备订单),分为三个难度级别,并由在职行政人员参与设计。每项任务分解为子任务,由 1,698 个验证器进行评分:其中 1,177 个为确定性检查,521 个为 LLM 评判标准。所有患者数据均为合成数据,这使我们能够发布这些环境并运行供公众使用的排行榜。
当时测试的最佳智能体——处于原生计算机使用模式的 Claude Opus 4.6——端到端完成了 36.3% 的任务。最佳开放权重模型 Kimi K2.5 完成了 15.6%。
一个关键区别在于,GPT-5.4 在计算机使用模式(computer-use mode)下通过了 82.8% 的单个子任务,但仅完成了 26.7% 的整体任务。局部能力的表现并不等同于整体工作流的可靠性。填写完表格却发送到错误的地址不算成功。患者不会因为系统完成了文档记录而开错药给予部分分数。
在这里,失败源于协调失误。智能体(Agents)在电子健康记录(EHR)中收集了稍后需要在支付方门户(payer portal)使用的信息,却未能将其记录下来,导致信息丢失。即使任务要求上传和下载文件,它们也常常遗漏这些步骤。它们很少回头修正之前的步骤,而是耗尽预算后停止运行。
综合解读基准测试
这些基准测试做出了互补性的侧重。PhysicianBench 侧重于基于真实临床记录的、面向临床医生的流程保真度。HealthAdminBench 则侧重于复现医疗系统中广泛行政流程的人类工作流。
管理 AI 采用的医疗体系需要这两类应用,并以发布(合成)数据、公开代码和排行榜作为可重复性和透明度的证据。
PhysicianBench 中 46% 的任务完成率这一头条性能指标,不能直接与 HealthAdminBench 中 36% 的任务完成率进行比较。两者的环境、模型集、接口和评分方案均不同。可以提出的合理主张是方向性的:两个独立构建、以执行为基础的基准测试——一个针对临床,一个针对行政——都发现当今最佳的智能体完成的工作量不足一半。在这两者中,主要的失败原因都是无法在不同就诊、文档和系统之间传递信息,这表明修复的关键至少与扩大模型规模一样,在于智能体架构和记忆机制(即更好的框架/工具链)。
这两个基准测试都可以追溯到 MedHELM 发现表现最弱的类别。MedHELM (www.medhelm.org) 由社区拥有,并在 Apache 2.0 许可证下发布,开放框架的意义在于其他人可以贡献特定类别的 工作流级基准测试。事实上,我们正在贡献 HealthAdminBench 和 PhysicianBench。如果您的医疗体系中有重要的工作流以及用于测试它的基准,我们邀请您将其贡献给 MedHELM。