新基准揭示 AI 编码工具在 XR 开发中频繁失败
原标题:New Google + UCLA + CMU paper finds that AI coding tools often fail to build virtual and mixed reali...
78AI 研判分
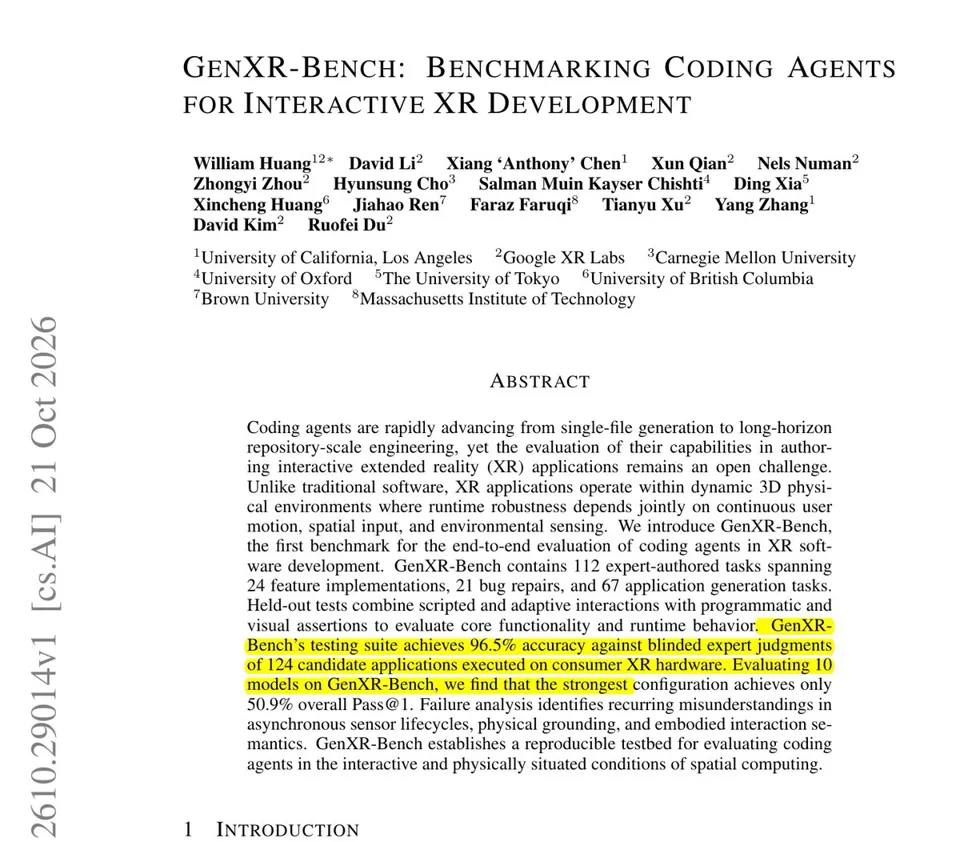
Google、UCLA 与 CMU 联合发布 GenXR-Bench,指出主流大模型在构建虚拟现实应用时表现不佳。Claude Opus 5 以 50.9% 的得分领先,但无模型在 SDK 特性任务上超过 29.2%,主要败因是三维空间坐标错误与启动竞态条件。
报道正文
由 Google、UCLA 和 CMU 联合发表的新论文发现,AI 编程工具在构建虚拟现实(VR)和混合现实(MR)应用时经常失败,原因在于它们难以追踪物体在 3D 空间中的位置。
Claude Opus 5 以 50.9% 的成绩领先,但在 SDK 功能任务上,没有任何模型得分超过 29.2%。在失败的运行中,64.4% 出现了坐标系错误,44.9% 涉及启动竞态条件。
XR 应用在 3D 空间中运行,并对头部运动、手部动作和房间感知做出响应。常规编程基准测试使用单元测试或浏览器点击操作,无法验证虚拟按钮是否跟随你的手掌移动。
他们构建了 GenXR-Bench,包含 112 个由专家编写的任务,涵盖 XR 功能开发、Bug 修复以及完整应用构建。其测试模拟了手部和房间环境,并与盲测的 XR 专家在使用真实头显时的判断结果有 96.5% 的一致性。
如果你使用智能体(Agents)来开发 XR 应用,请务必通过模拟的手部和房间输入来测试结果,因为智能体编写的单元测试往往无法捕捉到运行时 Bug。