Thinking Machines 开源 26B 循环 Transformer 模型
Thinking Machines 发布 Inkling 2 Mini,一款总参数 26B、激活参数 5.4B 的混合专家模型,采用循环层(looped transformer)架构,以 Apache 2.0 协议开源,支持文本与图像输入及 100 万 token 上下文。它在 Artificial Analysis 智能指数上取得 20 分,与 Qwen3.8 27B、Nanbeige4.3-33B 持平,但激活参数分别少约 5 倍和 6 倍,处于智能与参数规模的帕累托前沿,且小到可在 MacBook 或 DGX Spark 上本地运行。
报道正文
Thinking Machines 发布了 Inkling 2 Mini,一款开放权重的循环 Transformer
Thinking Machines 发布了 Inkling 2 Mini,在 Artificial Analysis 智能指数上得分为 20,是一款开放权重的循环 Transformer,位于智能与活跃参数对比的帕累托前沿
Inkling 2 Mini 是一款总参数 26B、活跃参数 5.4B 的混合专家模型。5.4B 的活跃参数计数包含对其循环层的三次遍历;每个文本 token 使用 3.1B 唯一权重,其规模小到足以在 MacBook 或 DGX Spark 上运行。
它以 Apache 2.0 许可证发布,支持文本和图像输入,上下文窗口为 1M token。
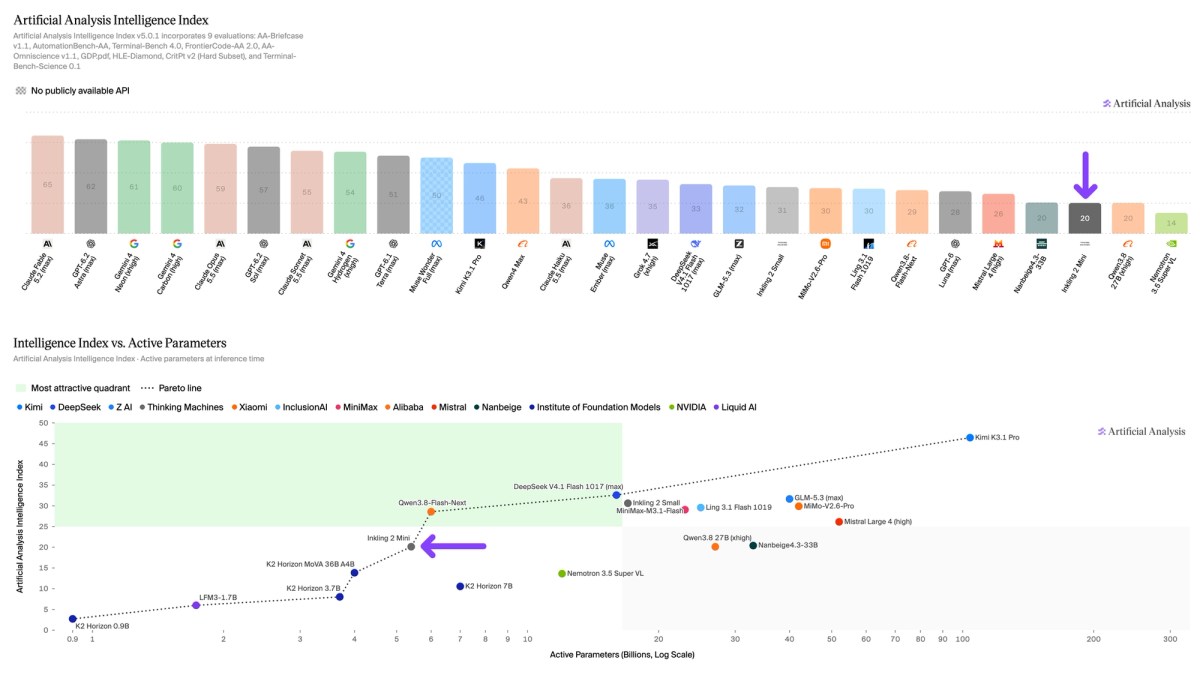
Inkling 2 Mini 在智能指数上与 Qwen3.8 27B(xhigh)和 Nanbeige4.3-33B 持平,而活跃参数分别少约 5 倍和约 6 倍。
它在总参数和活跃参数两个维度上都位于智能与规模对比的帕累托前沿。
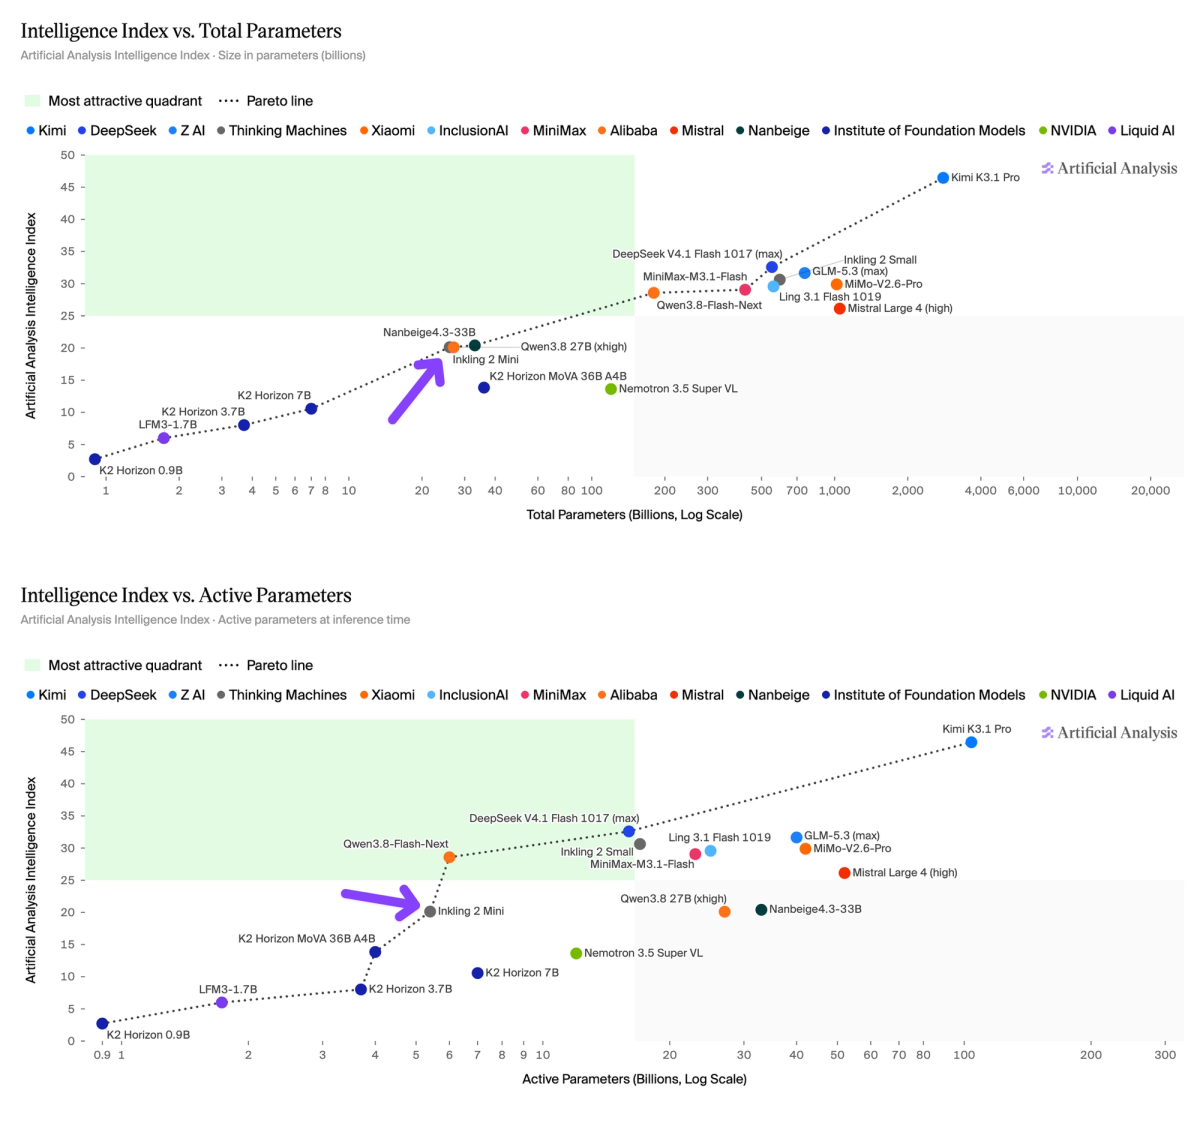
在相同智能指数得分下,Inkling 2 Mini 的输出 token 数比 Qwen3.8 27B 多约 38%,但计算量少约 2.8 倍。
其 24 层中有 12 层对每个 token 运行三次,在不增加输出 token 的情况下增加计算量。它在每个智能指数任务上平均输出约 152K token,而 Qwen3.8 27B 约为 110K,Nanbeige4.3-33B 约为 158K。在我们的计算量代理指标(活跃参数 × token 数)上,它位于帕累托前沿,计算量比 Qwen3.8 27B 少约 2.8 倍,比 Nanbeige4.3-33B 少约 5 倍。
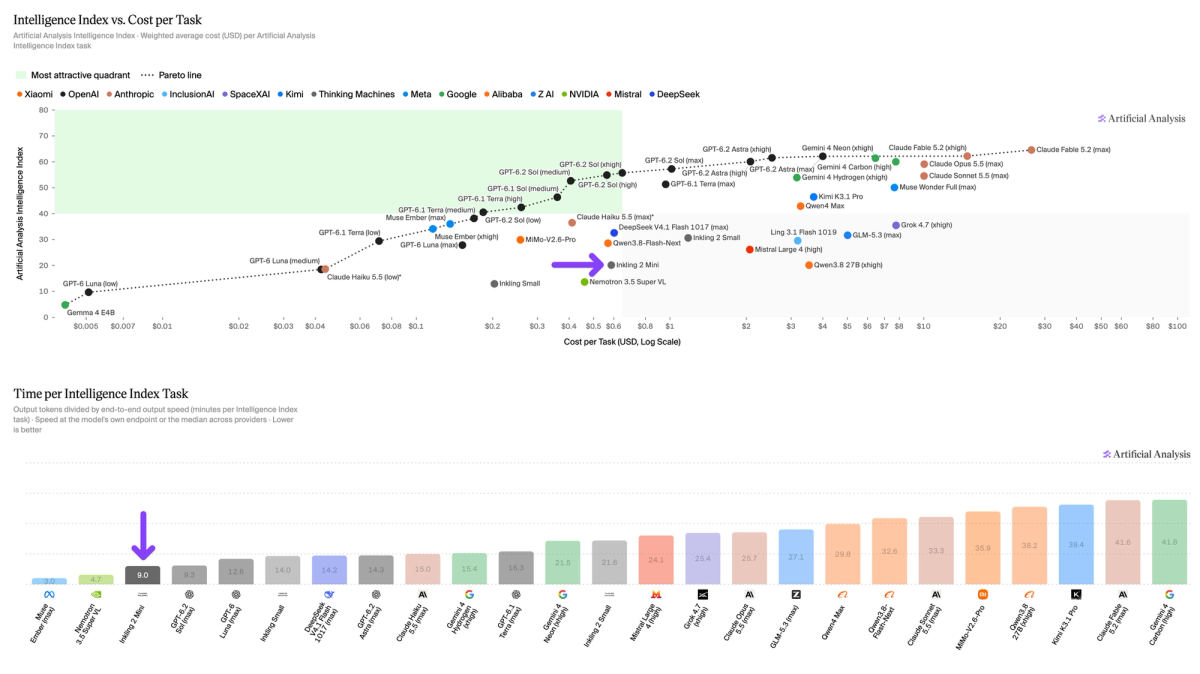
Inkling 2 Mini 每个任务的成本比 Qwen3.8 27B 低约 6 倍,速度快约 4 倍。
每个智能指数任务花费 $0.59、耗时 9.0 分钟,而 Qwen3.8 27B 为 $3.53、38.2 分钟。GPT-6 Luna(max)得分为 28,每个任务花费 $0.15。成本采用 Thinking Machines 的第一方定价(每 1M 输入/输出/缓存命中 token 分别为 0.50/$0.015)。
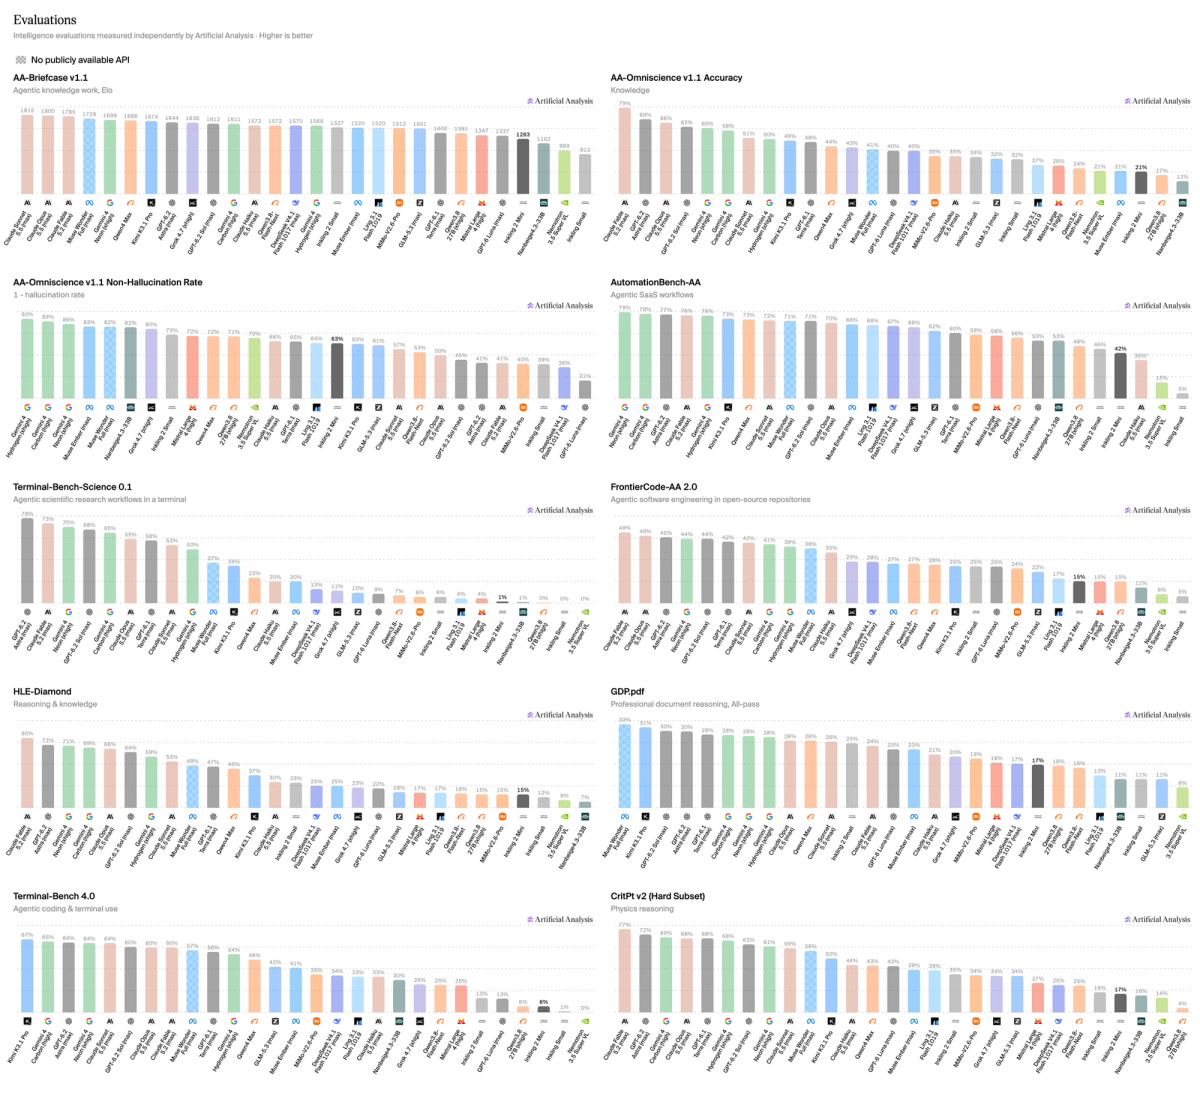
完整的智能指数评估明细: