谷歌研究:智能体框架模块化改写省 90% token
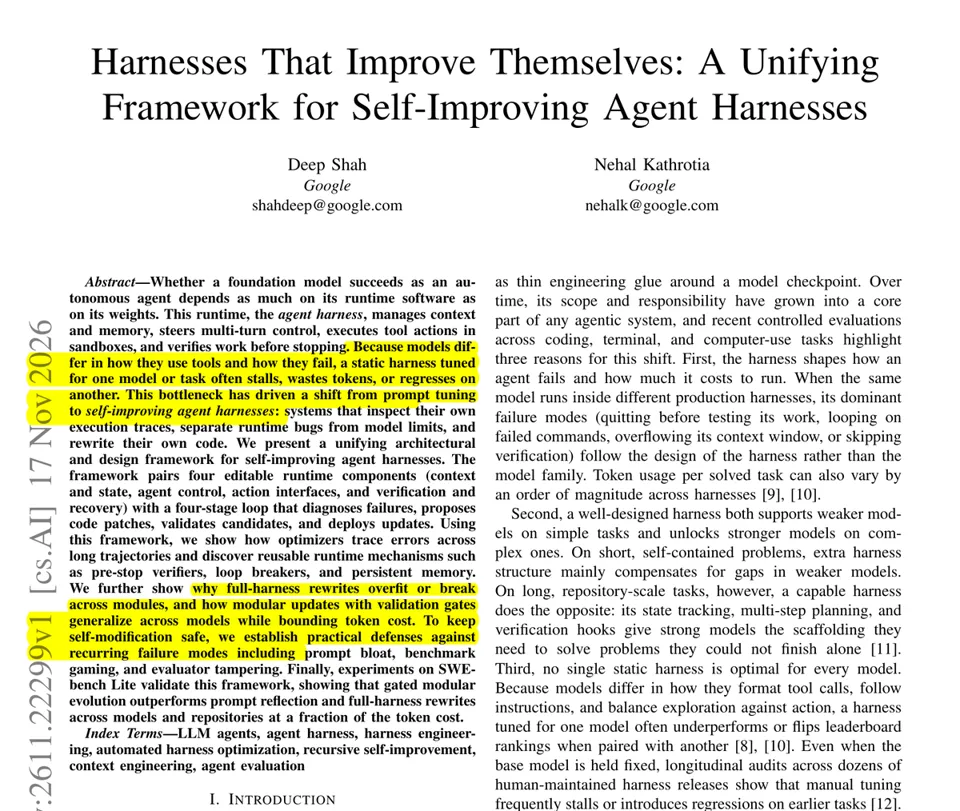
谷歌一项新研究发现,让优化器模型自我改进智能体框架时,逐模块改写并强制通过验证集与 token 上限,效果远优于不受限的整体重写。在 40 个 SWE-bench Lite 任务上,门控式改写以 46.7k token/任务达到 40.0% 准确率,而全量重写虽达 42.5% 却消耗 451.6k token,成本接近 10 倍。研究还发现,把规则写进提示词反而使准确率跌至 2.5%,约束应落在代码层。
报道正文
Rohan Paul (@rohanpaul_ai) · 2026-11-19 21
谷歌的一篇新论文发现,对 agent harness 进行不受约束的完整重写,虽然准确率相当,但每个任务消耗的 token 几乎是受门控的模块化编辑的 10 倍。
也就是说,自我改进的 agent harness 在每次只改动 1 个代码模块、并且必须通过验证时效果最好。
harness 是模型外围的代码,负责管理上下文、运行工具,并在停止前检查工作。为某个模型调优的 harness 换到另一个模型上,往往会停滞或浪费 token。
他们让一个优化器模型改进一个 142 行的编码 harness,每次只编辑其 4 个部分中的 1 个。每次编辑都必须通过验证集和 token 上限,否则就会被拒绝。
在 40 个留出的 SWE-bench Lite 任务上,使用 Gemini 3.8 Flash,受门控的 harness 解决了 40.0%,而种子版本为 5.0%,每个任务使用 46.7k token。不受约束的完整重写解决了 42.5%,但使用了 451.6k token,而提示词规则将准确率降至 2.5%。
如果你让 agent 调整它们的 harness,请用留出任务和 token 成本对每次改动进行门控,并在代码中强制执行规则,而不是在提示词中。