Qwen 开源 FlashQLA:GDN 线性注意力加速 2-3 倍
Qwen 团队正式开源基于 TileLang 的高性能线性注意力算子库 FlashQLA,专为 Gated Delta Network (GDN) 优化。该库通过 Gate 驱动的卡内序列并行与硬件友好的代数改写,在 NVIDIA Hopper 架构上实现前向计算 2-3 倍、反向计算 2 倍的加速,显著降低长上下文训练与推理开销。
报道正文
本文目录12 个章节
引言#
自 Qwen3-Next 发布以来,Gated Delta Network (GDN) 已经成为 Qwen 全系列的主力注意力层 —— 从 Qwen3-Next-80B-A3B 一路延伸到后续推出的 Qwen3.5 / Qwen3.6 系列。随着模型规模扩展到 397A17B / 122A10B / 35B / 27B,上下文长度突破 256K,GDN 这一模块在端到端训练与推理中的开销也变得不可忽视。
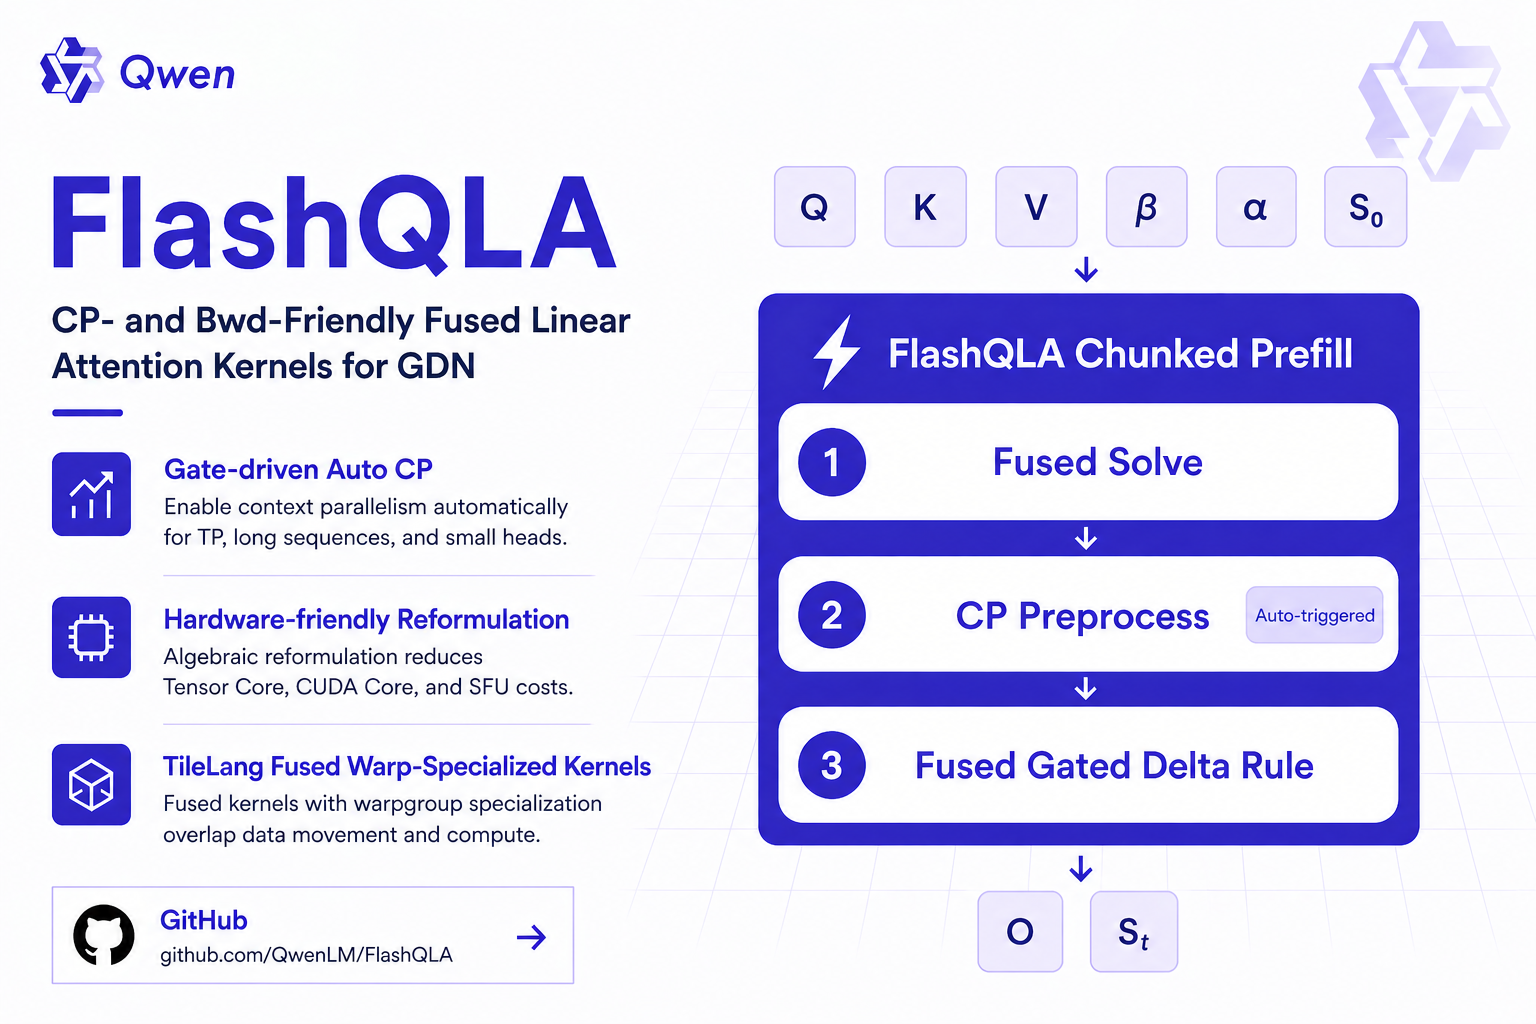
今天我们正式开源 FlashQLA : 一个基于 TileLang 实现的高性能线性注意力算子库。FlashQLA 将 GDN Chunked Prefill 的前向和反向 进行了合理的算子融合与性能优化,在 NVIDIA Hopper 上实现多场景相较于 FLA triton Kernel 2-3× 前向加速 和 2× 反向加速。对于预训练场景和端侧 agentic 推理效率提升明显。
本次发布的核心亮点:
- Gate 驱动的自动化卡内序列并行。利用 GDN gate 的指数衰减性质,FlashQLA 在 TP、长序列、小头数等场景下自动开启卡内序列并行,提高 GPU SM 利用率。
- 硬件友好的代数改写。对 GDN Chunked Prefill 的前向和反向流程进行一定程度的改写,在不影响数值精度的前提下有效降低了 Tencosr Core、 CUDA Core 及 SFU 开销。
- Tilelang fused warp-specialized kernels。我们没有沿用每步一个独立 kernel 的拆分方式,也没有将整个计算流程融合为一个 kernel,而是考虑序列并行和 backward 的需求,使用 Tilelang 语言构建出几个关键的 fused kernel,并通过手动的 warpgroup specialization 实现数据搬运、Tensor Core 计算与 CUDA Core 计算的重叠。
FlashQLA 代码 和 benchmark 均开源在 github.com/QwenLM/FlashQLA。
FLA GDN Chunked Prefill 面临的主要问题#
首先让我们回顾一下 GDN Chunked Prefill 的前向计算流程,以 chunk idx 为例:
- A_i \gets \left(I+\mathrm{StrictLower}\left( \mathrm{diag}(\beta_i)(\Gamma_i \odot K_iK_i^\intercal) \right)\right)^{-1}\
- \left\{\begin{aligned} W_i &\gets A_i\mathrm{diag}(\beta_i)\mathrm{diag}(\gamma_i)K_i \\ U_i &\gets A_i\mathrm{diag}(\beta_i)V_i \end{aligned}\right.\
- \left\{\begin{aligned} V_i’ &\gets U_i-W_iS_i \\ S_{i+1} &\gets \gamma_{i,C-1}S_i + K_i^\intercal\mathrm{diag}\left(\frac{\gamma_{i,C-1}}{\gamma_i}\right)V_i’ \end{aligned}\right.\
不考虑 gate 的预处理和 CP,该流程的每一步在 FLA 中都对应一个 kernel。该流程在效率上有两个主要的问题:
- 以上大多为 memory-bounded kernel,在流程中需要反复读取 、 等数据,而 、、 作为中间变量也需要写入 HBM 再由下一个 kernel 读取,访存开销较大。
- SSM state 的递推性质导致对应第三步
chunk_gated_delta_rule_fwd_kernel能同时开出的 thread block 数量仅为batch_size * num_heads,在小模型、小 batch 或 TP 场景下 GPU 利用率较低。
这两个问题的解法是相互矛盾的。对于第一个问题,最直观的解法是写一个 fully-fused kernel,所有数据只做一次访存,所有的中间变量也都收到片上,在 batch_size * num_heads 足够大时这一定是最优的。但这样的方案显然会遇到第二个问题,对于一些端侧用小尺寸模型 batch_size=1 的推理场景,或者对于大模型线上部署开 TP 遇到 coding agent 等长序列输入做 chunked prefill 开不出足够大的 batch 的工况,fully-fused kernel 相比于 FLA 原版实现的加速是有限的。
而第二个问题最早的解决方案来源于DeltaNet如何做序列并行,将长序列拆分为多个子序列,使用 并行递推,再计算一个额外的 矩阵用于校正递推结果。这个方案后来被优化为在递推 kernel 前插入一步计算每个子序列的 ,目前已被合并到 FLA 仓库中。对于 CP rank ,其具体的预处理流程为:
- \left\{\begin{aligned} S^\ast_{j,i+1} &\gets \gamma_{j,i,C-1}S^\ast_{j,i} + K_{j,i}^\intercal \mathrm{diag}\left(\frac{\gamma_{j,i,C-1}}{\gamma_{j,i}}\right) V’_{j,i} \\ M_{j,i+1} &\gets \left( \gamma_{j,i,C-1} I -K_{j,i}^\intercal \mathrm{diag}\left(\frac{\gamma_{j,i,C-1}}{\gamma_{j,i}}\right) W_{j,i} \right) M_{j,i} \end{aligned}\right.\
然而这样序列并行的方案也有其弊端:一是引入的额外计算量较大,递推 矩阵的时间复杂度甚至高于 矩阵;二是和 fully-fused kernel 相性不好,因为需要先经过矩阵求逆等步骤才能计算每个子序列的 。
兼顾访存开销与序列并行的解法#
基于上述两个问题,可以得到一个折中的解法:将 GDN Chunked Prefill 前向计算流程拆分为两个 fused kernel,在其中插入 CP 相关的预处理步骤。再经过一些变换和化简,得到如下计算流程:
- A_i \gets \left(I+\mathrm{StrictLower}\left( \mathrm{diag}(\beta_i)K_iK_i^\intercal\right)\right)^{-1}\
- CP Preprocess
- 2.1.
- 2.2. S_{j,0} \gets S^\ast_{j,0} + M_{j,0}S_{j-1,0}\
我们还设计了一个简单的数学模型自动计算并行度。设一个序列上的 chunk 数量为 ,每个 CP rank 上的 chunk 数量为 。易知步骤 2.1 和 3 的运行时间正比于 ,而步骤 2.2 的运行时间正比于 ,因此我们可以取 使得总时间最短,其中 为 batch_size、num_heads 等其他超参数组成的系数。
实际生产中并不总是需要开启卡内序列并行。参考 FLA 原版实现,步骤 3 也可以通过切分 v_head_dim 增加 2-4x 并行度,代价是对 Q 和 K 的冗余访存。根据实测数据,我们仅在 batch_size * num_heads <= 40 和 batch_size * num_heads <= 56 && seq_len >= 8192 这两种情况下开启序列并行。
利用 Gate 衰减性质进一步优化#
回看 GDN 递推公式:
对于 ,每个 对后续状态的影响呈指数衰减,因此具备滑动窗口的性质。对于足够长的窗口尺寸 ,从 开始递推即可获取精确的 ,而不必从 开始递推。我们将这一过程称为 warmup。在真实数据上,我们发现 60-80% 的线性注意力头上 不恒为 1,6~8 个 chunk 的 warmup 就足以将 的误差压低到噪声以下。
由此我们可以针对具备滑窗性质的线性注意力头设计一套更轻量级的 CP preprocess 流程,舍弃对修正量 的计算,直接通过 warmup 获得同样精确的子序列 :
| C0 | C1 | C2 | C3 | C4 | C5 | C6 | C7 | C8 | C9 | C10 | C11 | C12 | |
|---|---|---|---|---|---|---|---|---|---|---|---|---|---|
| R1 | O | O | O | O | O | ||||||||
| R2 | X | X | O | O | O | O | |||||||
| R3 | X | X | O | O | O | O |
X 表示用零初始状态做 warmup 直到 gate 衰减到足够小之后写出该 CP rank 的 ,O 表示后续正常的递推计算。每个 rank 的 warmup 长度由一个独立的 kernel 通过统计 gate 决定,该步骤的耗时是可以忽略的。
Tilelang Warp-Specialized Kernel#
我们基于 TileLang,采用 warpgroup specialization 的方式实现:同一个 SM 内包含一个生产者 warpgroup 和三个消费者 warpgroup,通过 shared memory 交换数据,并通过 mbarrier 同步。
前向#
在前向流程中,我们让三个消费者 warpgroup 分别计算 、 和 ,并通过 ping-pong 结构遮盖计算与访存。
| WG3 | WG2 | WG1 | WG0 | |
|---|---|---|---|---|
| WG3/0 | WG3/1 | WG3/2 | ||
| BAR 0 | LD | LD | ST | |
| BAR 1 | LD | LD | ST | TC |
| BAR 2 | LD | TC | ||
| BAR 3 | LD | TC | ||
| BAR 4 | TC | |||
| BAR 5 | TC |
注意:
- 每个 chunk 上输出 仅作 debug 用,一般只输出 和最后一个 chunk 的 。
序列并行预处理#
刚才说到序列并行的预处理分为原始做法(计算 和 )和滑动窗口(仅计算 )两种情况。我们设计了一个 fused kernel 可以同时处理这两种情况:
| WG3 | WG2 | WG1 | WG0 | |
|---|---|---|---|---|
| WG3/0 | WG3/1 | WG3/2 | ||
| BAR 0 | LD | LD | ||
| BAR 1 | LD | LD | ST | TC |
| BAR 2 | LD | |||
| BAR 3 | TC TC | TC TC |
注意:
- WG1 和 WG2 的最后两步为计算 矩阵的过程,仅在需要时触发。
- 仅反向重算时在每个 chunk 上输出 。
反向#
在反向流程中,我们可以直接套用上一节的序列并行预处理 kernel 重算 矩阵;之后把 bwd_dv bwd_dhu bwd_dqkwg bwd_wy 融合到一个 kernel 里,并作相应的代数优化。受片上资源限制,反向 kernel 不设置 multi-stage,而是利用长计算流程遮盖访存。完整的流水线可以在 FlashQLA 仓库 中查看。
| WG3 | WG2 | WG1 | WG0 | |
|---|---|---|---|---|
| BAR 00 | ST | TC | ||
| BAR 01 | TC | |||
| BAR 02 | TC | |||
| BAR 03 | TC | |||
| BAR 04 | TC | |||
| BAR 05 | ST | LD | TC TC | |
| BAR 06 | TC | |||
| BAR 07 | LD | TC | ||
| BAR 08 | TC | |||
| BAR 09 | LD | TC | ||
| BAR 10 | LD | TC | ||
| BAR 11 | ST | |||
| BAR 12 | TC | |||
| BAR 13 | TC TC | |||
| BAR 14 | LD LD | |||
| BAR 15 | TC |
Benchmark#
我们在 Qwen3.5 / Qwen3.6 系列的 head 配置上 —— h_v ∈ {64, 48, 32, 24, 16, 8},对应 TP1 至 TP8 —— 与 FLA Triton and FlashInfer baseline(FLA 0.5.0,Triton 3.5.1, FlashInfer 0.6.9, TileLang 0.1.8)做了全面对比。
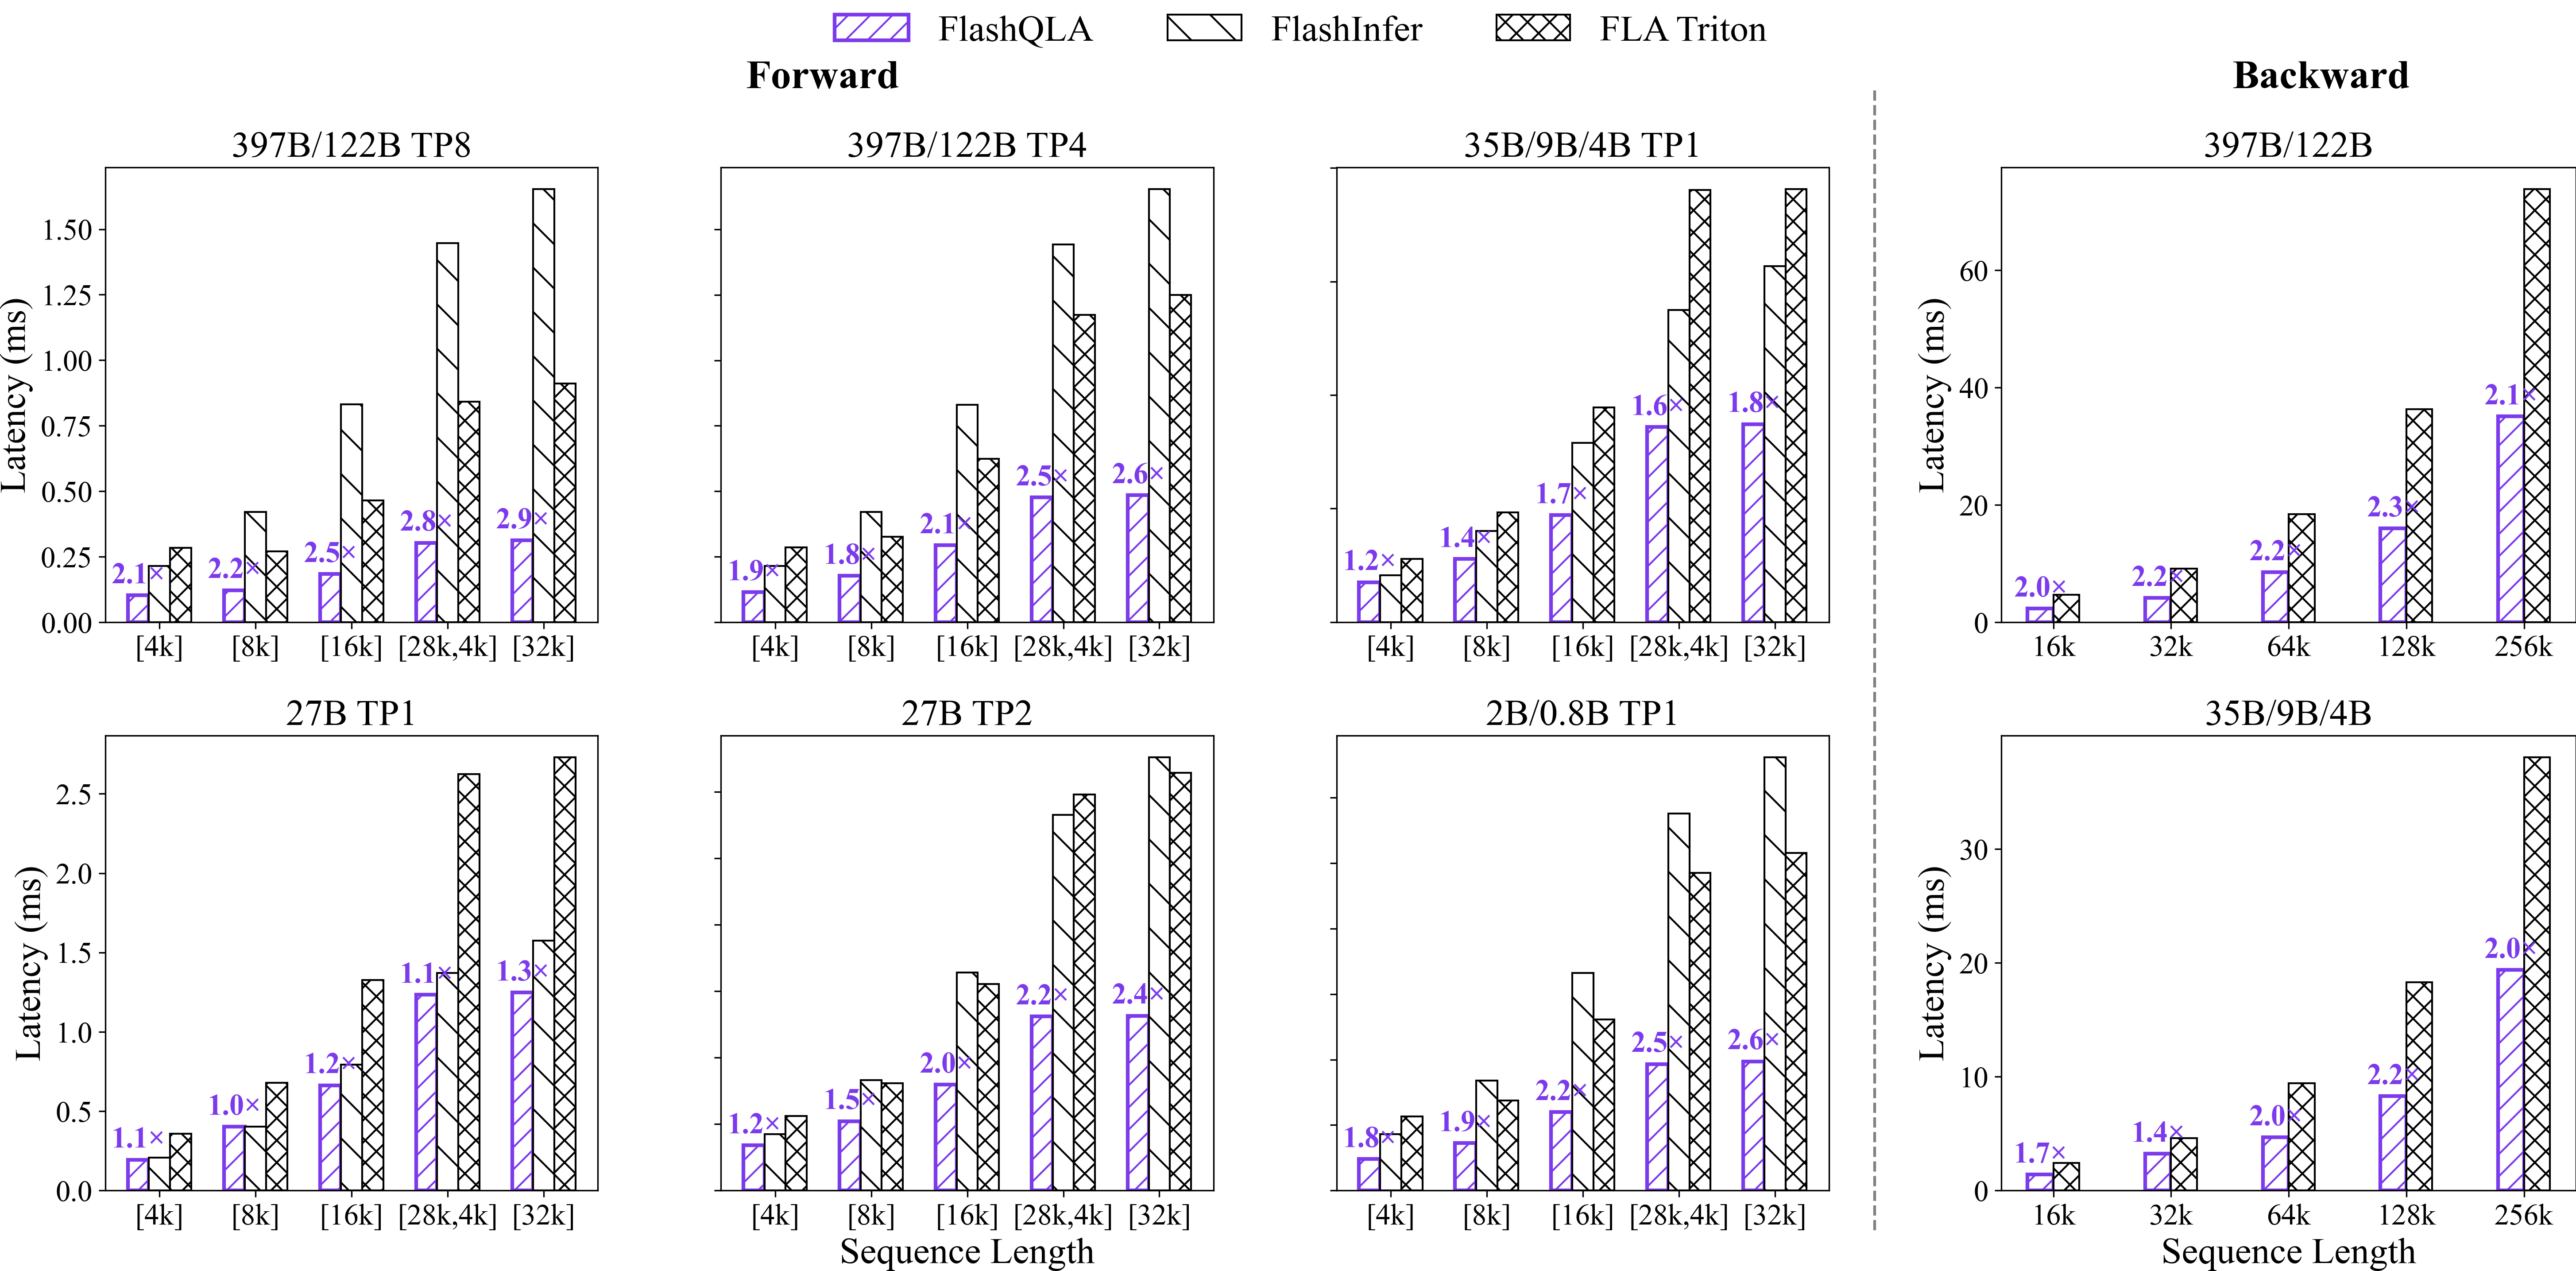
其中FWD 中测试了不同模型、TP setting下对于不同batch 长度下单Kernel latency,BWD中测试了单次更新中batch内不同总token number与latency的关系。
部分 H200 单层前向结果:
| 模型 / TP | Seqlen | FlashQLA | FlashInfer | FLA | vs FLA | vs FI | ||
|---|---|---|---|---|---|---|---|---|
| 397B/122B TP8 | 1x32768 | 2 | 8 | 0.310ms | 1.653ms | 0.913ms | 2.95× | 5.33× |
| 397B/122B TP8 | 1x16384 | 2 | 8 | 0.184ms | 0.833ms | 0.465ms | 2.53× | 4.53× |
| 397B/122B TP8 | 24576+8192 | 2 | 8 | 0.302ms | 1.242ms | 0.767ms | 2.54× | 4.11× |
| 397B/122B TP4 | 1x32768 | 4 | 16 | 0.486ms | 1.654ms | 1.250ms | 2.57× | 3.40× |
| 397B/122B TP4 | 1x16384 | 4 | 16 | 0.292ms | 0.832ms | 0.623ms | 2.13× | 2.85× |
| 27B TP2 | 1x32768 | 8 | 24 | 0.659ms | 1.616ms | 1.564ms | 2.37× | 2.45× |
| 2B/0.8B TP1 | 1x32768 | 16 | 16 | 0.493ms | 1.640ms | 1.285ms | 2.60× | 3.33× |
| Sym h32 | 1x32768 | 32 | 32 | 0.877ms | 1.554ms | 1.952ms | 2.23× | 1.77× |
加速比随 TP 增大而提升,这是因为 FlashQLA 能够通过卡内的 AutoCP 提高TP,小 num_heads 等场景下 SM 利用率。
使用方式#
FlashQLA 同时提供了对齐 FLA 签名的 high-level API 与底层 fwd / bwd 入口:
import torch
from qla import chunk_gated_delta_rule

o, final_state = chunk_gated_delta_rule(
    q=q,                            # [B, T, H_q, K]
    k=k,                            # [B, T, H_q, K]
    v=v,                            # [B, T, H_v, V]
    g=g,                            # [B, T, H_v]
    beta=beta,                      # [B, T, H_v]
    scale=scale,
    initial_state=initial_state,    # 可选, [B, H_v, K, V]
    output_final_state=True,
    cu_seqlens=cu_seqlens,          # 可选, varlen 支持
)
环境要求:SM90,CUDA 12.8+,PyTorch 2.8+。安装:
git clone https://github.com/QwenLM/FlashQLA.git
cd FlashQLA && pip install -v .感谢#
FlashQLA 的实现受到 Flash Linear Attention,FlashInfer 与 TileLang 的启发,感谢社区的参考实现。
引用#
如果 FlashQLA 对你的研究有所帮助,欢迎引用:
@misc{flashqla2026,
    title  = {FlashQLA: Flash Qwen Linear Attention},
    author = {Zhang, Chengruidong and Lin, Xi and Jiang, Huiqiang and Wang, Zekun and
              Li, Xiao and Cao, Yizhong and Zhuang, Bohan and Men, Rui and Zhang, Jianwei and
              Zheng, Bo and Lin, Junyang and Liu, Dayiheng and Zhou, Jingren},
    year   = {2026},
    publisher = {GitHub},
    howpublished = {\url{https://github.com/QwenLM/FlashQLA}}
}