OpenAI 发布 GPT-6 Sol/Luna:成本减半且智能持平,重塑推理性价比前沿
OpenAI 正式推出 GPT-6 Sol 和 Luna 模型,在保持与上一代 GPT-5.6 相当的综合智能水平下,将 API 定价降低约 50%。新模型通过优化推理效率,显著降低了单次任务成本(Sol 每任务成本降至 $1.06),进一步巩固了其在成本效益帕累托前沿的领先地位。尽管编码代理性能在部分评估中出现分化(Sol 提升但 Luna 回退),但整体性价比的大幅跃升使其成为开发者部署高负载应用的关键选择。
报道正文
GPT-6 Sol 和 Luna 将成本效率前沿推进了一大步,相比 GPT-5.6 Sol 和 Luna 成本减半。智能指数(Intelligence Index)和编码代理指数(Coding Agent Index)得分与 GPT-5.6 持平,部分评估有所进步,部分则出现退步**
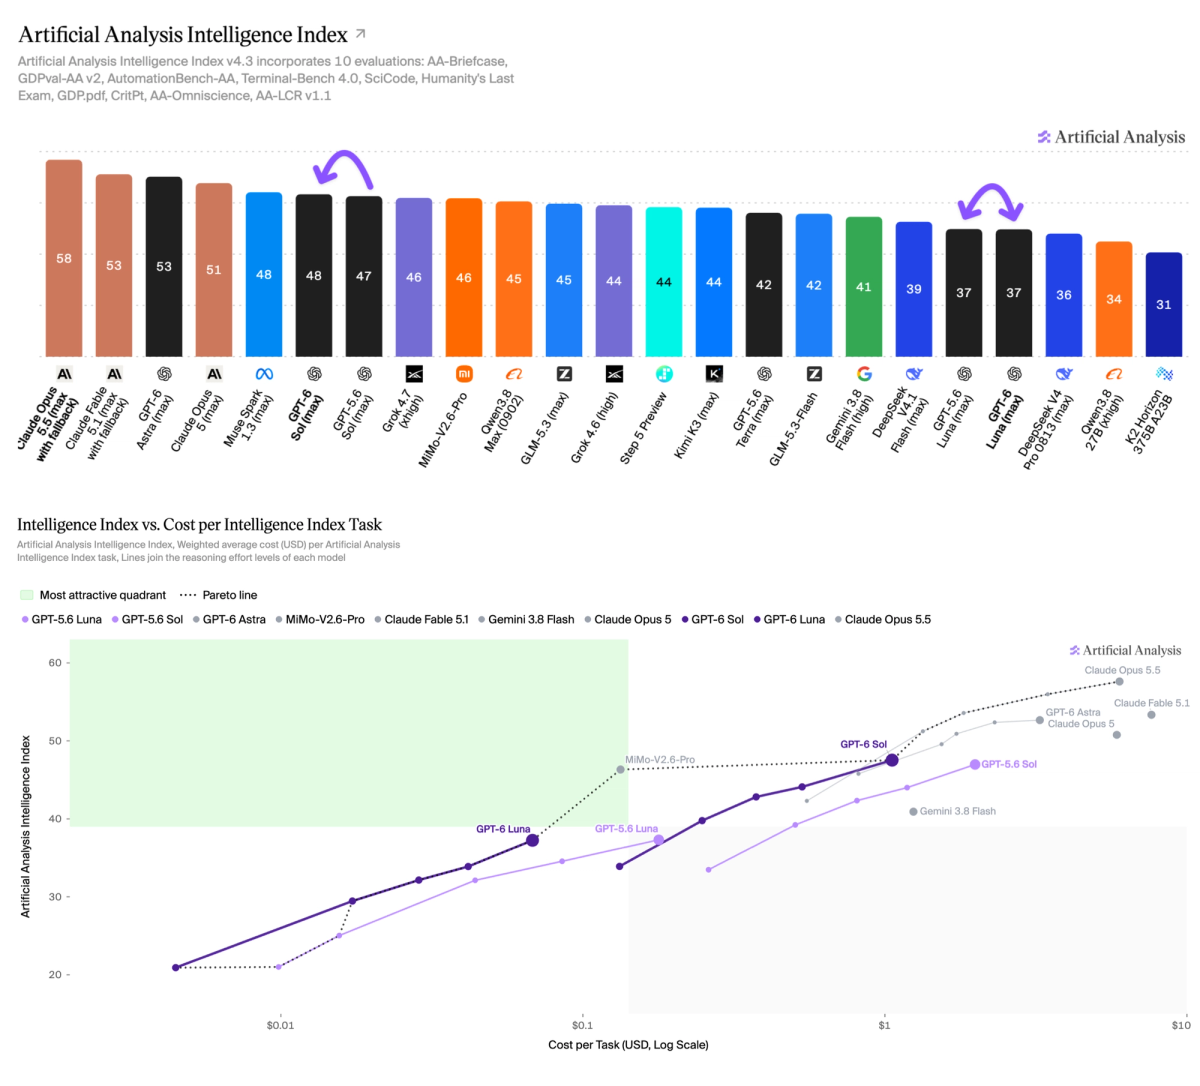
定价约为 GPT-5.6 的一半:Sol 的每百万输入/输出 token 价格从 20 降至 10,Luna 从 1.20 降至 0.50,缓存读取仍享受 90% 折扣,缓存写入仍收取 25% 溢价。
关键要点:
➤ 单任务成本减半: 运行 Artificial Analysis 智能指数时,GPT-6 Sol (max) 的单任务成本为 $1.06,比 GPT-5.6 Sol (max) 的 $1.99 低约 50%。GPT-6 Luna (max) 的单任务成本为 $0.07,比 GPT-5.6 Luna (max) 的 $0.18 低约 60%。这一优势主要源于降价,因为两款模型在单任务中使用的输出 token 数量略有增加(Sol 为 31k vs 29k,Luna 为 51k vs 41k)。这两次发布使 OpenAI 能够占据成本效率帕累托前沿(Pareto frontier)的显著份额。
➤ 在编码代理指数中,Sol 表现提升但 Luna 出现退步: 在 OpenAI 的 Codex 测试框架下,GPT-6 Sol (max) 在 Artificial Analysis 编码代理指数中得分为 57,较 GPT-5.6 Sol (max) 提升 2 分,其中在 Terminal-Bench 4.0(43% vs 37%)和 SWE-Atlas-QnA(58% vs 54%)上均有增益。其单任务成本为 $2.99,比 GPT-5.6 Sol (max) 低约 50%,位于“编码代理指数 vs 单任务成本”的帕累托前沿上。GPT-6 Luna (max) 得分为 41,较 GPT-5.6 Luna (max) 下降 2 分,在 SWE-Atlas-QnA(44% vs 49%)和 DeepSWE v1.1(64% vs 66%)上的得分较低,尽管其单任务成本低了约 60%。
➤ 幻觉率显著降低: 在我们的知识与幻觉基准测试 AA-Omniscience 中,两款模型的幻觉现象均有所减少。GPT-6 Sol (max) 的幻觉率从 92% 降至 60%,GPT-6 Luna (max) 从 93% 降至 77%。Sol 通过更频繁地拒绝回答来实现这一点:它尝试回答的问题比例为 83%,而 GPT-5.6 Sol (max) 为 99%,这使得错误答案减少了约四分之一,但也导致准确率下降了 5 个百分点,从 59% 降至 54%。Luna 的准确率基本保持不变(44% vs 43%),同时回答的问题数量也减少了。在 AA-Omniscience 指数上,Sol 从 22 提升至 27,Luna 从 -10 提升至 1。
➤ 评测表现有升有降: 除 AA-Omniscience 外,两款模型在 AutomationBench-AA(Sol 62% vs 60%,Luna 53% vs 50%)和 Terminal-Bench 4.0(Sol 44% vs 40%,Luna 13% vs 12%)上均有提升。然而,我们在两项关键的知识工作评测中观察到了性能回退。在 GDPval-AA v2.1(我们基于 OpenAI 涵盖 44 种职业的经济价值任务数据集改编的基准测试)中,Sol 下降了约 100 Elo 分,Luna 下降了约 75 分。此外,Luna 在 AA-Briefcase v1.1 中也下降了约 45 Elo 分,而 Sol 保持持平。AA-Briefcase v1.1 是一项针对多周知识工作项目的私有评测,涉及数千个输入文件。我们的团队人工检查了数百份模型输出:性能回退主要源于呈现质量下降以及交付物遗漏评分标准要素。
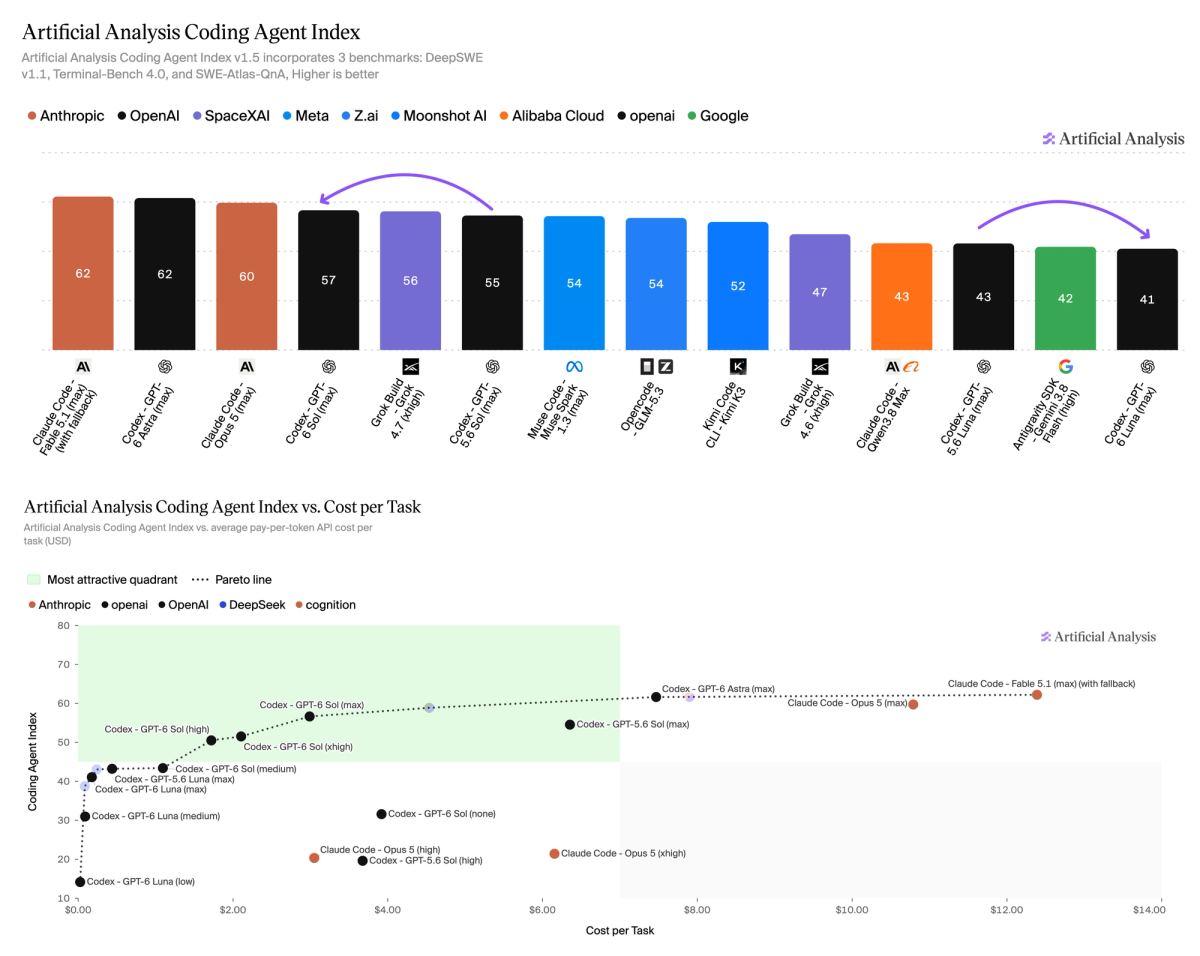
GPT-6 Sol (max) 在 Artificial Analysis Coding Agent Index 中提升了 2 分,且单任务成本仅为前代的一半;而 GPT-6 Luna (max) 则回退了 2 分。
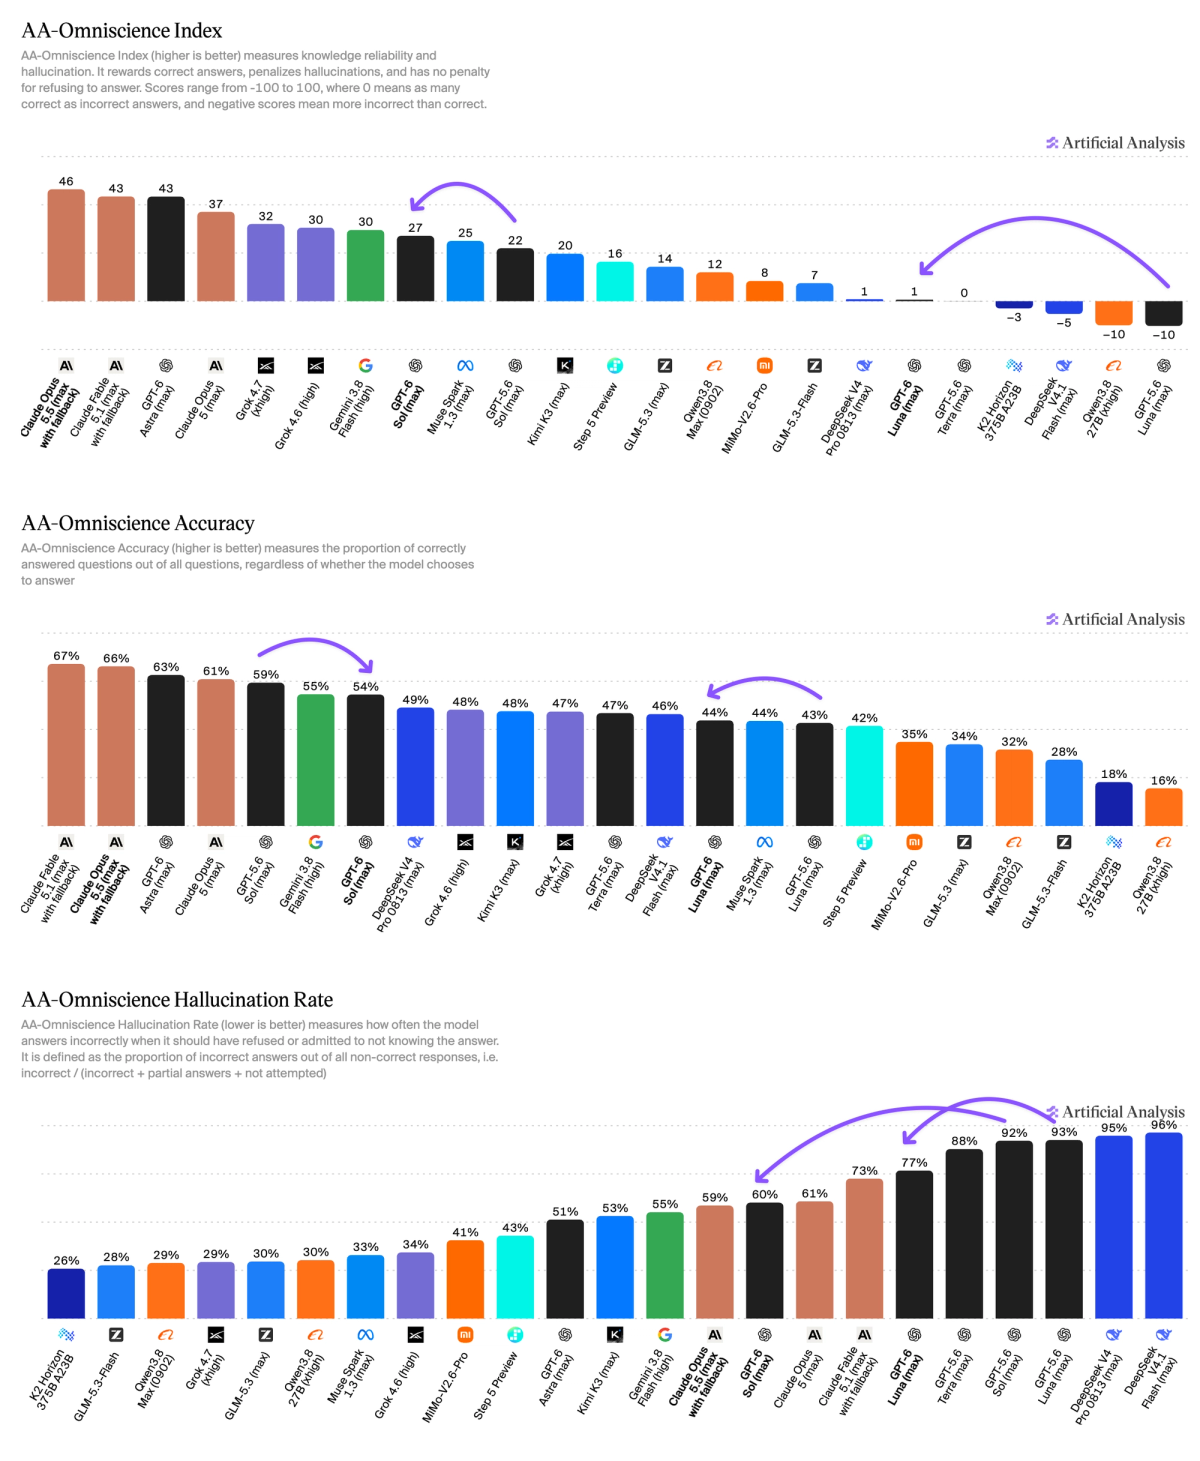
在最大努力模式下,GPT-6 Sol 和 Luna 的幻觉率均低于其前代模型。
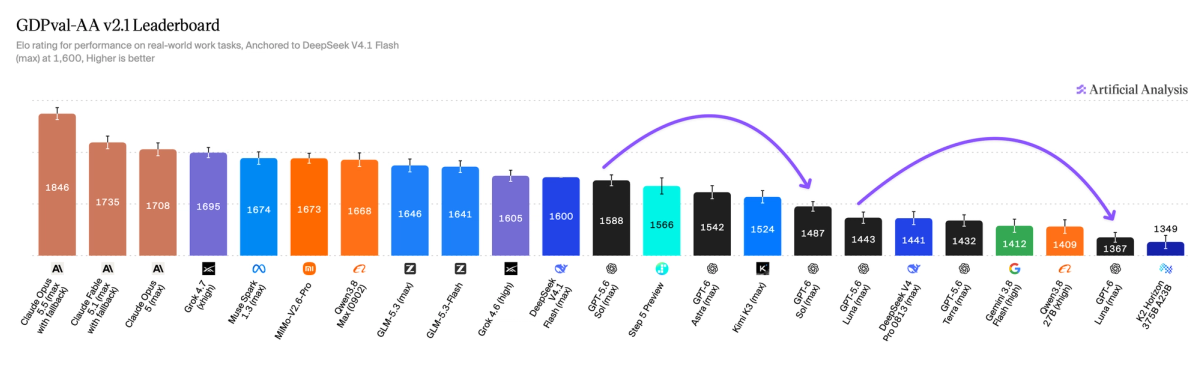
在最大努力模式下,两款模型在 GDPval-AA v2.1 中均出现回退,主要原因是交付物变短,更频繁地遗漏必需元素。
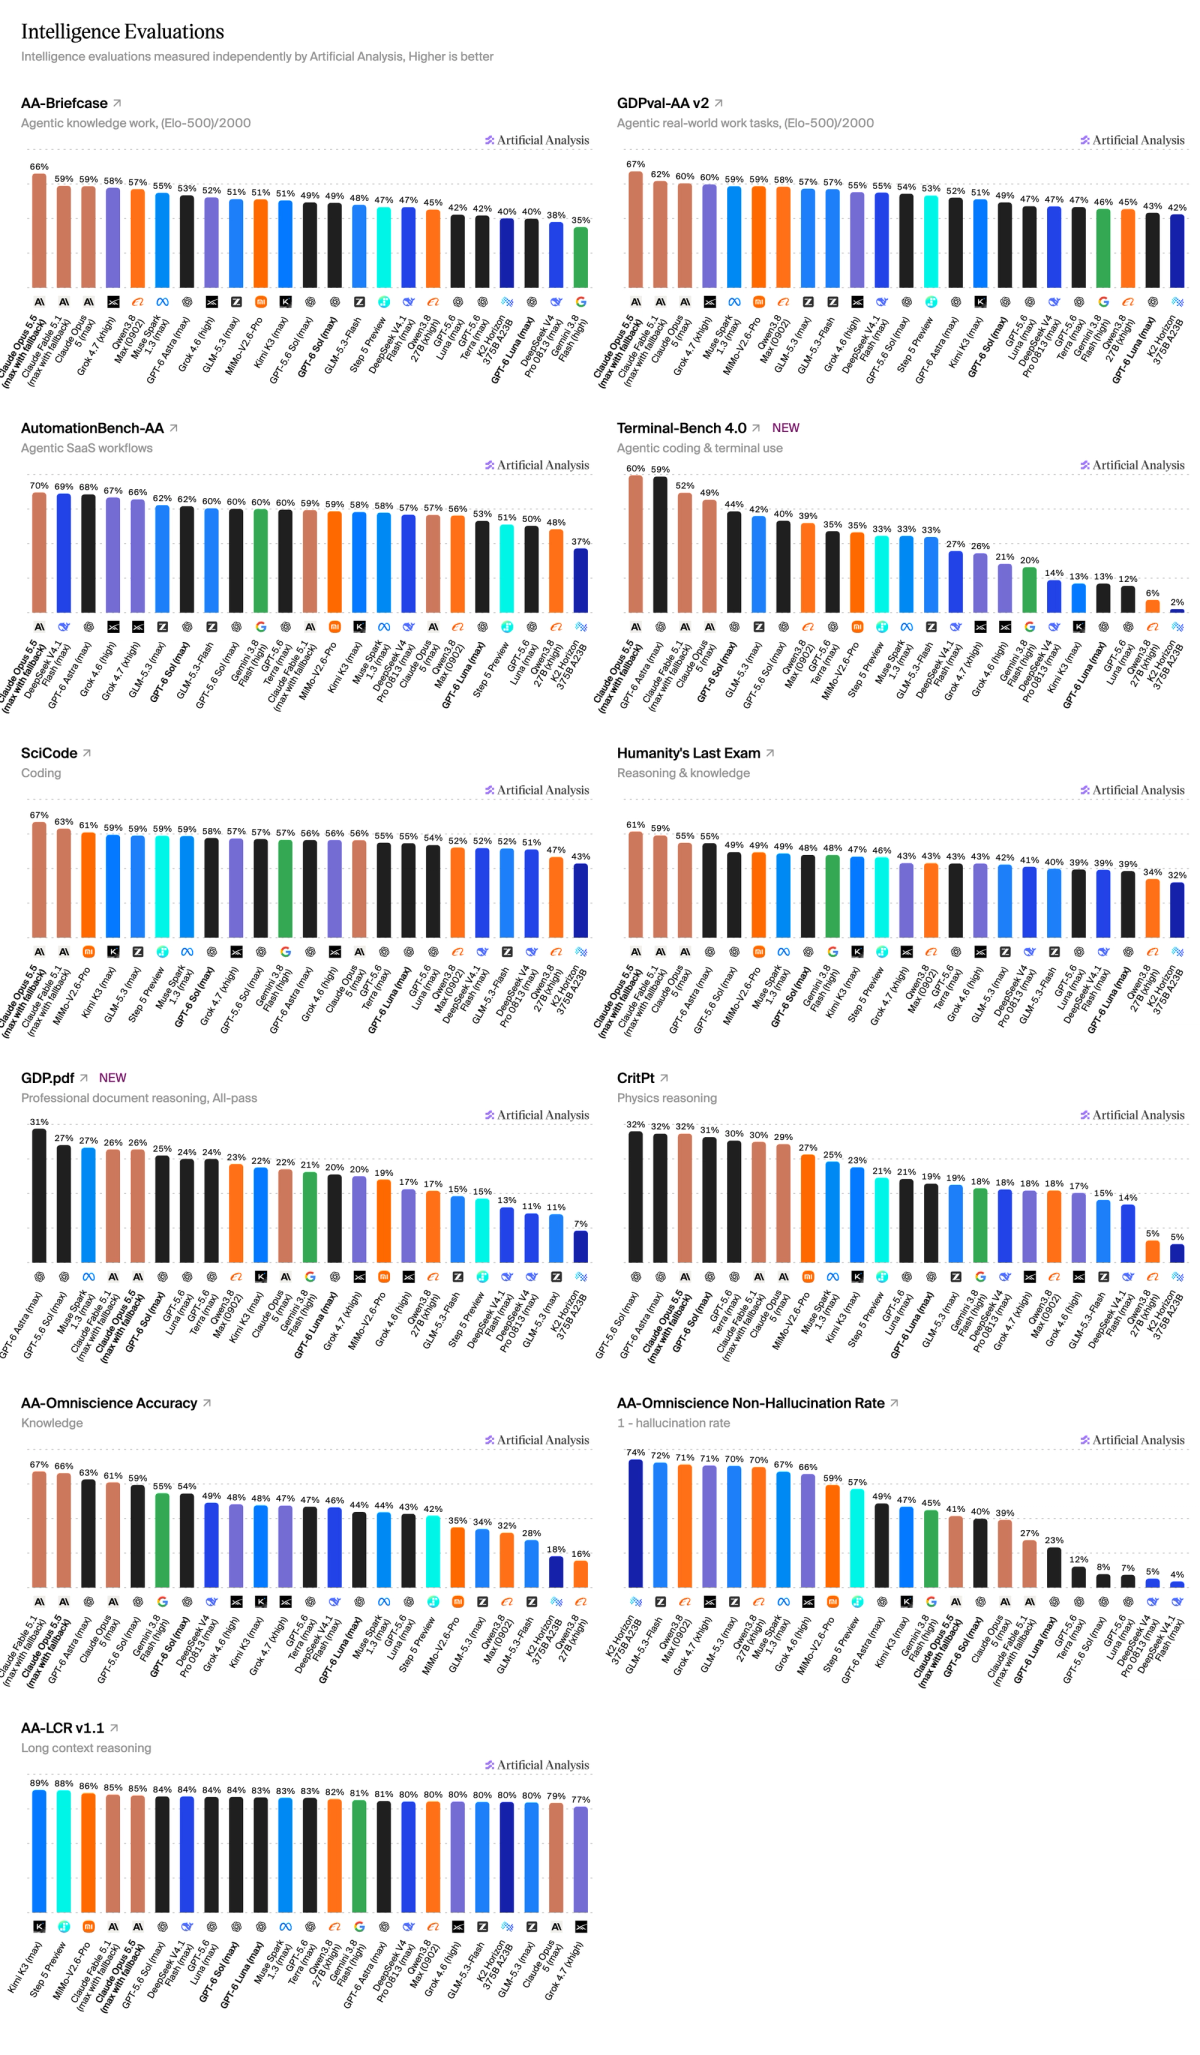
Artificial Analysis Intelligence Index v4.3 中各项细分评测的拆解分析
访问 www.artificialanalysis.ai,将 GPT-6 Sol 和 Luna 与其他领先模型进行对比