InfoQ 中文 · 2026/10/18 23:31:34
Meta 开源 8160 亿参数 Muse Spark,主打长程智能体但编码弱于国产模型
Meta 发布迄今最强美国开源权重模型 Muse Spark Open,采用稀疏 MoE 架构支持百万上下文与多模态输入,专为长程智能体任务设计。该模型需双 M5 Ultra Mac Studio 本地部署,虽在工具调用与失败恢复上表现突出,但在编程基准测试中落后于智谱、Kimi 等竞品。
报道全文原始报道全文
本文目录4 个章节
Meta 开源 Muse Spark Open 模型,8160 亿参数稀疏 MoE 架构,支持百万级上下文与多模态输入(文本/图/音/视),专为长程智能体任务设计,需双 M5 Ultra Mac Studio 本地部署。
支持跨模态理解但无原生生成能力;端到端工具调用与失败恢复是核心智能体能力;编程基准弱于智谱、Kimi 等竞品。
适合 AI 架构师、智能体系统工程师、边缘大模型部署工程师阅读。
Meta 将大型智能体模型带到了桌面设备上,但这次的“桌面”,需要两台高配置 Mac Studio。
当地时间 10 月 15 日,Meta 宣布开放 Muse Spark Open 模型权重,将软件工程、长程任务执行和多步推理作为主要应用方向。与模型权重一同受到关注的,是其本地运行方案:通过 MLX 框架,开发者可以在两台搭载 M5 Ultra 的 Mac Studio 上部署这一模型。
Meta 将其定位为迄今能力最强的美国开放权重模型。
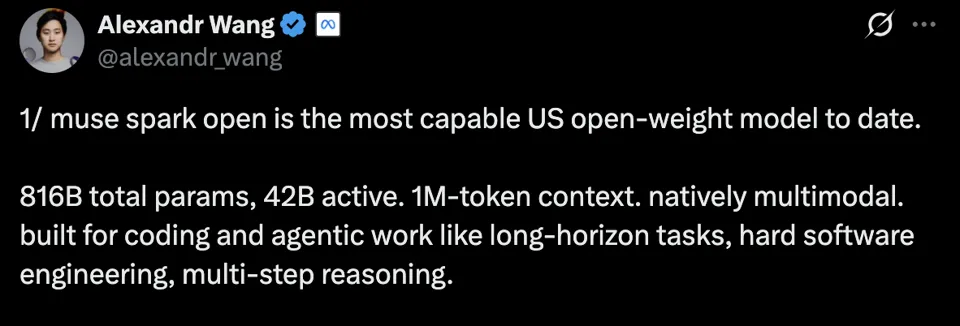
Muse Spark Open 采用稀疏混合专家架构,总参数量达到 8160 亿,每个 token 激活约 420 亿参数,支持 1,048,576 token 上下文。模型可以接收文本、图片、音频和视频,输出则为文本。因此,它能够理解截图、视频和录音,但不能据此理解为具备原生图片、音频或视频生成能力。
这套能力组合指向的是需要持续操作的工作流程。模型不仅要理解用户意图,还要规划步骤、调用工具、检查执行结果,并在工具失败后调整行动。
编程基准测试输给了智谱、Kimi
Meta 的模型卡将端到端智能体任务、代码编写与调试、长程工具调用列为主要用途,同时也包括合成数据生成和模型输出评估。
在官方演示中,Meta 使用由 Muse Spark Open 驱动的 Muse Code,在本地完成了开源 Mastodon 客户端 Ice Cubes 的 iOS 开发工作,涉及修复问题、添加功能和完整构建。
另一项演示则让模型操作 DaVinci Resolve,逐帧检查素材,挑选片段并进行竖屏裁剪。这些案例展示了模型连接真实软件的方向,但仍属于官方展示,不能直接推导为所有同类任务均可无人值守完成。
性能方面,Meta 公布的结果显示,Muse Spark Open 在 JobBench 上得分为 61.8,MCP-Atlas 为 89.2,OSWorld Verified 为 80.4;编程相关测试中,Terminal-Bench 2.1 为 76.4,DeepSWE 1.1 为 60。
值得一提的是,在 Terminal-Bench 2.1 和 DeepSWE 1.1 测试中,Muse Spark Open 得分低于国产开源模型 GLM 5.3 max 和 Kimi K3 max。
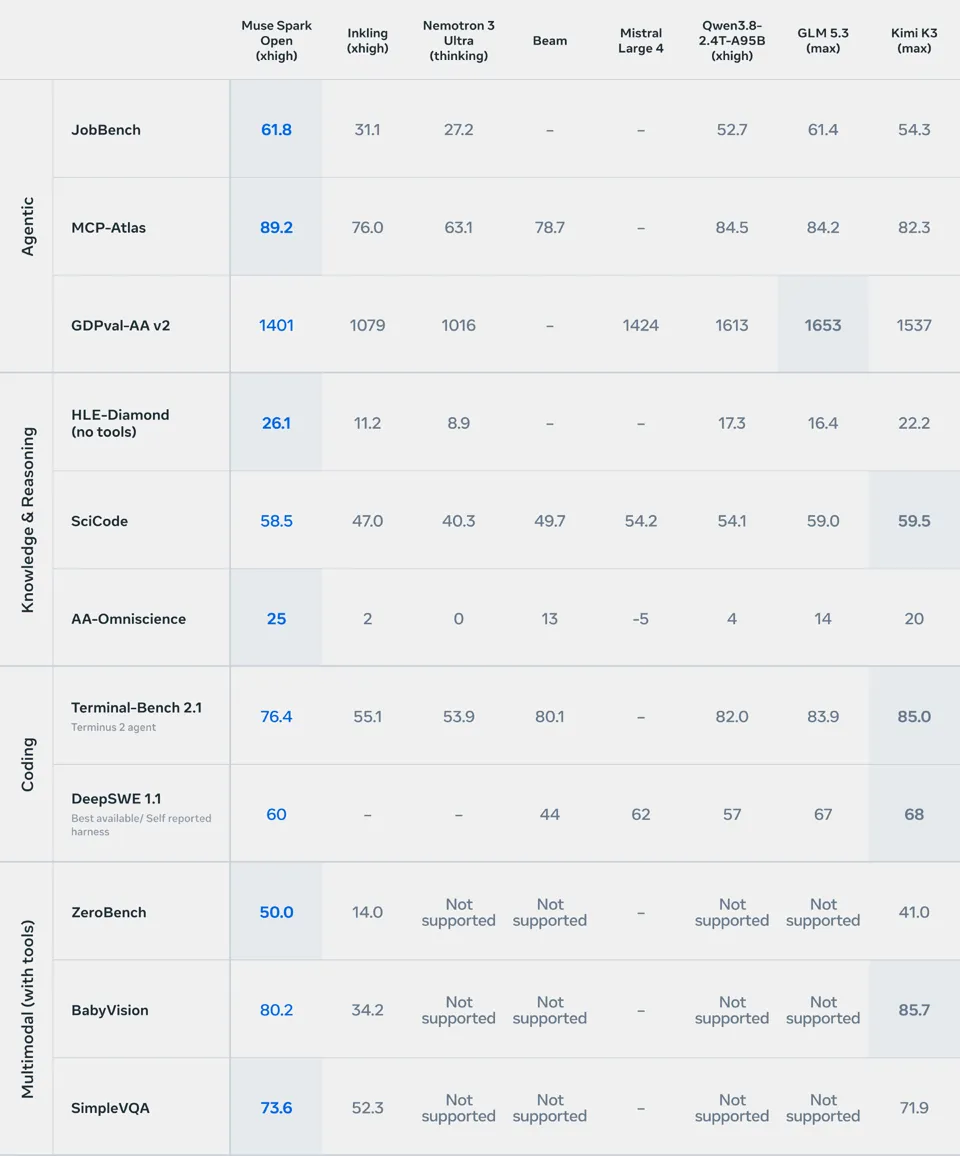
客观来讲,以上结果也没有呈现出所有项目全面领先的局面。
本地部署是模型最大亮点
本地部署是此次发布的一项重要看点,不过,420 亿激活参数并不意味着只需要容纳一个 420 亿参数模型的内存。稀疏架构减少了每个 token 参与计算的参数量,完整权重仍需加载。按照官方文档,BF16 版本权重约为 1.65 TB,NVFP4 版本约为 537 GB,此外还要为 KV Cache、激活值和运行时开销预留空间。
官方给出的 GPU 部署示例中,BF16 版本使用 8 张 B300,NVFP4 版本使用 4 张 B300。具体配置还取决于加速器内存、互联条件、上下文长度和并行策略。
这里不得不提一嘴,“可以本地运行”意味着开发者获得了控制部署位置的选择,并不意味着普通笔记本已经能够承担这类模型。
苹果公布的相关研究还展示了四台 Mac Studio 的分布式推理结果:Muse Spark Open 的生成速度超过每秒 36 个 token。
对于不准备自建硬件的团队,Muse Spark Open 也提供托管访问路径。官方列出的生态伙伴包括 Baseten、Fireworks AI、Groq、Modal、Nebius、Together AI 和 OpenRouter;部署工具覆盖 SGLang、vLLM、TensorRT-LLM、llama.cpp 和 MLX 等。开发者可以先通过 API 验证任务效果,再评估是否值得自行部署。
另一个需要注意的点是,Muse Spark Open 采用 Muse Model License,开放权重并不等于没有商业使用条件。许可证允许在满足条款的前提下使用、修改、微调、蒸馏和分发模型,并要求相关产品或文档展示指定归属标识。
其中,对通过 API 等方式提供模型即服务的企业,如果被许可方及其关联方在任意连续 12 个月内的合计总收入超过 2000 万美元,条款要求其在将模型或衍生模型用于该业务前通知 Meta,并签订单独书面协议。
这一规定同时列有例外,包括内部使用、研究、非模型即服务商业活动,以及用模型支持自有非模型即服务产品的功能,不能简单概括为“所有年收入超过 2000 万美元的企业都要付费”。
从这次发布可以看到,大型开放权重模型的竞争正在延伸到实际部署环节:模型能否完成持续的软件操作,能否接入现有工具,开发者又需要付出多少硬件与运维成本,正变得与参数和榜单成绩同样重要。
Muse Spark Open 增加了本地运行大型智能体模型的可能性,但从“下载得到”走向“稳定用得起”,仍需要真实工作负载下的验证。
模型发布后,在国外社区中引发热议,各平台用户对这次发布的评价不一。
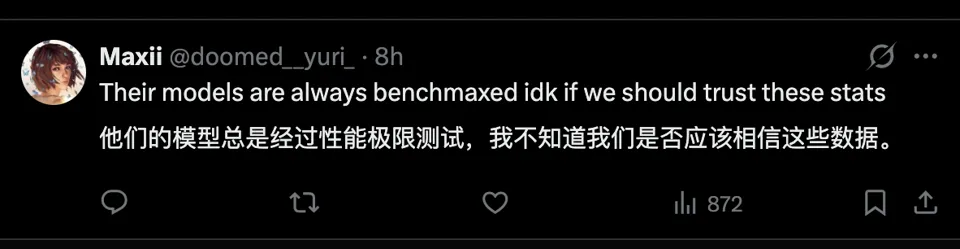
有网友对基准成绩持保留态度:“他们的模型总是针对榜单做极致优化,我不知道该不该相信这些数据。”
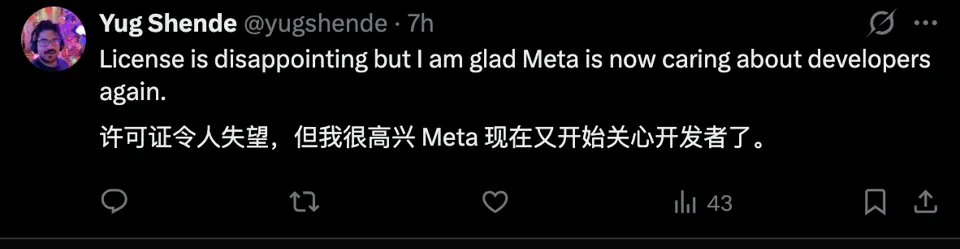
也有人认可 Meta 再次开放模型权重,但对使用条款不满:“许可证令人失望,但我很高兴 Meta 又开始关心开发者了。”
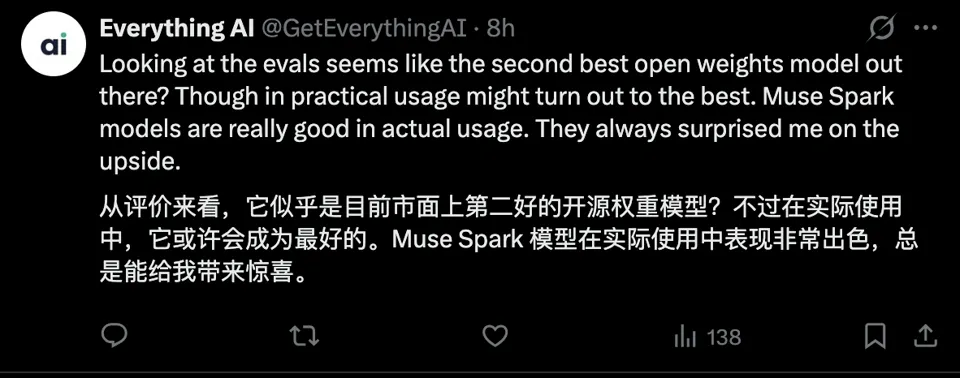
另一些用户更看重实际体验。一位网友认为,Muse Spark Open 从评测来看“似乎是目前第二好的开放权重模型”,但实际使用中可能更有竞争力:“Muse Spark 系列在实际使用中表现非常出色,总能给我带来惊喜。”
还有用户分享了 Muse 系列其他模型 与 Gemini 4 Argon 的对比,想要验证该系列模型和谷歌模型谁更强。他称,在相同提示词、各自最高可用推理设置下,Muse 耗时约 40 分钟、花费约 30 美元,Argon 则耗时约 30 分钟、花费约 10 美元。对于这次 3D 任务的结果,他评价:“Muse 确实让我惊喜……不过我觉得 Argon 稍微好一些。”
8160 亿参数如何搬上桌面:Muse Spark Open 的技术逻辑
Muse Spark Open 发布后,在 Youtube 上,有博主分析了 Muse Spark Open 实现桌面部署背后的技术逻辑。
将一个拥有 8160 亿参数的模型放到本地运行,首先面对的是物理约束:模型权重放在哪里,计算单元如何读取这些权重,以及多台机器之间如何交换数据。Muse Spark Open 的桌面部署,需要模型架构、数值精度、内存系统和推理框架共同配合。
其中,最容易混淆的两个数字是总参数量与激活参数量。Muse Spark Open 拥有 8160 亿总参数,但每个 token 激活的参数约为 420 亿。前者很大程度上决定权重存储需求,后者则影响每个 token 的计算负担。两者分别对应“装不装得下”和“算不算得动”,不能互相替代。
模型采用稀疏混合专家架构。在典型 MoE 层中,路由网络根据 token 当前的隐藏表示,为不同专家计算路由分数,再将计算分配给选中的少数专家,最后汇合结果。这让模型不必在处理每个 token 时都调用全部专家。
视频中,博主将这一机制比作图书管理员:回答一个问题时,不必翻遍整个图书馆,只需要取出相关书籍。稀疏架构减少了参与运算的参数,却没有消除全部权重的存储需求。不同 token 可能调用不同专家,系统仍需让这些专家权重能够被访问。因此,不能因为模型只激活约 420 亿参数,就按照一个 420 亿参数稠密模型估算内存需求。官方文档也明确区分了这两个概念。
该博主把桌面部署的主要原因归结为 MoE,实际上,量化也是不可忽略的一环。
按每个参数约占两个字节粗略计算,8160 亿参数仅 BF16 权重就需要约 1.63TB,尚未包括推理期间的额外内存。两台各配备 512GB 内存的设备,无法直接容纳这一精度下的完整模型及其运行开销。
苹果公布的 Muse Spark Open 测试采用 NVFP4 精度,而非 BF16。降低权重精度缩小了模型的内存占用,多机并行进一步分担权重和计算负载,才使这种桌面部署成为可能。
所以,在此基础上更完整的技术解释是:MoE 减少每个 token 的活跃计算,量化降低权重存储开销,多台机器提供所需的总内存容量,推理框架则负责协调分布式执行。任何一项都不能单独解释全部结果。
视频着重介绍了 Apple Silicon 的统一内存架构。其重要特点是 CPU 与 GPU 可以访问同一物理内存池,减少某些工作流程中在系统内存与独立显存之间复制数据的需要,同时让集成 GPU 能够利用较大的内存容量。
但统一内存也不意味着内存瓶颈消失。计算单元仍需要读取权重和中间数据,实际速度依然受内存带宽、访问方式、缓存命中和计算效率影响。苹果公布的 M5 Ultra 统一内存带宽为 1.2TB/s,但这是单机内存系统的指标,不能视为两台 Mac 之间的通信带宽。
同样,两台各有 512GB 内存的 Mac,并不会仅仅因为连接起来,就变成一台拥有约 1TB、所有内存都能以相同速度访问的计算机。分布式运行需要将模型或计算划分到不同设备,再通过通信机制交换必要的数据。苹果的方案使用 Thunderbolt 上的 RDMA,并由 MLX 提供相应的集合通信支持。
这意味着,本地大模型部署既有容量问题,也有通信问题。机器数量增加后,即使模型能够装下,跨设备同步和数据交换仍可能限制扩展收益。
算子加速接近四倍,不等于整套推理接近四倍
视频后半段介绍了另一个值得保留的技术点:权重开放之后,推理实现仍决定开发者能否高效使用模型。
Meta 在发布中介绍了集成于 SGLang 的定制 Helion GPU 算子,并称其在 NVIDIA 和 AMD GPU 上实现了 1.03—3.95 倍的算子级加速,在 AMD MI350 上实现约 3% 的端到端加速。这里必须保留“算子级”和“端到端”的区别。
GPU 算子负责执行某一类具体计算,其性能与数据分块、线程组织、内存访问和硬件资源使用有关。自动调优通过测试不同配置,为目标设备和输入选择更合适的实现。它并不意味着每次生成 token 都重新探索最佳配置;Helion 支持缓存调优结果,也提供提前调优的工作流程。
局部算子即使明显加速,对整体性能的影响仍取决于它原本占用了多少运行时间。其他算子、内存访问和跨设备通信没有同步改善,整体收益就会受到限制。所以这组数字真正说明的是底层优化能够带来实际收益,而不是模型在所有硬件上都能获得接近四倍的推理速度。
视频最后讨论了开放权重的安全问题。其核心判断可以保留:托管 API 的提供方能够部署输入输出检查、访问控制和监测机制;模型权重交给开发者后,这些外部措施不会自动随模型一起生效。
Meta 表示,Muse Spark Open 针对开放权重发布进行了额外安全后训练,并通过了其发布框架要求的评估。但这不能进一步解释为安全机制已经永久嵌入模型、无法改变,或者本地部署天然安全。
对于能够读取文件、执行命令和调用软件的智能体,实际风险仍取决于工具权限、运行环境和操作范围。数据留在本地,可以减少向外部推理服务传输的需求;但本地模型一旦获得过大的操作权限,同样可能造成错误修改或数据损失。
参考链接:
https://huggingface.co/meta-models/Muse-Spark-Open-816B-A42B
https://www.youtube.com/watch?v=-eG-hbmqcZg
https://research.meta.ai/static/muse-spark-open-evaluation-methodology