Nvidia 开源 Nemotron 3.5 Transcribe 支持多语言语音转写与翻译
Nvidia 发布开源语音模型 Nemotron 3.5 Transcribe,集成转录、翻译及说话人识别功能,支持 40 种语言。该模型采用 MoE 架构(总参数 30B,激活 4B),可在单 GPU 上运行并在多项基准测试中表现优异。同时发布的还有包含 84.4 万小时音频的 Granary v2 数据集及领域适配工具。
报道正文
本文目录5 个章节
Nvidia 开源 Nemotron 3.5 Transcribe:集转录、翻译与说话人识别于一体
[Jonathan Kemper](https://the-decoder.com/author/jonathan-kemper/) [查看 Jonathan Kemper 的 LinkedIn 个人资料](https://www.linkedin.com/in/jonathankemper/) 2026 年 10 月 28 日 Nano Banana Pro 由 THE DECODER 生成 核心要点
- Nvidia 发布了 Nemotron 3.5 Transcribe,这是一款开源语音模型,能够遵循文本指令,并集成了多达 40 种语言的转录、翻译和说话人识别功能。
- 该模型拥有 300 亿参数,但每步仅激活 40 亿参数,因此可在单个 GPU 上运行。其在准确性和说话人归属方面的基准测试中名列前茅。
- Nvidia 还发布了 Granary v2 数据集,包含 844,000 小时的音频数据,以及用于将模型高效适配到医疗等特定领域的工具。
询问关于这篇文章… 搜索
Nvidia 发布了一款接受文本指令的开源语音识别模型,该公司称其在多项基准测试中处于领先地位。此次发布还包括一个大型训练数据集以及用于将模型适配到特定领域的工具。
普通的转录文本无法告诉你谁说了什么,也无法进行翻译或正确拼写技术术语。Nemotron 3.5 Transcribe 旨在通过单一模型处理所有这些任务,并且还能回答有关录音内容的问题。Nvidia 表示,该模型可转录 40 种语言,将其中的 31 种翻译成英语或从英语翻译过来,并能识别 13 种语言中的说话人。它支持长达一小时的录音,最多可包含八位说话人。
用户可以通过简单的指令来控制模型。根据提示词的不同,同一段会议录音可以生成带有说话人标签的转录文本、英文翻译版本,或是决策摘要。用户还可以传入诸如药物名称等技术术语作为提示。模型仅在这些术语确实出现在录音中时才会使用它们。
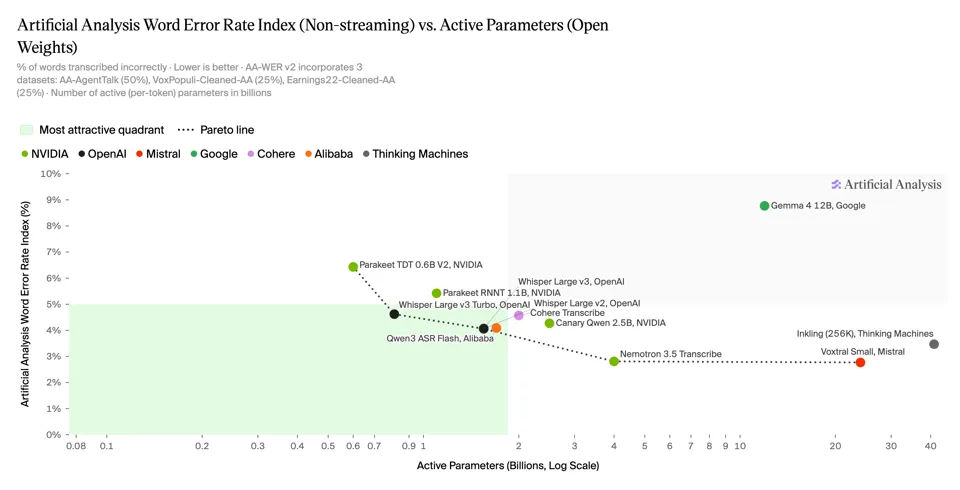 在 Artificial Analysis 的对比中,Nemotron 3.5 Transcribe 的错误率略高于 Mistral 旗下参数量大得多的 Voxtral Small,但计算资源消耗却仅为后者的一小部分。| 图片来源:Artificial Analysis
单 GPU 即可实现接近顶尖的准确率
该模型拥有 300 亿参数,但在每个处理步骤中仅有约 40 亿参数处于激活状态。因此,它可以在单个 Nvidia GPU 上运行,涵盖从紧凑型的 DGX Spark 到数据中心硬件的各种配置。Nvidia 表示,在采用 NVFP4 精度的 RTX PRO 6000 Blackwell Server Edition 上,该模型可在不到三分钟的时间内处理 100 小时的音频。
在 Hugging Face 的英语 Open ASR Leaderboard(开源自动语音识别排行榜)上,Transcribe 以 5.33% 的平均字错误率(WER)位居开源权重模型之首。而在 Artificial Analysis 的对比评测中,其得分则为 2.81%。这一成绩非常接近表现最佳的开源模型——Voxtral Small(2.77%),但 Transcribe 使用的激活参数数量仅约为后者的六分之一。据 Nvidia 称,目前广泛使用的几款商业语音服务在该指标上均落后于 Transcribe。
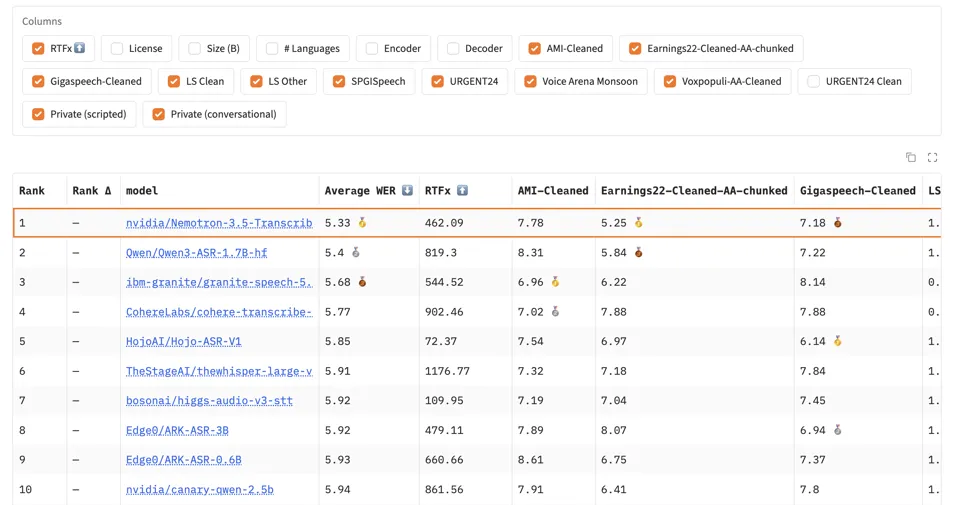 在 Hugging Face 的 Open ASR Leaderboard 上,Nemotron 3.5 Transcribe 略微超越了来自阿里巴巴和 IBM 的开源模型。| 图片:Hugging Face
其在说话人识别方面的优势最为显著。VoiceArena 对 14 个系统进行了测试,场景为说话人偶尔相互打断的对话,Transcribe 位列第一。此外,它的漏词率最低,仅为 8.32%,而中位数约为 31%。在 David AI 的基准测试中——该测试衡量跨 21 种语言的说话人归属准确率——它取得了最低的误差率。其表现仅略优于 Nvidia 专为该任务开发的自有模型。
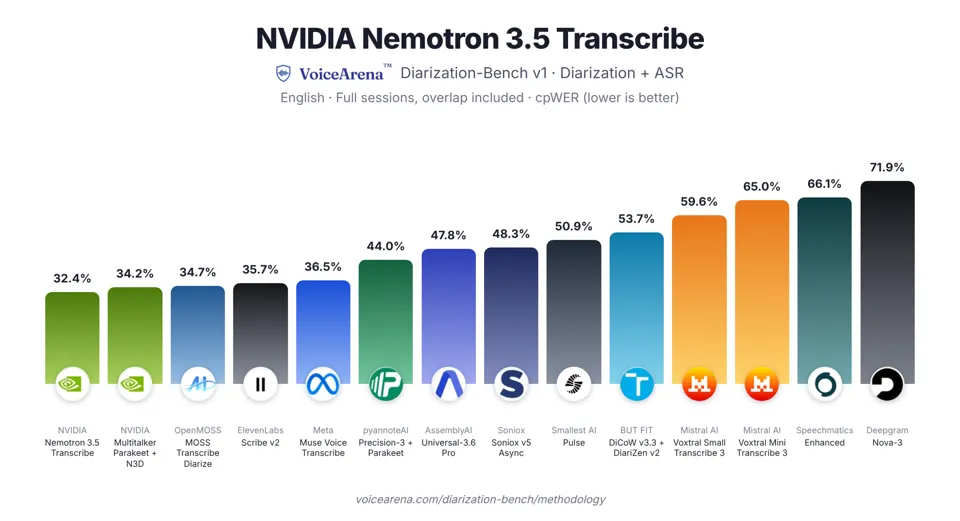 在 VoiceArena 的比较中,Nemotron 3.5 Transcribe 最能准确区分在说话人相互打断的英语对话中“谁说了什么”。数值越低越好。| 图片:VoiceArena
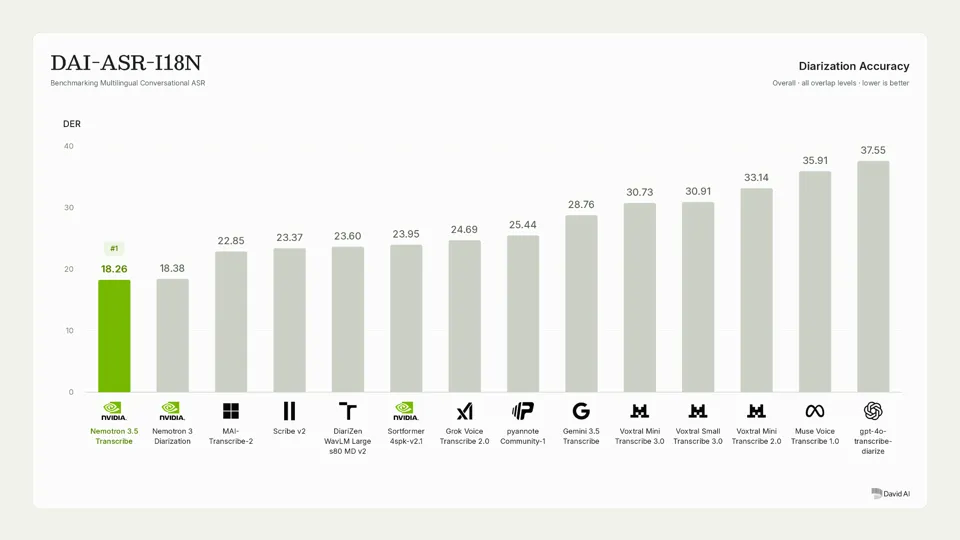 在 David AI 的基准测试中,Nemotron 3.5 Transcribe 在跨 21 种语言识别当前说话人方面最为可靠。数值越低越好。| 图片:David AI
开放数据集助力开发者针对特定领域进行训练
与模型一同发布的还有 Nvidia 的 Granary v2 数据集。该数据集包含约 84.4 万小时的语音数据,覆盖 48 种语言,相比上一版本中涵盖 25 种语言的约 64.3 万小时有了显著提升。每段录音都提供了多种转录风格:一种是逐字转录(verbatim),保留“uh”等填充词并将数字拼写出来;另一种是清理后的版本,去除了填充词并直接使用阿拉伯数字。Nvidia 还分享了用于构建该数据集的工具,以便开发者能在自己的录音上运行这些工具。不过,该公司表示该数据集并未完全匹配模型的训练数据。
Nvidia 在针对印度医生和医学生的录音上测试了定向微调(targeted fine-tuning)。在整个基准测试中,使用更精确的提示词将错误率从 30.8% 降至 23.8%。经过微调后,错误率进一步降至 11.8%。训练数据主要由合成语音构成。对于模型此前未听过的说话人,Nvidia 单独报告称错误率从 22.44% 降至 12.17%,相对改进幅度为 45.8%。这使得适配后的模型表现优于一个开源医疗语音模型,后者得分为 13.79%。Nvidia 表示,整个流程在 单块 Nvidia GB300 上耗时约 14 个 GPU 小时。
专业化也带来了一定代价。通用英语语音的错误率略有上升,且医疗模型在品牌药名上的准确率更高。Nvidia 建议在构建定制版本时,至少预留 100 条真实且经过验证的录音用于测试。
基础模型也存在局限性。不同语言的功能支持情况各异,Nvidia 指出音频问答功能是基于英语训练的。此外,该模型仅适用于录制音频。Nvidia 建议用户对姓名、说话人切换以及答案进行抽查验证。
模型和数据集均已发布在 Hugging Face 上。用户还可以尝试一个演示。关于微调,Nvidia 提供了指南以及一款扩展程序,允许 AI 编程助手执行训练工作流。
Nvidia 直到今年九月才刚刚推出 Nemotron 3 Diarization,一款专用的说话人识别模型。该模型能够区分多达八位说话人,即使在实时对话中也能做到,但它需要配合 Nvidia Parakeet 等独立模型来完成实际的转录工作。Nemotron 3.5 Transcribe 将这两项任务合二为一,并增加了翻译和音频理解功能。不过,它不支持实时处理。此前,Nvidia 已在 多模态 Nemotron 3 Nano Omni 中使用了 Granary 数据集。
竞争对手们则设定了不同的优先事项。Mistral 的 Voxtral 系列 同样结合了转录和音频理解功能。随着 最近发布的 Voxtral 3,该公司正专注于实时语音智能体(Voice Agents)。