LangChain 解析智能体循环工程:从基础推理到多层嵌套的架构设计方法论
LangChain 发布技术博客,深入剖析智能体“循环工程”的核心概念,指出可靠自动化不仅依赖模型能力,更需精心设计的执行框架。文章引用 Swyx 的“堆叠循环”理论,系统阐述了如何通过 LangChain 原语构建从基础 LLM 工具调用到复杂多循环嵌套的智能体架构。该指南旨在帮助开发者通过分层设计提升智能体在真实世界任务中的稳定性与有效性。
报道正文
本文目录10 个章节
Deep Agents开源智能体架构
循环工程的精髓
Sydney Runkle2026年6月16日7分钟返回博客创建智能体创建智能体
智能体的价值在于它们能够通过执行现实世界中的操作来帮助我们自动化工作。但要让智能体可靠地完成有价值的工作,仅靠一个优秀的模型是不够的:还需要一套精心设计的、适配特定任务的框架(harness)。
核心智能体算法很简单:给 LLM 提供上下文,让它在一个循环中调用工具,直到任务完成。这是最基础的循环。但驱动智能体的并非只有这一个循环。Swyx 最近撰写了一篇精彩的文章 "loopcraft: the art of stacking loops",阐述了通过堆叠和扩展循环来构建更高效智能体的理念。
以下是我们对这一“循环栈”的思考方式,以及如何利用 LangChain 的基础组件为每一层进行配置。
循环 1:智能体
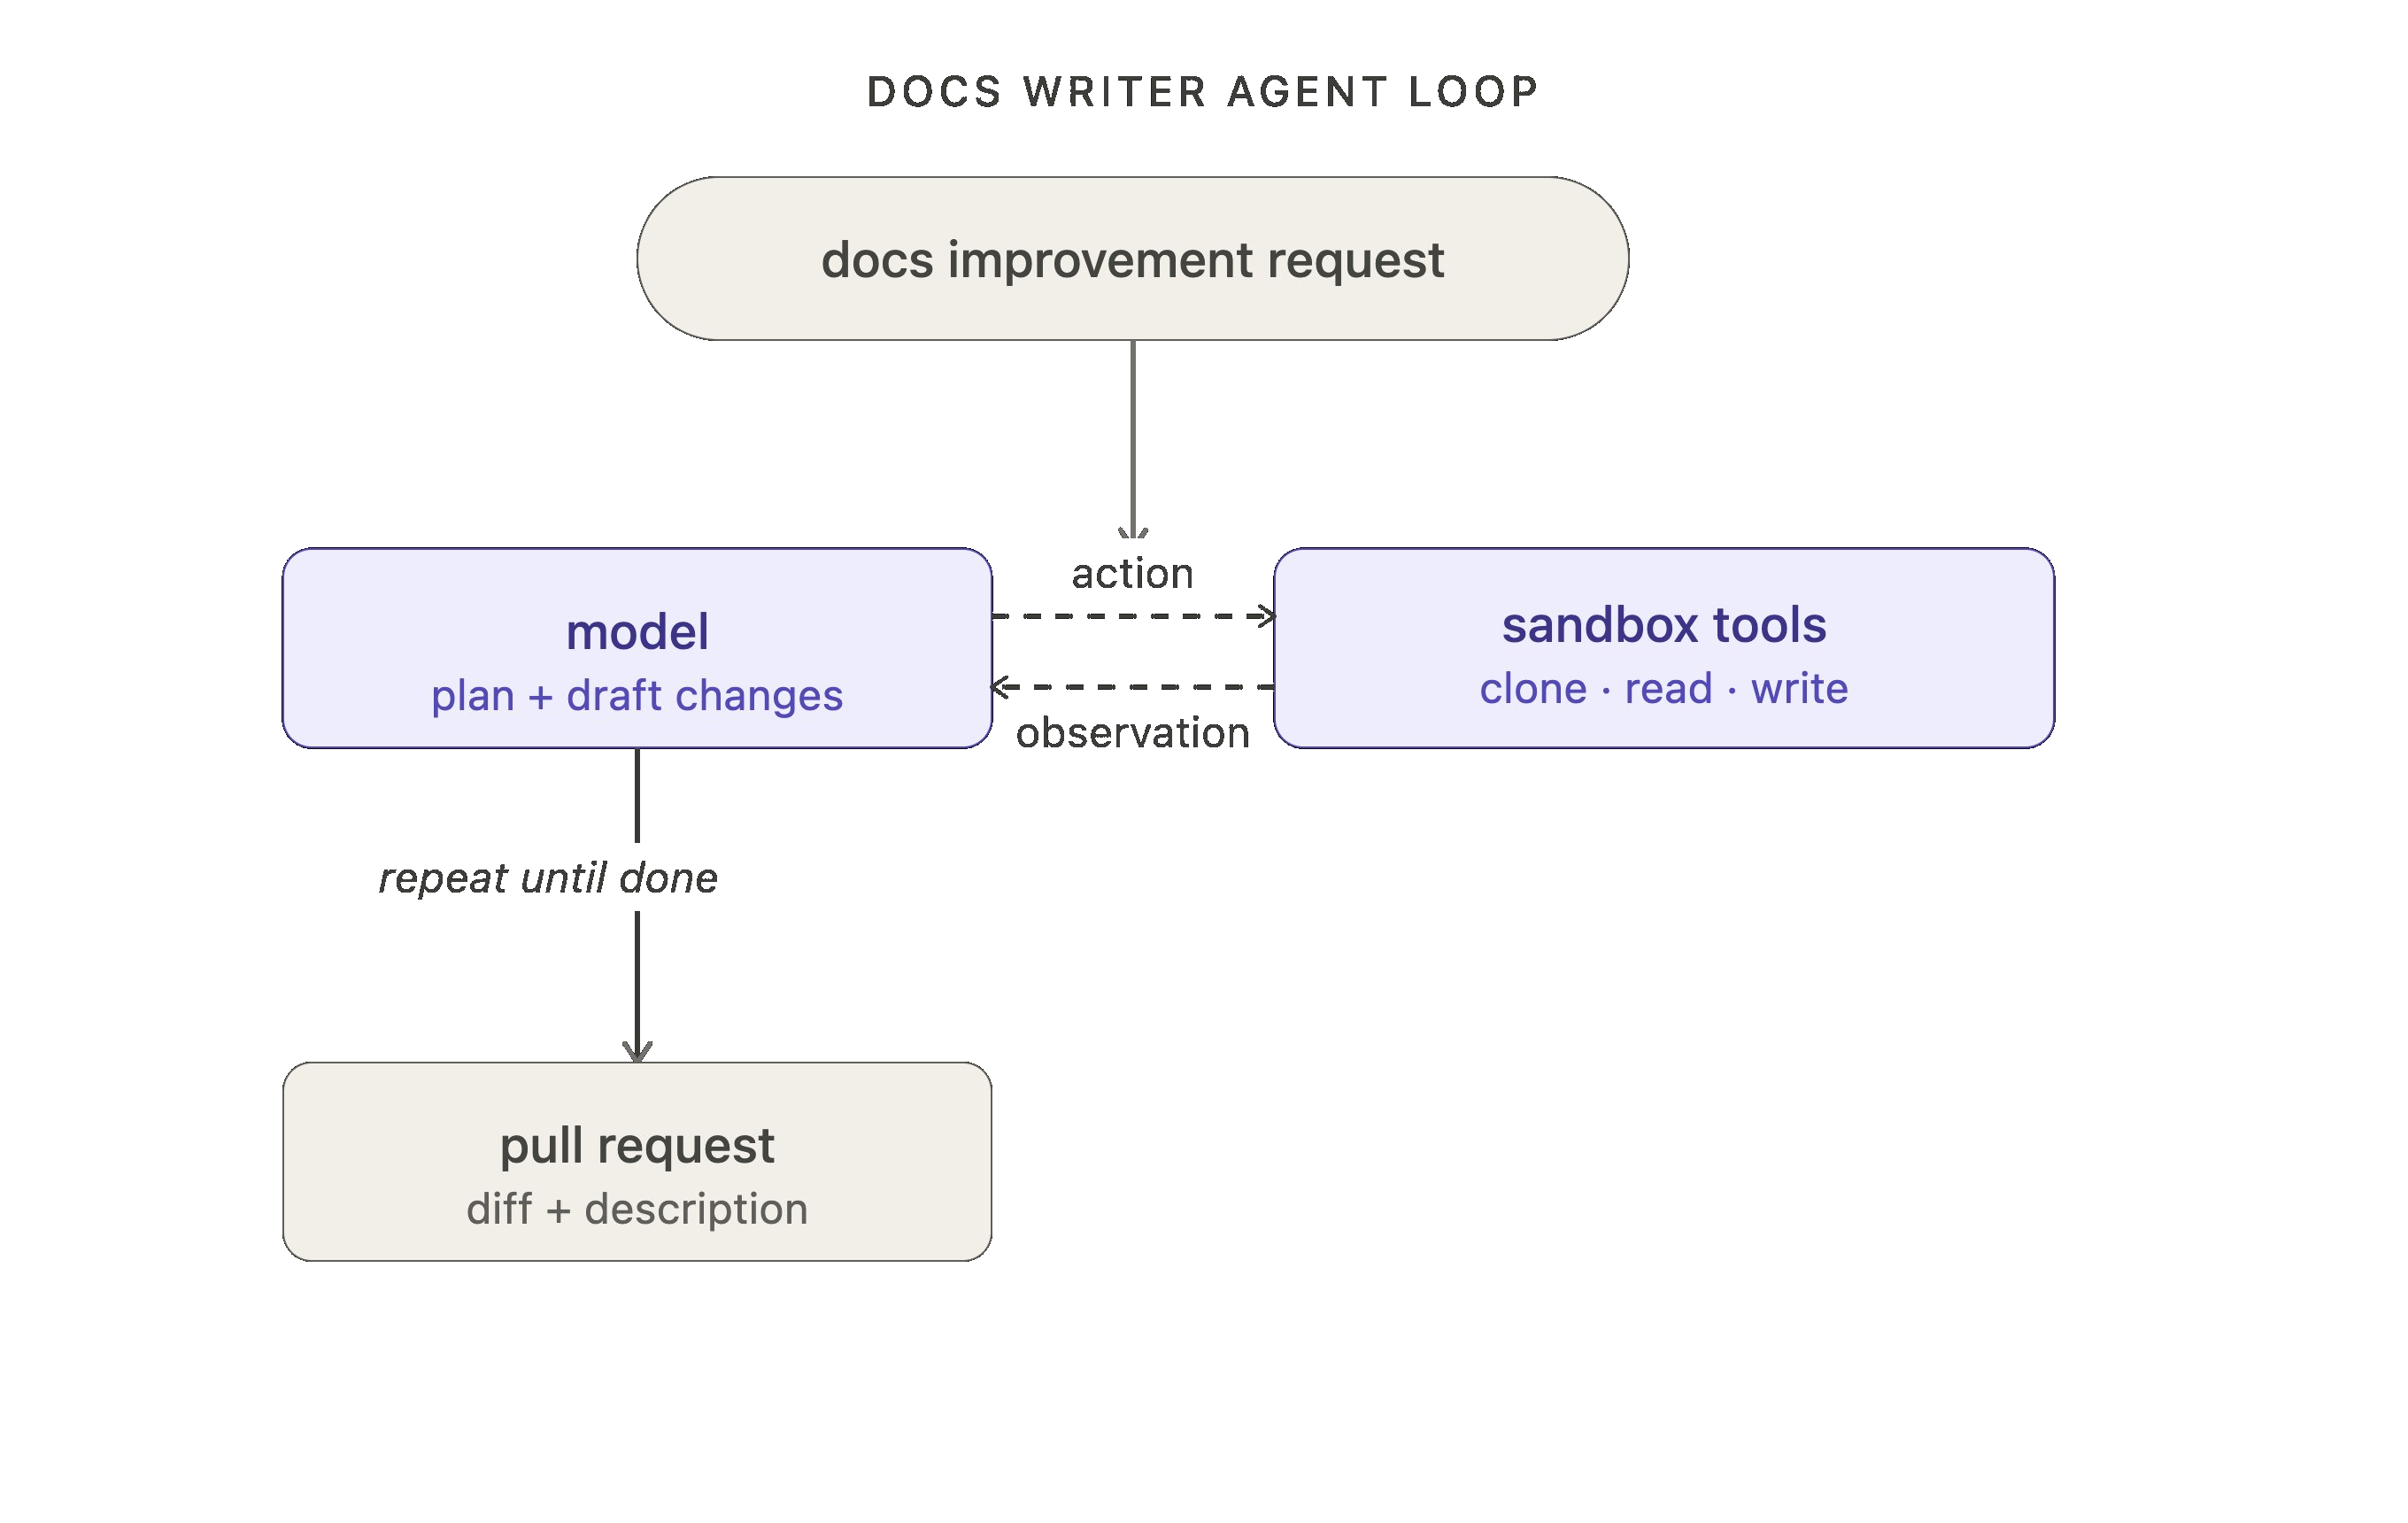
从本质上讲,智能体只是一个在循环中调用工具的模型,直到任务完成。

这就是 LangChain 的 create_agent 所提供的功能。选择任意模型,接入工具,你就拥有了一个可运行的智能体循环。工具赋予了智能体在现实世界中采取行动的能力。
以我们内部的文档智能体为例(我们将以此作为贯穿本文其余部分的示例)。在第一层循环中,它接收一个改进文档的请求,模型规划并起草更改,然后使用工具克隆仓库、读取文件、编写文档、发起 Pull Request 等。
层级 2:验证循环
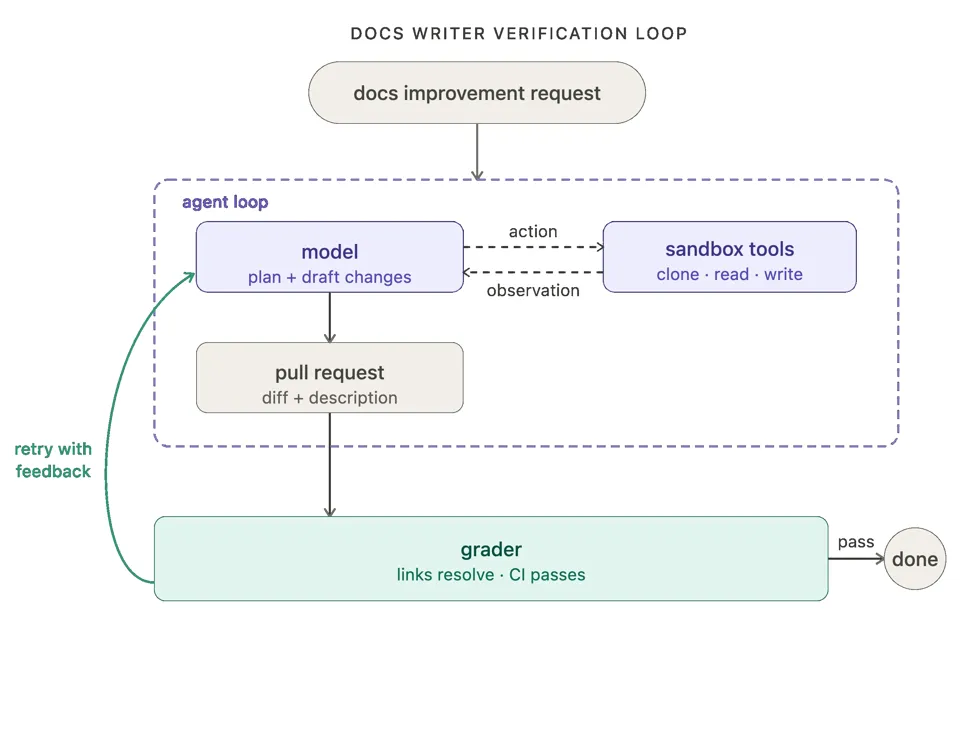
智能体循环能够完成工作,但并不总能一次性产出正确或一致的结果。当一致性至关重要时,通常有必要将其包裹在一个验证循环中,该循环会检查输出结果,并在结果不达标时将反馈发回给模型。

验证循环引入了一个评分器(grader):它根据评分标准检查 Agent 的输出,如果未通过,则将结果连同反馈一起发回。评分器可以是确定性的,也可以是 Agent 驱动的(LLM as a judge 是一个经典示例,参见此处)。
RubricMiddleware 处理这种模式,或者你也可以在 create_agent 上通过 after_agent hook 来配置它。
以我们的文档编写者为例,评分器会在每次尝试后运行测试,检查所有链接是否可解析、所有 CI 检查是否通过,以及 diff 是否仅限于实际请求的内容。无需人工审查即可捕获这类错误。
一个权衡点在于:添加验证会增加每次运行的延迟和成本。当质量比速度更重要时(这适用于大多数生产用例),这种做法是值得的。
Level 3: 事件驱动循环
Agent 开发中最关键的部分之一是集成层:将你的 Agent 连接到你的生态系统,使其能够在后台运行。
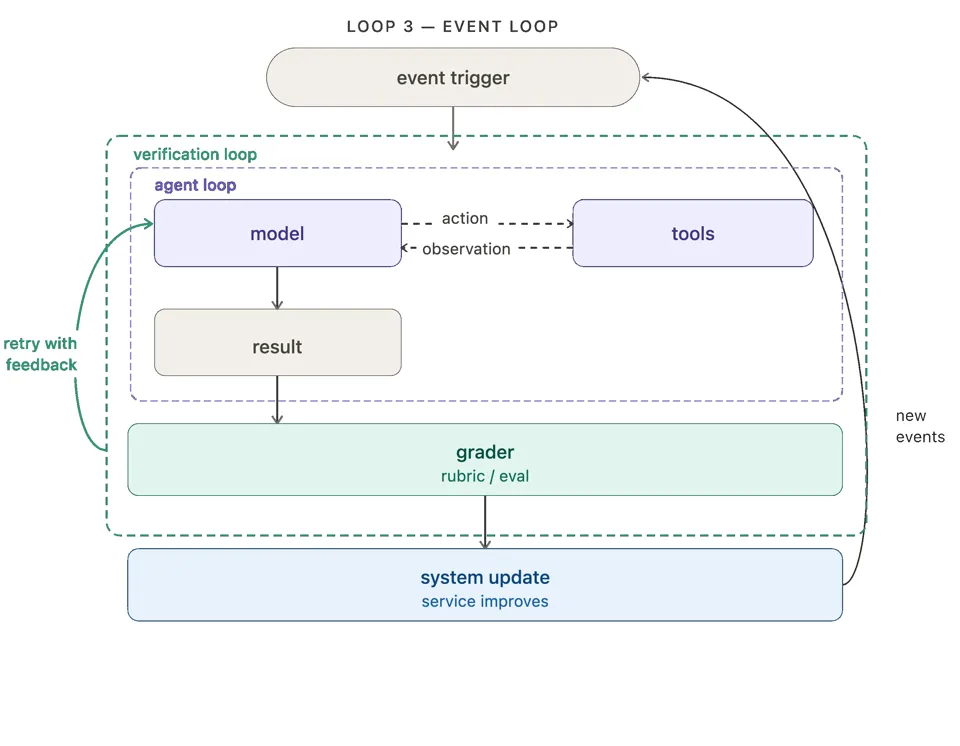
事件驱动循环将你的 Agent 与生态系统连接起来。当一个事件触发——例如新文档到达、计划任务启动或 webhook 接收——Agent 就会运行。此时,Agent 不再是你手动调用的对象,而是作为一个持续运行的组件嵌入到更大的系统中。
LangSmith Deployment 支持触发器基础设施,包括对 cron 定时任务 和 webhooks 的支持。Cron 的一个流行应用示例是 openclaw 中的“心跳”机制,它可以将你的 Agent 转变为始终在线、主动响应的助手。
我们的文档 Agent 由 Fleet 驱动,这是我们提供的无代码 Agent 构建工具。Fleet 的 channels 和 schedules 分别处理事件驱动型和 cron 风格的触发器。我们使用一个 channel,每当在 #docs-plz Slack 频道中发送消息时,就触发文档 Agent 运行。
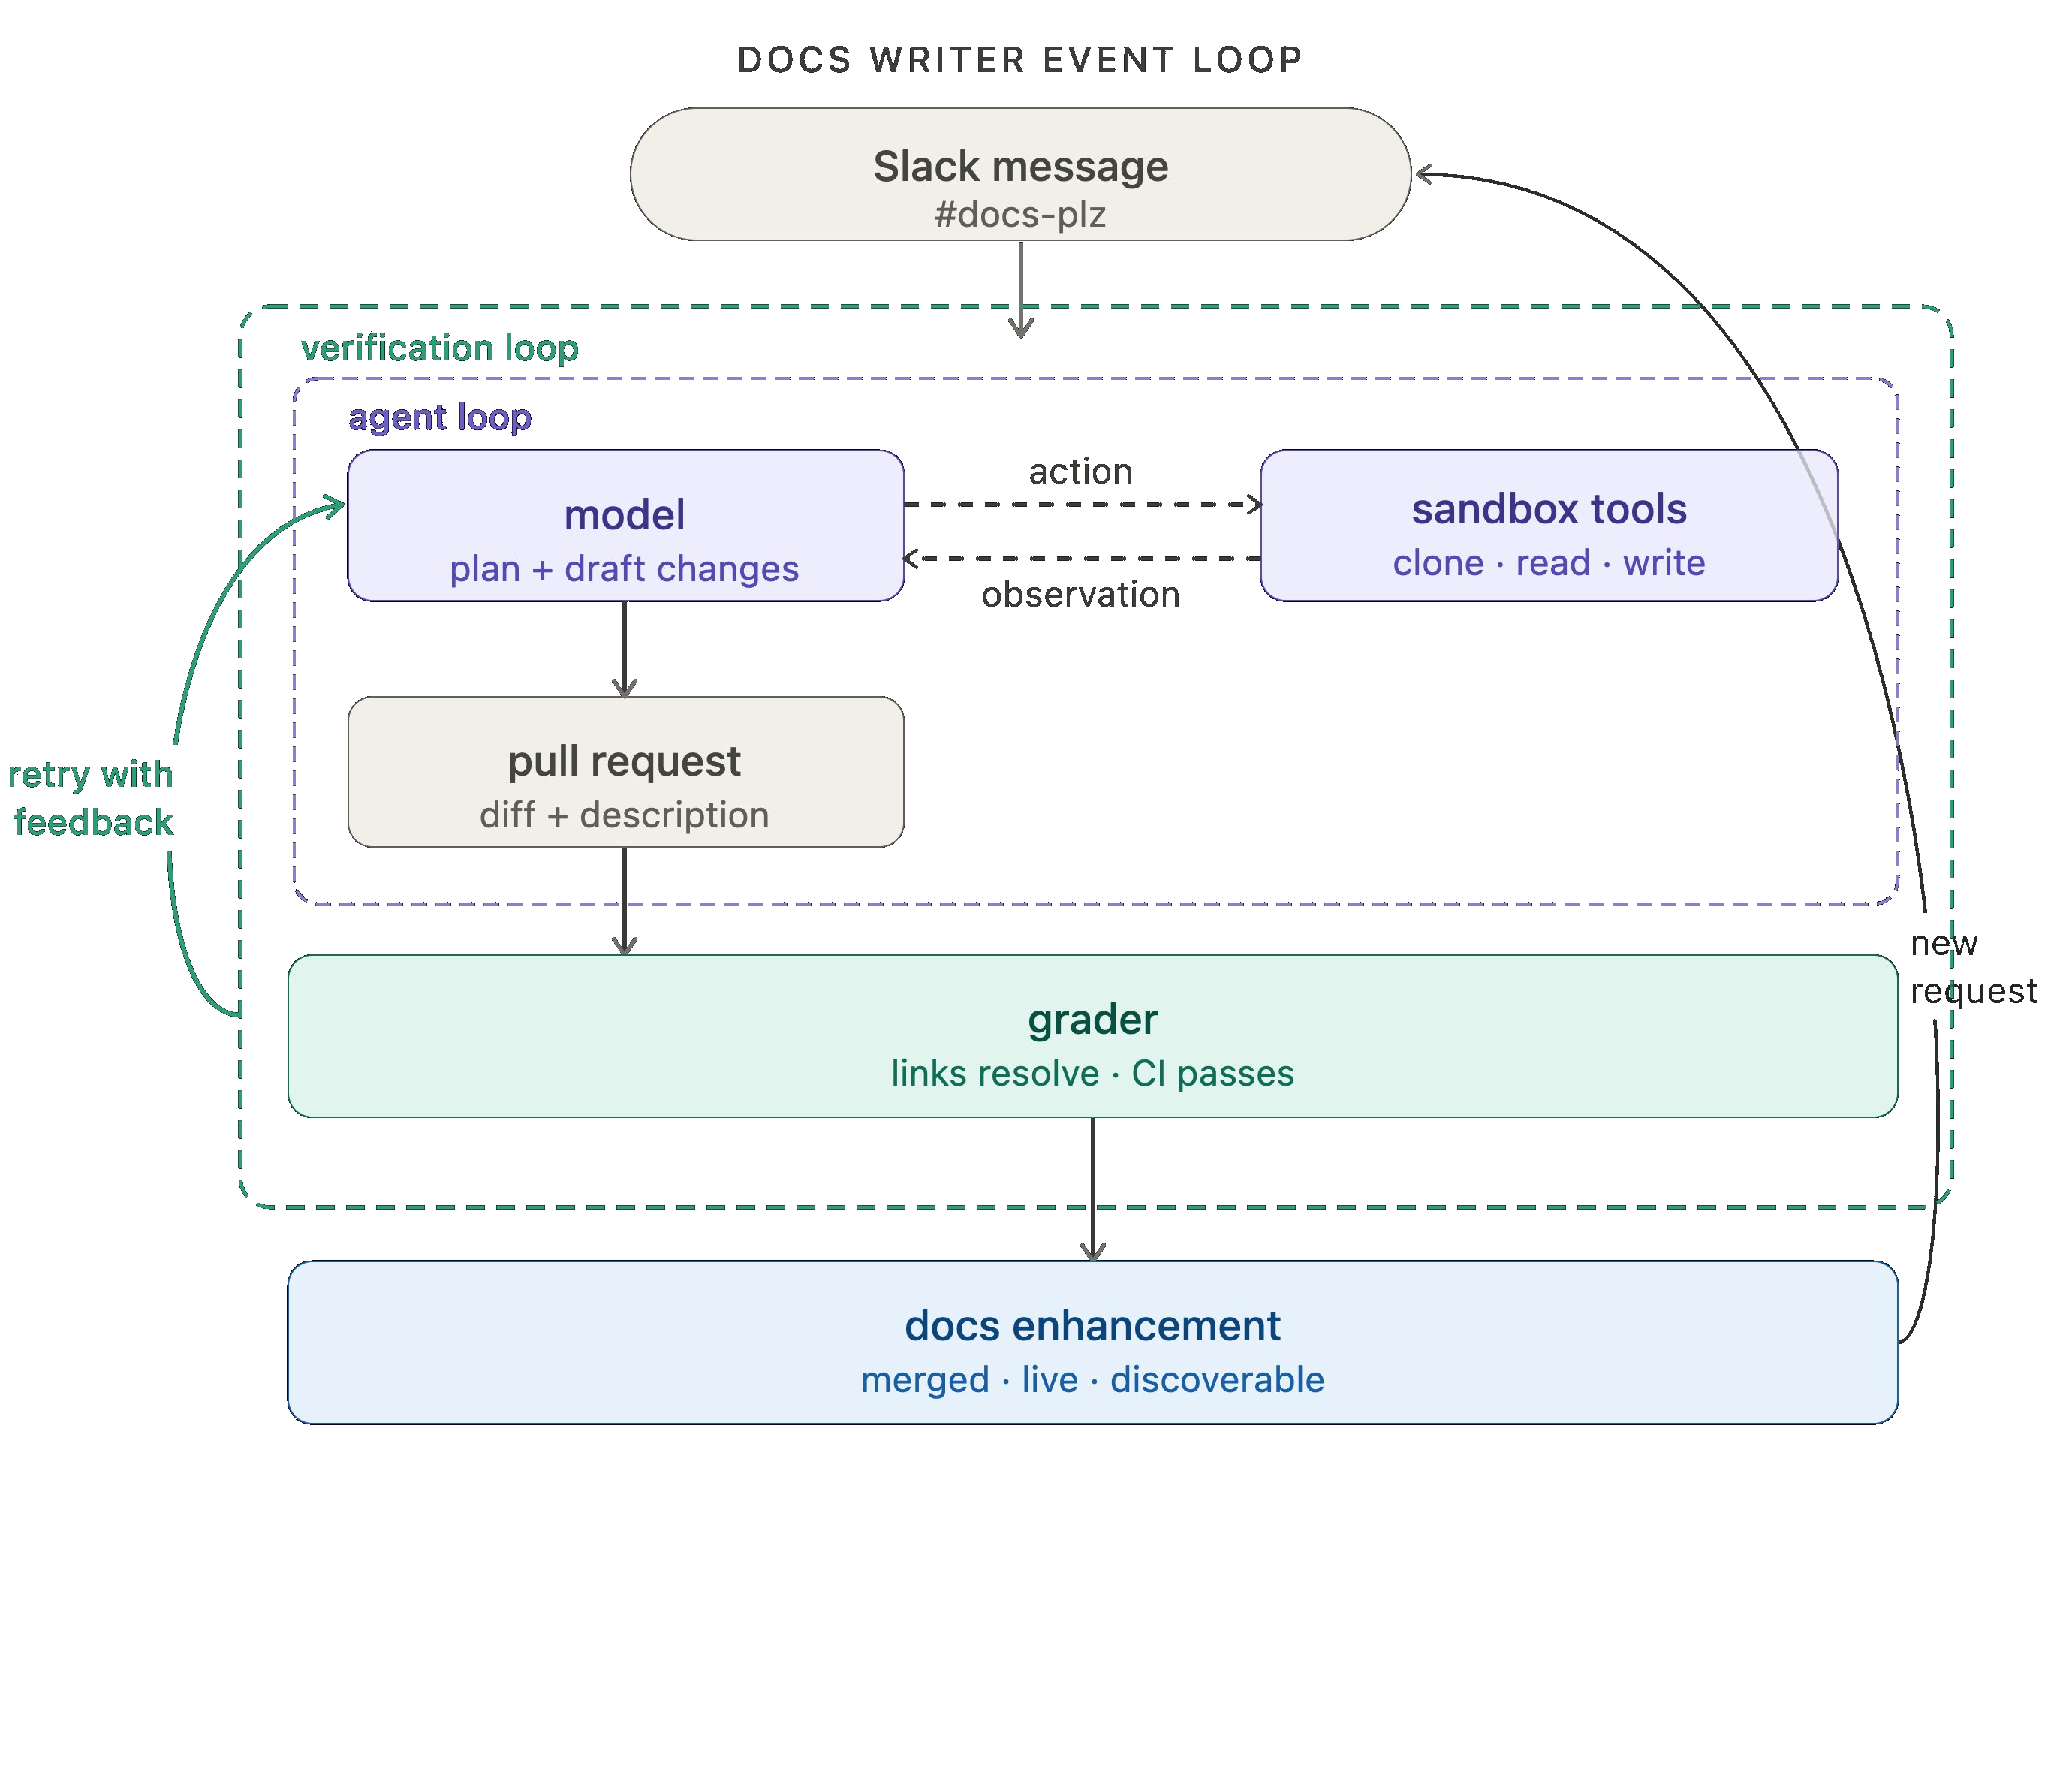
Level 4:爬山循环(Hill Climbing Loop)
前三个循环实现了工作的自动化,而第四个循环(可以说也是最重要的一个)则实现了改进的自动化!
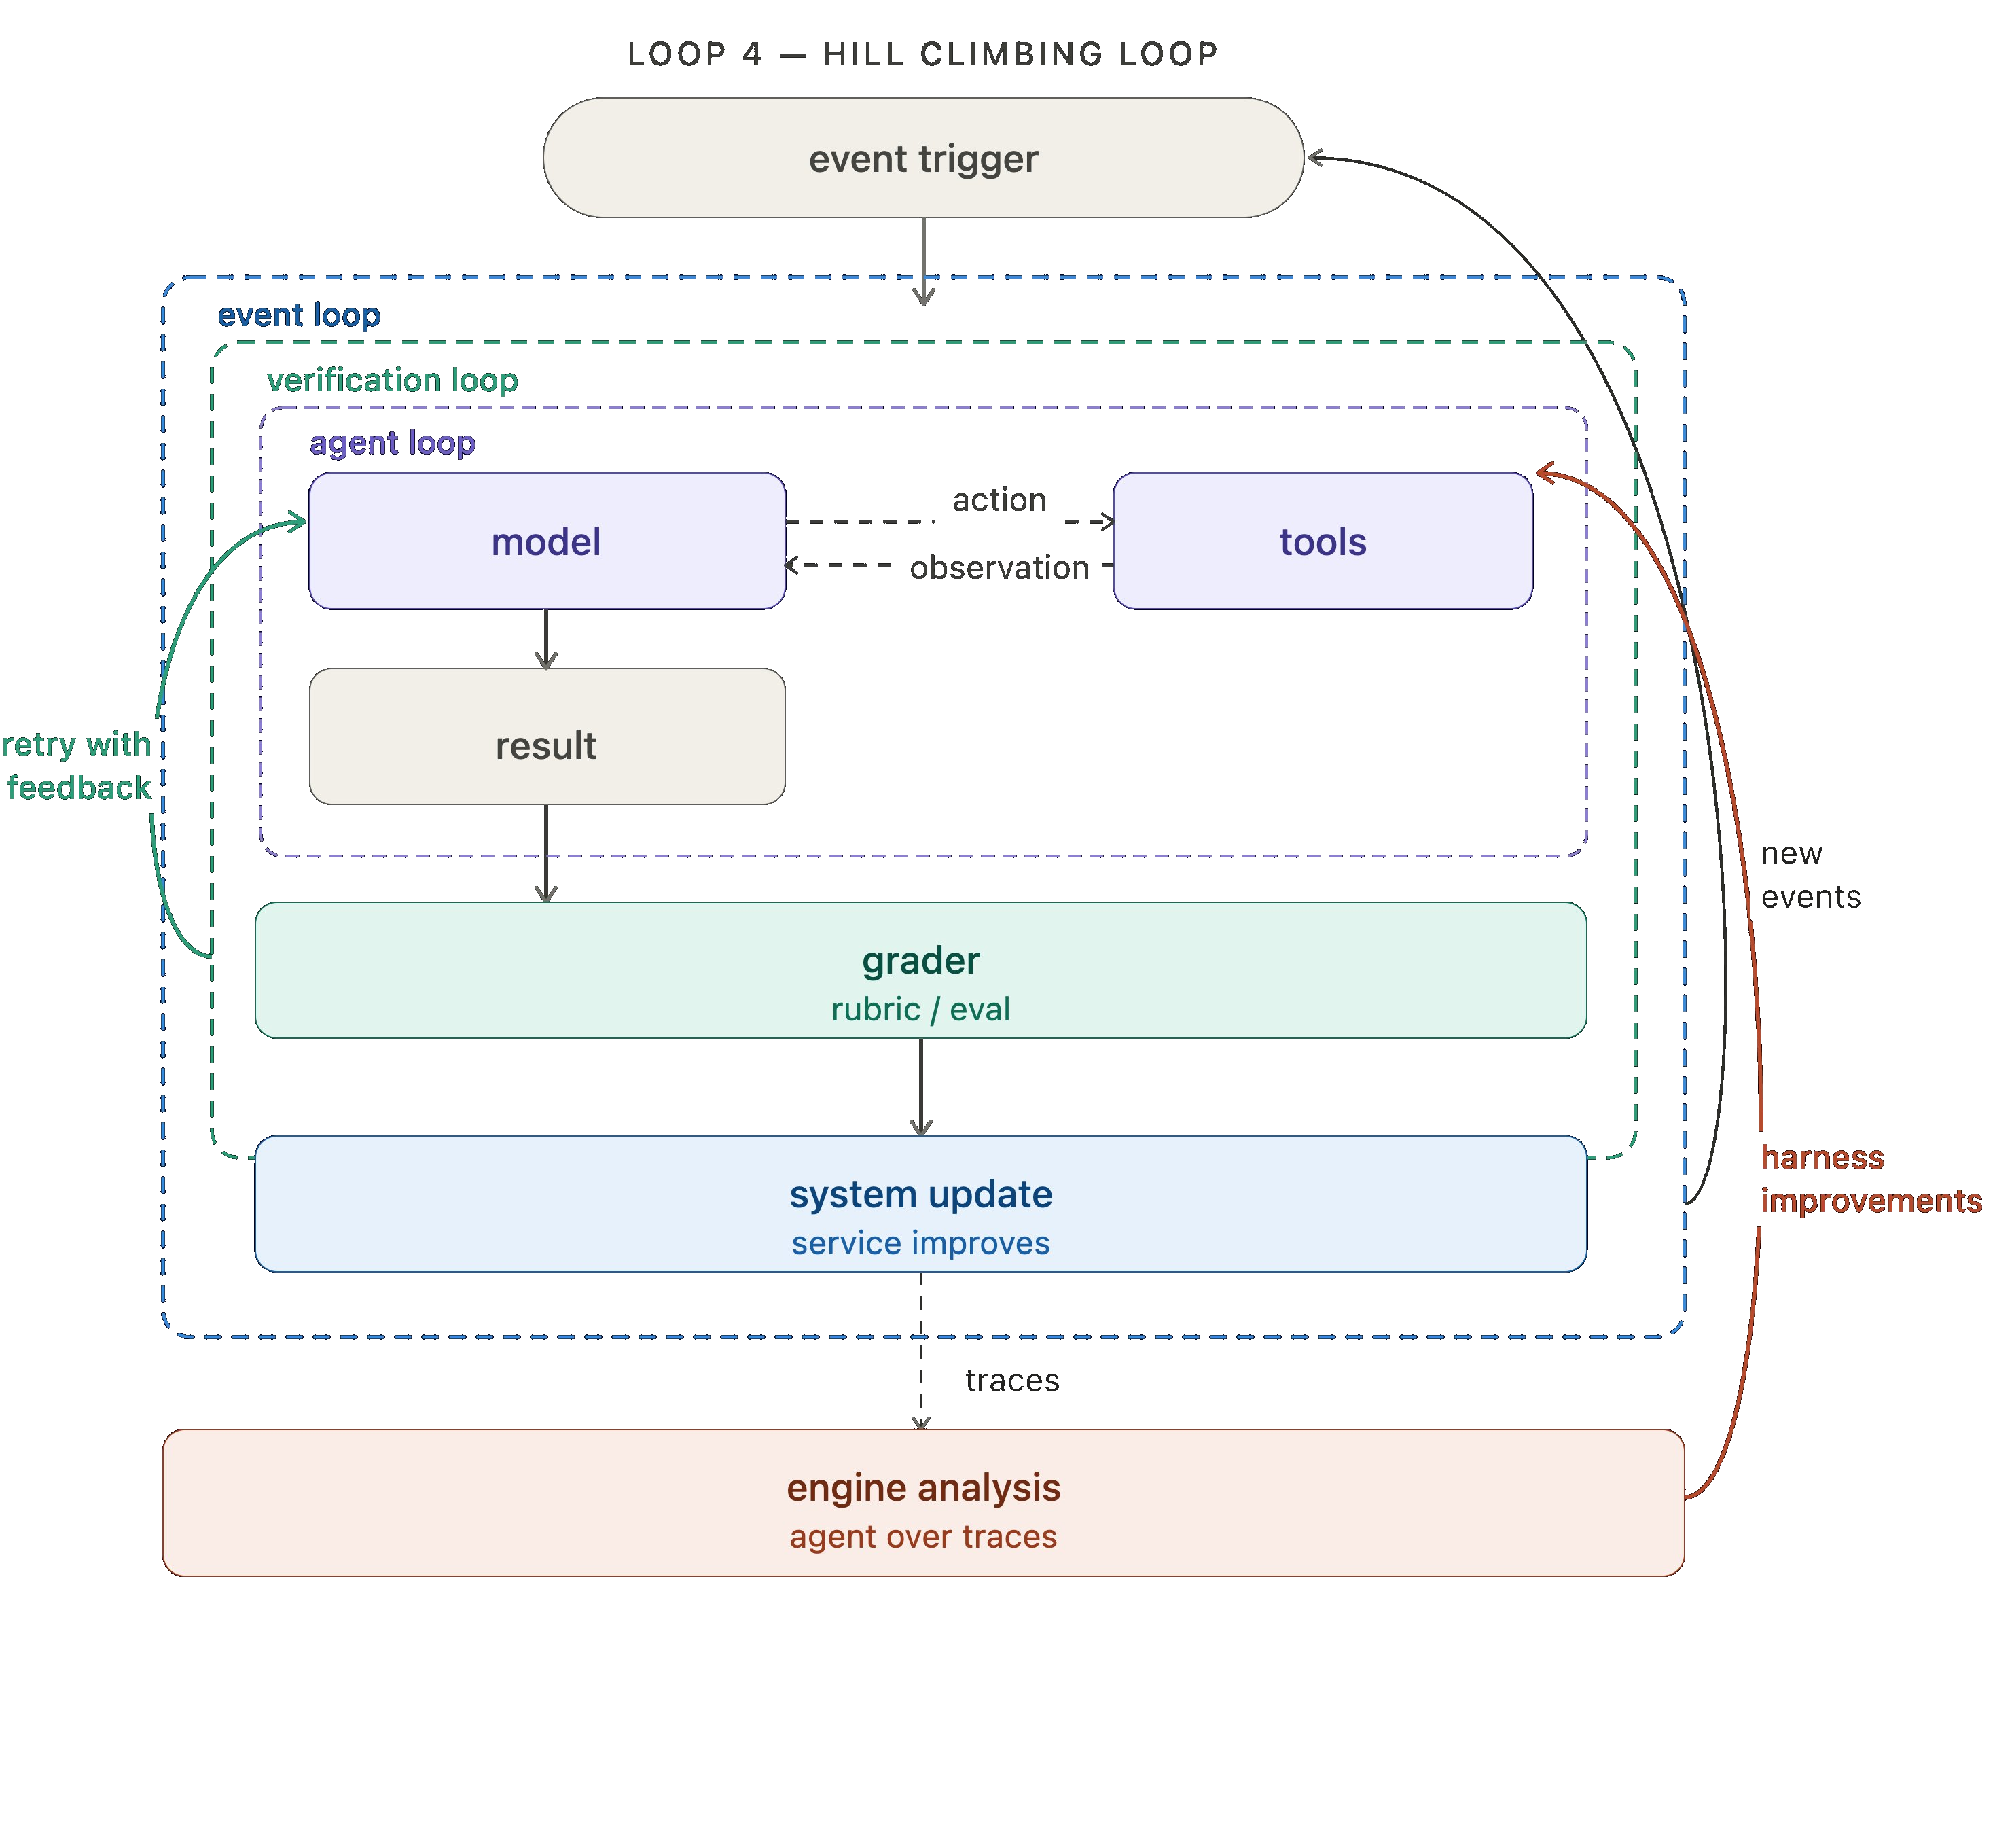
每次 Agent 运行都会 生成一条 trace:记录模型执行的操作、调用的工具、评分器反馈等信息。这些 trace 中包含高价值的信号,能够反映哪些部分有效、哪些部分无效。爬山循环会运行一个分析 Agent 来处理这些 trace,并利用分析结果重写 harness 的配置以提升性能。这可能包括对 prompt 或工具的调整,或者对评分器的优化。
在 LangSmith 中,你可以使用 Engine,即我们的 trace 分析 Agent,来实现这第四个循环。
在总结文档智能体的类比时,我们使用引擎对文档智能体的执行轨迹(traces)进行分析,以检测潜在问题。当多条轨迹指向同一个潜在问题时,系统会自动创建一个 Issue,请求修改有问题的提示词(prompt)或工具。
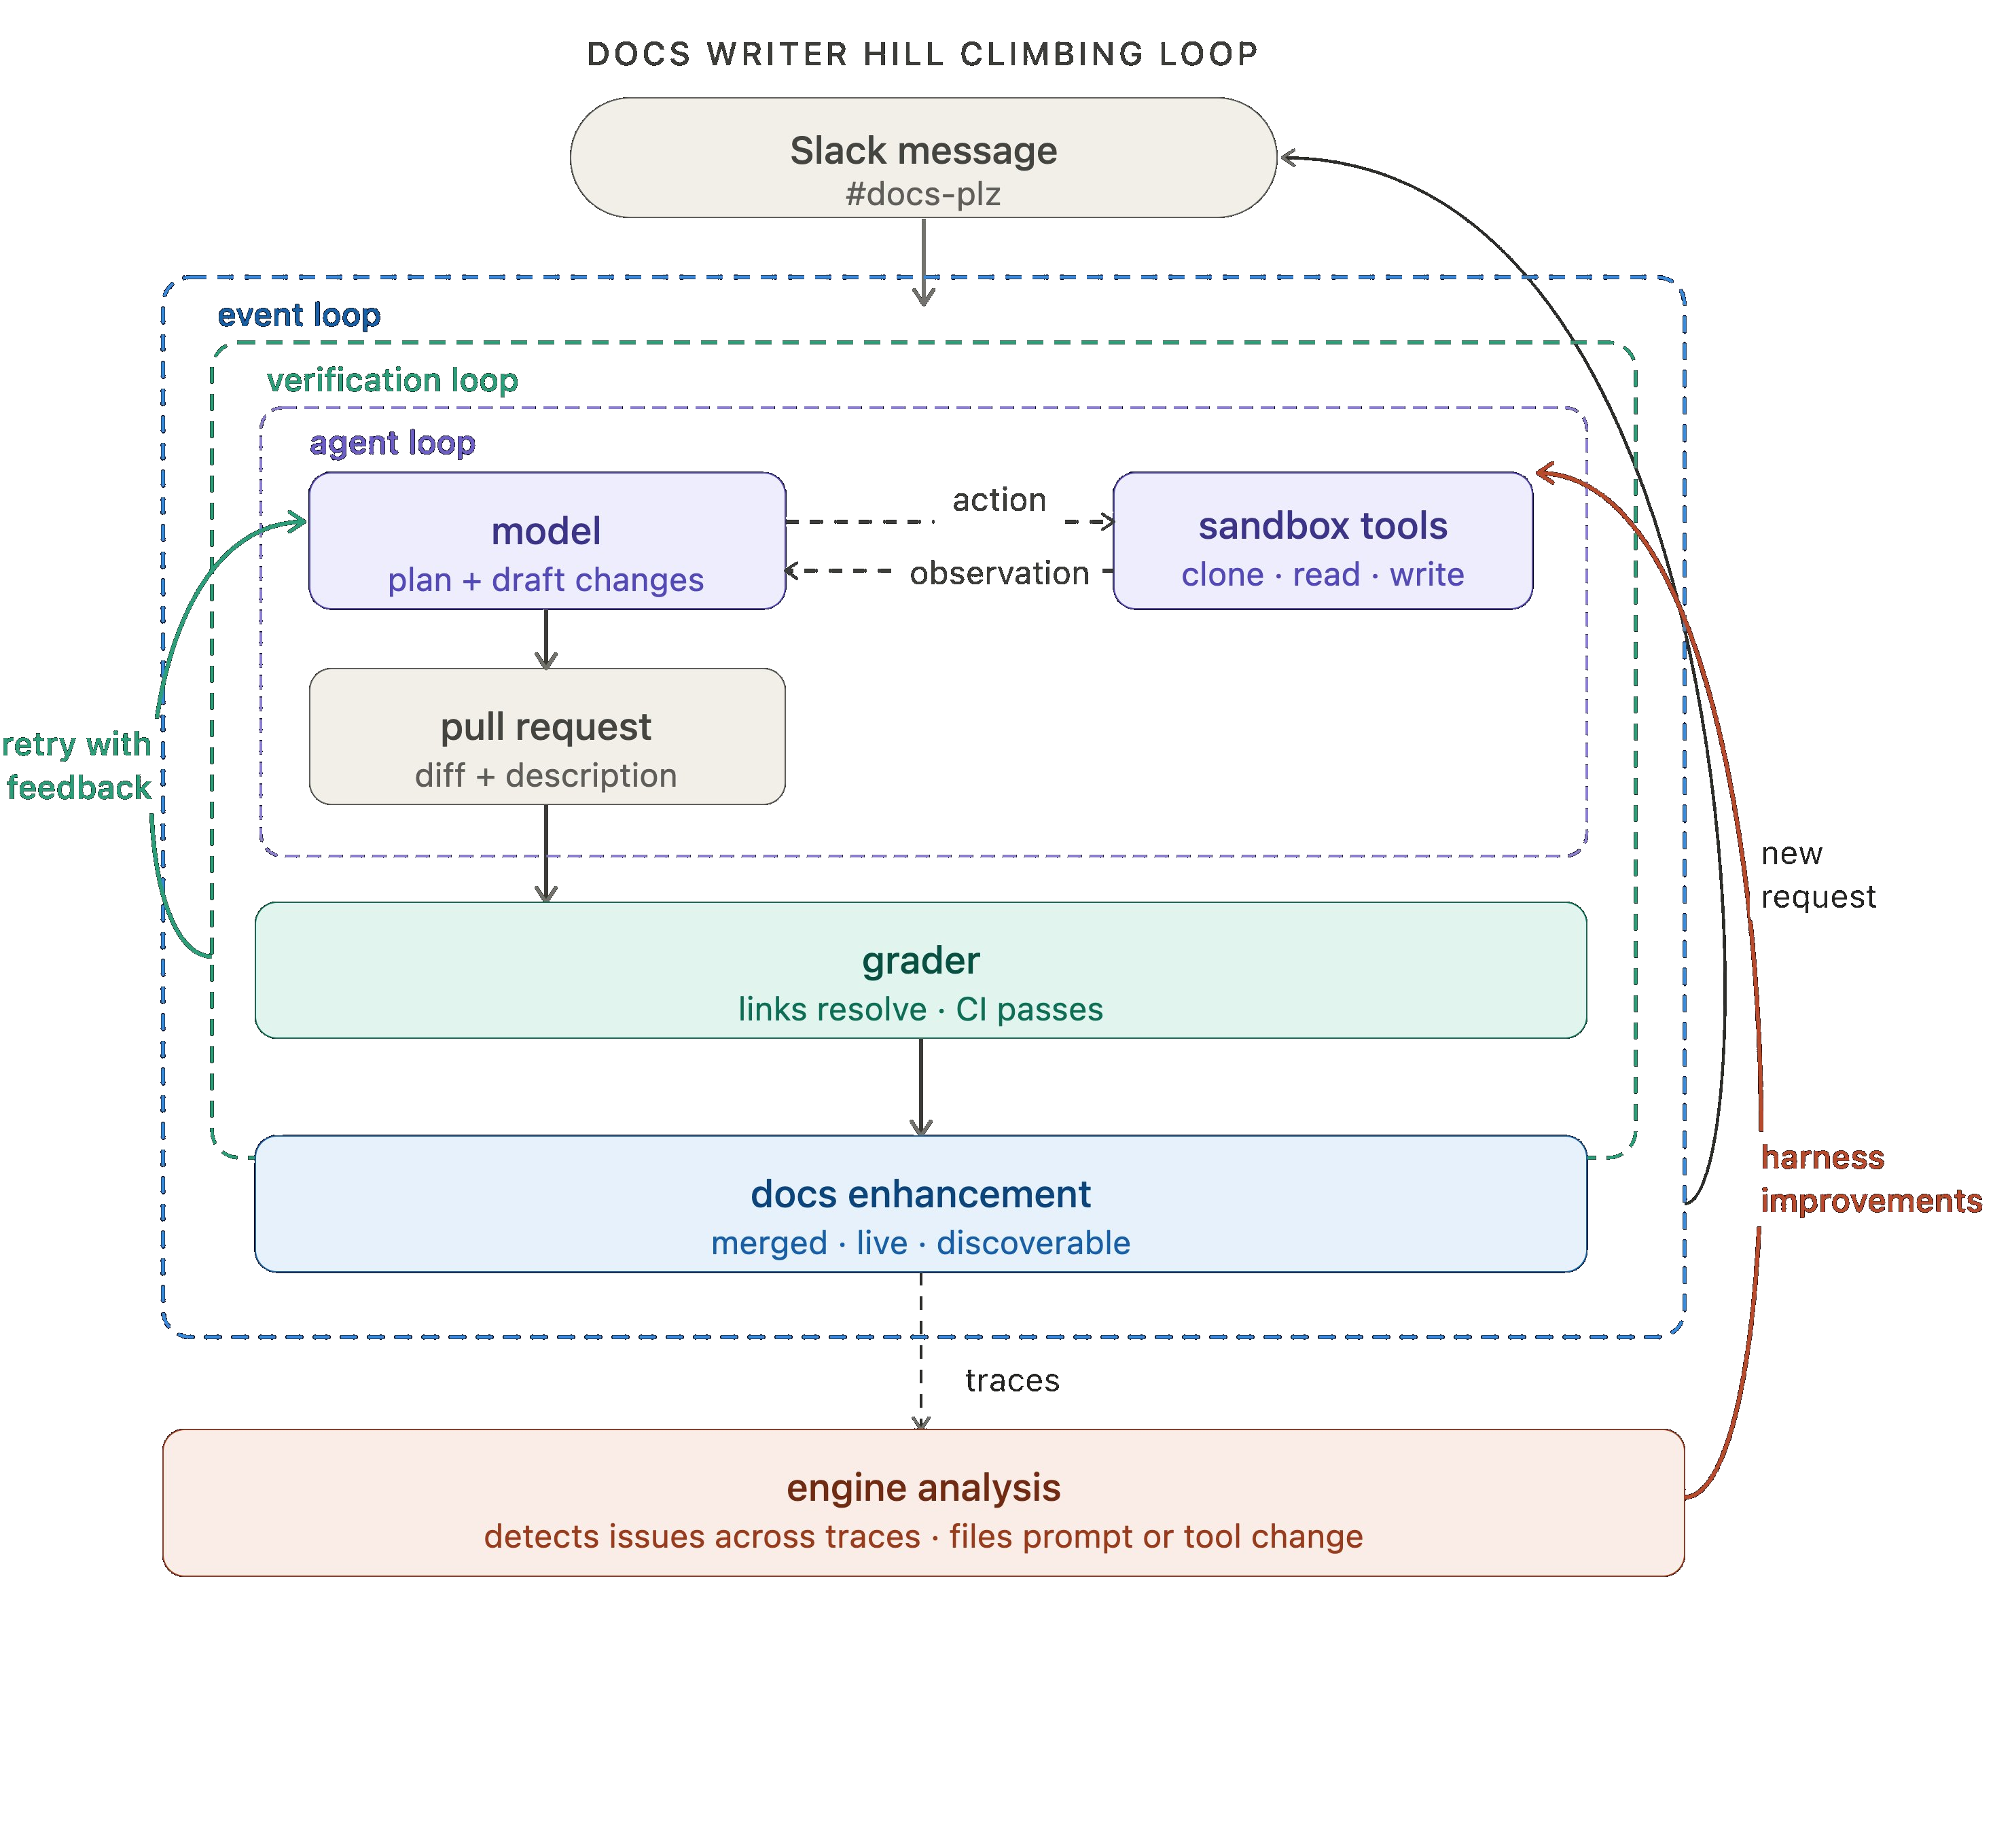
这里的关键在于,返回箭头不仅仅是循环回到顶部——它直接深入内部并更新智能体循环本身。外层循环的每一次迭代,都会使内层循环更加高效。
展望未来: 优化提示词和工具配置是最简单直接的改进方式,但这并非唯一选项。对于运行开源权重模型(open-weight models)的团队而言,“爬山”循环可以接入强化学习微调(RL fine-tuning),利用执行轨迹或评估结果作为训练信号,从而提升模型本身的能力。辅助上下文(如记忆模块和检索到的技能)也可以通过相同的方式进行优化。这种循环模式是通用的;具体优化什么,取决于你的需求。
人工监督与专业知识
自动化并不意味着将人类从流程中移除。在每个层级上,都存在自然的人工监督切入点,能够增加价值。自动评分器可以检查链接是否有效;但要发现内容框架不适合目标受众,则需要人类的判断力。这种基于语境、经验和品味所形成的判断力,正是人工审查发挥关键作用的地方。
某些专业知识应当被编码到提示词或工具本身中,但对于敏感操作(例如金融交易、数据库操作等),实时的人工审查至关重要。LangChain 使得在这些循环中嵌入此类触点变得非常直观:
- 在智能体循环中,在执行敏感操作或调用工具前,要求人工输入。
- 在验证循环中,人类可以在敏感工作流中充当评分者。
- 在应用循环中,在输出返回给最终用户之前,由人类进行审批。
- 在“爬山”循环中,Harness 的改进措施需经过人工审查后方可部署。
LangChain 的所有开源框架都将“人在回路”(human in the loop)视为一种一等公民原语。
整体概览
如果你更喜欢表格形式的视图,以下是这四个循环如何协同工作的总结:
| 循环 | 功能描述 | 影响 | LangChain 原语 |
|---|---|---|---|
| 1. Agent 循环 | 模型反复调用工具,直到任务完成 | 自动化工作 | create_agent, 任何受 LangChain 支持的模型 |
| 2. 验证循环 | Agent 运行后,输出根据评分标准进行打分,若未通过则结合反馈重试 | 确保工作质量与正确性 | RubricMiddleware |
| 3. 事件驱动循环 | 事件触发 Agent 运行,从而更新实际系统 | 规模化自动执行工作 | LangSmith Deployment 配合 cron 触发器 / webhooks 或 Fleet channels |
| 4. 爬山优化循环 | 生产环境运行的 Trace 数据输入分析 Agent,以改进 harness 配置 | Harness 优化 | LangSmith Engine |
这就是所谓的 loop engineering——或者如 swyx 所称的 loopcraft——在实际应用中的真实形态。包括 Steipete、Boris 和 Andrej 在内的 AI 领域领军人物都达成了共识:Agent 的潜力在于你围绕其构建的循环。
我们此前一直聚焦于第 1 和第 2 类循环。但重心应转向第 3 和第 4 类循环,在这些场景中,通过将 Agent 嵌入你的生态系统并使其根据你的标准持续自我改进,价值将呈复利增长。
Satya 阐述了组织层面的利害关系:那些尽早构建学习循环的公司,即让人类判断力与 token 资本共同产生复利效应的公司,将建立起难以复制的优势。
致谢
感谢 Vivek、Mason、Harrison 和 Hunter 提供的细致审阅。
参考
- deepagents 快速入门
- create_agent 文档
- rubric middleware
- cron jobs, webhooks
- langsmith engine
- fleet channels
