AWS Bedrock 推出智能体检索:LangChain 多意图查询优化
Amazon Bedrock Knowledge Bases 引入“智能体检索”模式,通过规划器将复杂的多维度问题拆解为子查询,以解决传统 RAG 在单一向量搜索中丢失部分意图的问题。该功能结合 LangChain 实现,旨在提升多跳或复合问题的检索覆盖率与准确性,同时对比了其与标准检索的成本差异。
报道正文
本文目录11 个章节
当用户向基于 LangChain 构建的检索增强生成(RAG)支持助手提问,要求从三个维度比较两款产品时,他们实际上同时提出了六个问题。相似度搜索使用单个查询向量来涵盖所有意图。检索器随后生成这些意图平均值的最佳近似结果。最终返回的答案简洁明了。搜索执行无误。相关性评分看起来合理。然而,检索到的文本块虽然主题相关,却只覆盖了实际问题的一小部分。
在本文中,我们展示了一个在 Amazon Bedrock 托管知识库上运行的 RAG 应用,该应用使用了 LangChain。我们将同一个多部分问题分别通过标准检索和智能体(agentic)检索进行处理,并读取追踪事件以查看模型生成的计划。我们还探讨了这两种检索路径的成本,以及何时选择成本较低的路径更为合适。
智能体检索现已在 Amazon Bedrock 托管知识库中可用。Amazon Bedrock 托管知识库不再执行单次搜索,而是规划检索过程。它将问题分解为子查询,运行这些子查询,判断证据是否充分,如果不足则再次搜索。langchain-aws 包同时暴露了智能体检索和标准检索接口,因此你可以在 LangChain 应用中任选其一。
解决方案概述
Amazon Bedrock 托管知识库是 Amazon Bedrock 中完全托管的 RAG 功能,它消除了 RAG 架构中对自管理向量存储、嵌入和重排序模型的依赖。你只需配置数据源,Amazon Bedrock 托管知识库便会处理分块、嵌入、存储和检索。本指南使用 Amazon Simple Storage Service (Amazon S3)。
Amazon Bedrock 托管知识库(Managed Knowledge Bases)提供两个 API。我们在本文中简要讨论它们之间的差异。Retrieve API 执行一次混合搜索并返回带评分的文本块。AgenticRetrieveStream API 运行一个规划循环,并将步骤作为追踪事件流式返回给你。在 langchain-aws 包中,前者是一个标准的 LangChain 检索器,你可以直接将其放入链中;后者则是一个直接从知识库进行函数检索的工具。
下图展示了解决方案架构。应用程序通过 Retrieve API(标准、单次调用)或 AgenticRetrieveStream API(多步规划循环)查询 Amazon Bedrock 知识库。两条路径均从知识库返回文档块,应用程序随后利用这些内容生成基于事实的响应。
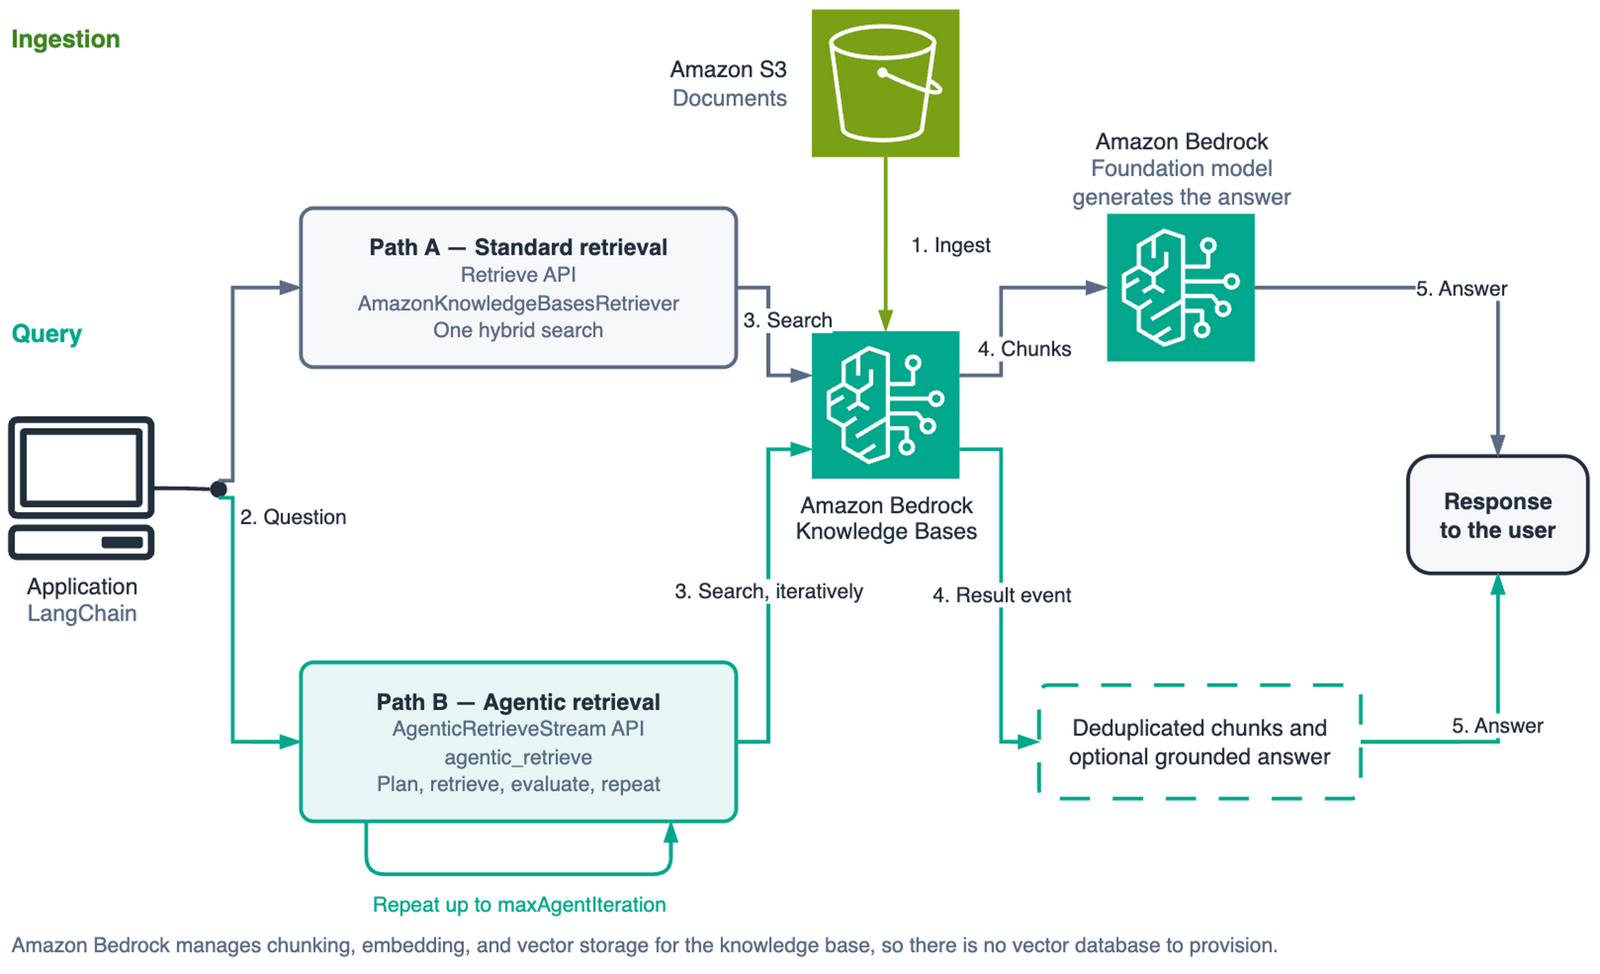
图 1:使用 Retrieve 和 AgenticRetrieveStream API 查询 Amazon Bedrock 知识库的解决方案架构
实施指南
以下章节将引导你完成创建知识库、使用两种检索方法进行查询,以及读取智能体规划器生成的追踪事件的全过程。
前提条件
要跟随本教程操作,你需要:
- 一个 AWS 账户,需具备在支持 Amazon Bedrock 托管知识库和智能体检索(agentic retrieval)的 Region 中访问 Amazon Bedrock 的权限。本演练使用美国东部(弗吉尼亚北部)Region(
us-east-1),代码中也全程假定使用该 Region。其他 Region 的可用性和支持情况请查阅 AWS 文档。 - 两个 AWS Identity and Access Management (IAM) 身份,详见下一节:一个是知识库所承担的服务角色(service role),另一个是你调用 API 时所使用的身份的权限配置。
- Python 3.12 或更高版本。
- 一个存放示例文档的 S3 存储桶。语料库需要包含若干涵盖重叠主题的文档,以便比较性问题有可检索的内容。单个扁平化文档无法演示查询规划(query planning)。
安装相关包。Boto3 的版本至关重要:agentic_retrieve_stream 在 1.43.32 之前的版本中并不存在。
langchain-aws>=1.6.3
langchain>=1.0
boto3>=1.43.32
权限
涉及两个身份,有意将它们分离开来是值得做的。知识库会承担一个服务角色来读取你的文档并调用嵌入模型。你的应用程序则使用 AWS Security Token Service (AWS STS) 的调用者身份进行查询。两者都不需要对方的权限。
如果你允许,Amazon Bedrock 会自动为你创建服务角色。若要提供自定义角色,请为其配置一个信任策略,允许 Amazon Bedrock 承担该角色。通过 aws:SourceAccount 和 aws:SourceArn 限定其作用范围,以防止其他账户将其用作混淆代理(confused deputy):
{
    "Version": "2012-10-17",
    "Statement": [{
        "Effect": "Allow",
        "Principal": {"Service": "bedrock.amazonaws.com"},
        "Action": "sts:AssumeRole",
        "Condition": {
            "StringEquals": {"aws:SourceAccount": "111122223333"},
            "ArnLike": {
                "aws:SourceArn": "arn:aws:bedrock:us-east-1:111122223333:knowledge-base/*"
            }
        }
    }]
}
服务角色还需要对你的存储桶拥有 s3:ListBucket 权限,以及对其内容拥有 s3:GetObject 权限,这两项权限均需以 aws:ResourceAccount 作为条件进行限制。在创建好具体的知识库后,请将 knowledge-base/* 通配符缩小到特定的知识库 ID。
AWS STS 调用者身份需要一组不同的权限。bedrock:AgenticRetrieveStream 和 bedrock:InvokeModelWithResponseStream 无法限定到知识库 Amazon Resource Name (ARN)。而 bedrock:Retrieve 和 bedrock:GetDocumentContent 则可以:
{
    "Version": "2012-10-17",
    "Statement": [
        {
            "Sid": "AgenticRetrievalAndPlannerModel",
            "Effect": "Allow",
            "Action": [
                "bedrock:AgenticRetrieveStream",
                "bedrock:InvokeModelWithResponseStream"
            ],
            "Resource": "*"
        },
        {
            "Sid": "RetrieveAndFullDocumentExpansion",
            "Effect": "Allow",
            "Action": ["bedrock:Retrieve", "bedrock:GetDocumentContent"],
            "Resource": "arn:aws:bedrock:<region>:111122223333:knowledge-base/<knowledge-base-id>"
        },
        {
            "Sid": "GenerateAnswersInTheChains",
            "Effect": "Allow",
            "Action": ["bedrock:InvokeModel", "bedrock:Converse", "bedrock:ConverseStream"],
            "Resource": "*"
        }
    ]
}
bedrock:GetDocumentContent 经常被忽视。当 FullDocumentExpansion(全文档扩展)步骤判定某个片段缺乏足够的上下文来回答问题时,智能体检索会调用此操作。仅包含 bedrock:Retrieve 的策略在规划器尝试获取整个文档之前都能正常工作,但随后会在查询过程中失败。
若要创建和管理知识库本身,调用角色还需要对 * 资源拥有 bedrock:CreateKnowledgeBase 权限,以及对 knowledge-base/* 资源拥有 GetKnowledgeBase、UpdateKnowledgeBase、DeleteKnowledgeBase、StartIngestionJob、GetIngestionJob 和 ListIngestionJobs 操作权限。如果你使用护栏(guardrails),请添加 bedrock:GetGuardrail 和 bedrock:ApplyGuardrail。
执行本指南可能会产生以下费用:知识库中的文档存储和数据摄取、检索调用以及基础模型(FM)推理。
完成实验后,请删除相关资源。
创建并填充知识库
使用 managedKnowledgeBaseConfiguration 创建知识库。将 embeddingModelType 设置为 MANAGED 可使用服务托管的嵌入模型。
import boto3
import os

REGION = os.environ["AWS_REGION"]
bedrock_agent = boto3.client("bedrock-agent", region_name=REGION)

response = bedrock_agent.create_knowledge_base(
    name=KB_NAME,
    roleArn=KB_ROLE_ARN,
    knowledgeBaseConfiguration={
        "type": "MANAGED",
        "managedKnowledgeBaseConfiguration": {
            "embeddingModelType": "MANAGED",
        },
    },
)
KB_ID = response["knowledgeBase"]["knowledgeBaseId"]
该请求中不包含 storageConfiguration。对于自管理知识库,你需要传入一个描述向量存储的配置。Amazon Bedrock 托管知识库不需要此配置,这是 API 中最明确的信号,表明 Amazon Bedrock 负责管理存储层。
将 S3 存储桶作为数据源附加,然后启动摄取(ingestion)任务。由于摄取是异步的,请轮询直到任务达到终止状态,而不是固定休眠一段时间并期望其完成。
import time

SUCCESS_STATES = frozenset({"COMPLETE"})
FAILURE_STATES = frozenset({"FAILED", "STOPPED"})

def wait_for_ingestion(kb_id, ds_id, job_id, timeout_s=1800):
    """Poll an ingestion job until it reaches a terminal state."""
    deadline = time.time() + timeout_s
    while time.time() < deadline:
        job = bedrock_agent.get_ingestion_job(
            knowledgeBaseId=kb_id,
            dataSourceId=ds_id,
            ingestionJobId=job_id,
        )["ingestionJob"]
        status = job["status"]
        if status in SUCCESS_STATES:
            return job
        if status in FAILURE_STATES:
            reasons = job.get("failureReasons") or ["no reason reported"]
            raise RuntimeError(f"Ingestion job {job_id} finished as {status}: " + "; ".join(reasons))
        time.sleep(15)
    raise TimeoutError(f"Ingestion job {job_id} did not finish in {timeout_s}s")
完整的数据源配置和错误处理示例可在 示例代码库 中找到。
使用 LangChain 检索器进行查询
AmazonKnowledgeBasesRetriever 封装了 Retrieve API,其行为与其他任何 LangChain 检索器一致。对于 Amazon Bedrock 托管知识库,请传递 managedSearchConfiguration。这一点容易让人困惑:vectorSearchConfiguration 是用于你自己运行向量存储的知识库的旧路径,也是大多数现有示例所展示的方式。
from langchain_aws.retrievers import AmazonKnowledgeBasesRetriever
SIMPLE_QUERY = "What is the restore time objective for the checkout service?"
retriever = AmazonKnowledgeBasesRetriever( knowledge_base_id=KB_ID, region_name=REGION, retrieval_config={ "managedSearchConfiguration": { "numberOfResults": 5, } }, ) docs = retriever.invoke(SIMPLE_QUERY)
每个结果都以 LangChain `Document` 的形式返回。相关性分数位于 `metadata["score"]` 中,源文档自身的元数据则位于 `metadata["source_metadata"]` 下,并经过重命名以避免冲突。如果你想丢弃低置信度的结果,请在检索器上设置 `min_score_confidence`,而不是在之后进行过滤。

对于意图单一的问题,这是合适的工具。它只需一次调用。其延迟是两种选项中最低的,并且你完全掌控答案的生成方式。生产环境中的助手所处理的大多数查询都是这种形式,为这类问题使用规划循环(planning loop)只会浪费金钱和时间。

## 单次检索的局限性

现在让同一个检索器处理一个包含多个部分的问题:
COMPLEX_QUERY = ( "Compare the checkout and inventory services across on-call escalation, backup and " "restore targets, and deployment rollback procedure. Where do they differ?" )
docs = retriever.invoke(COMPLEX_QUERY)
系统会返回五个片段,这些片段是根据整个问题的单个嵌入向量通过混合评分进行排序的。

该问题包含六个意图:两个服务在三个维度上的对比。对检索到的文本针对每个意图的证据进行评分,可以具体衡量单个嵌入向量所能恢复的内容。

| **numberOfResults** | **片段数** | **占语料库比例** | **覆盖的子意图** | **缺失项** |
| --- | --- | --- | --- | --- |
| 5 | 5 | 10% | 6 个中的 4 个 | checkout 值班响应、inventory 恢复目标 |
| 10 | 10 | 19% | 6 个中的 6 个 | 无 |

在返回五个结果时,代表六个意图的单个嵌入向量漏掉了其中两个。当返回十个结果时,它覆盖了全部六个意图,但也存在明显的浪费:两个子意图被重复覆盖,且有一个片段未包含任何相关信息。

检索器完成了它的任务。局限性在于结构本身:一个向量无法表示六个意图,而且流程中没有步骤来询问返回的证据是否足以回答问题。

## 运行智能体检索

Agentic 检索并非 LangChain 的 retriever,而是 Amazon Bedrock Managed Knowledge Bases(托管知识库)的一项功能。`langchain-aws` 包将其作为独立函数 [agentic_retrieve](https://python.langchain.com/api_reference/aws/retrievers/langchain_aws.retrievers.bedrock.html) 暴露出来,因为底层 API 以流式方式返回结果,不符合同步的 `BaseRetriever` 接口。`AmazonKnowledgeBasesRetriever` 上没有开关此功能的标志位。
from langchain_aws.retrievers.bedrock import agentic_retrieve
result = agentic_retrieve( knowledge_base_id=KB_ID, query=COMPLEX_QUERY, region_name=REGION, generate_response=True, number_of_results=10, ) print(result["generatedResponse"]["answer"])
当设置 `generate_response=True` 时,服务会在返回检索到的文本块的同时,返回一个基于证据的答案和引用来源,因此你无需单独配置模型调用即可获得答案。该函数仅适用于 Amazon Bedrock Managed Knowledge Base。

在内部,服务会进行规划、检索、评估证据是否充分,并在不充分时进行迭代。这个辅助函数隐藏了所有这些细节,直接返回最终的文本块,这虽然方便,但也意味着你无法看到其规划过程。

## 读取追踪事件

若要观察模型如何分解问题,请直接调用 [bedrock-agent-runtime](https://docs.aws.amazon.com/boto3/latest/reference/services/bedrock-agent-runtime.html) 客户端上的 [agentic_retrieve_stream](https://docs.aws.amazon.com/boto3/latest/reference/services/bedrock-agent-runtime/client/agentic_retrieve_stream.html)。这是本指南中唯一一处绕过 `langchain-aws` 的地方,因为上述辅助函数会丢弃追踪事件,且不暴露 `maxAgentIteration` 或自定义规划器模型等参数。
runtime = boto3.client("bedrock-agent-runtime", region_name=REGION)
response = runtime.agentic_retrieve_stream( messages=[{"role": "user", "content": {"text": COMPLEX_QUERY}}], retrievers=[{ "configuration": { "knowledgeBase": { "knowledgeBaseId": KB_ID, "retrievalOverrides": {"maxNumberOfResults": 10}, } } }], agenticRetrieveConfiguration={ "foundationModelType": "MANAGED", "rerankingModelType": "MANAGED", # 5 is the API default. Below 4 the planner stops decomposing entirely. "maxAgentIteration": 5, }, generateResponse=False, )
for event in response["stream"]:
    if "traceEvent" in event:
        attrs = event["traceEvent"]["attributes"]
        print(f"{attrs.get('step')}: {attrs.get('status')}")
        for action in attrs.get("actions", []) or []:
            if "retrieve" in action:
                query = action["retrieve"].get("inputQuery", {}).get("text", "")
                print(f" sub-query: {query}")
    elif "result" in event:
        for chunk in event["result"].get("results", []):
            print(chunk.get("content", {}).get("text", "")[:120])
如果你只需要检索行为,请将 generateResponse 设置为 False。默认情况下,API 会生成一个基于证据的回答,这会产生一次额外的模型调用;而在你检查规划过程时,可能并不需要这次调用。
跟踪事件中的 step 字段指示了规划器当前所处的阶段。SpeculativeRetrieval(推测性检索)在首次规划之前运行,旨在降低延迟,且不占用你的迭代预算。Planning(规划)阶段是模型读取问题及先前结果并生成子查询的地方。Retrieval(检索)针对每个子查询触发一次。当模型判断某个片段缺乏回答所需的上下文时,会出现 FullDocumentExpansion(全文档扩展),此时系统会拉取整个文档而非仅片段。每个步骤都附带一个状态值:IN_PROGRESS、SUCCEEDED 或 FAILED,以及一条人类可读的消息。
最终的文本块单独到达。result 是一种独立的事件类型,而非第五个步骤,它包含了来自所有迭代的去重后的文本块,以及在启用响应生成时得到的基于证据的回答。请根据事件键进行分支处理,如前面的循环所示,而不要期望出现一个终止性的步骤值。
子查询文本是最值得记录的部分。它位于 attributes.actions[].retrieve.inputQuery.text,而不是顶层的跟踪字段中。因此,如果处理程序只读取 step 和 status,你只能看到规划发生了,却无法知道具体决定了什么。
下图展示了智能体检索规划循环,包括推测性检索、规划、子查询检索、评估以及可选的重新规划步骤。
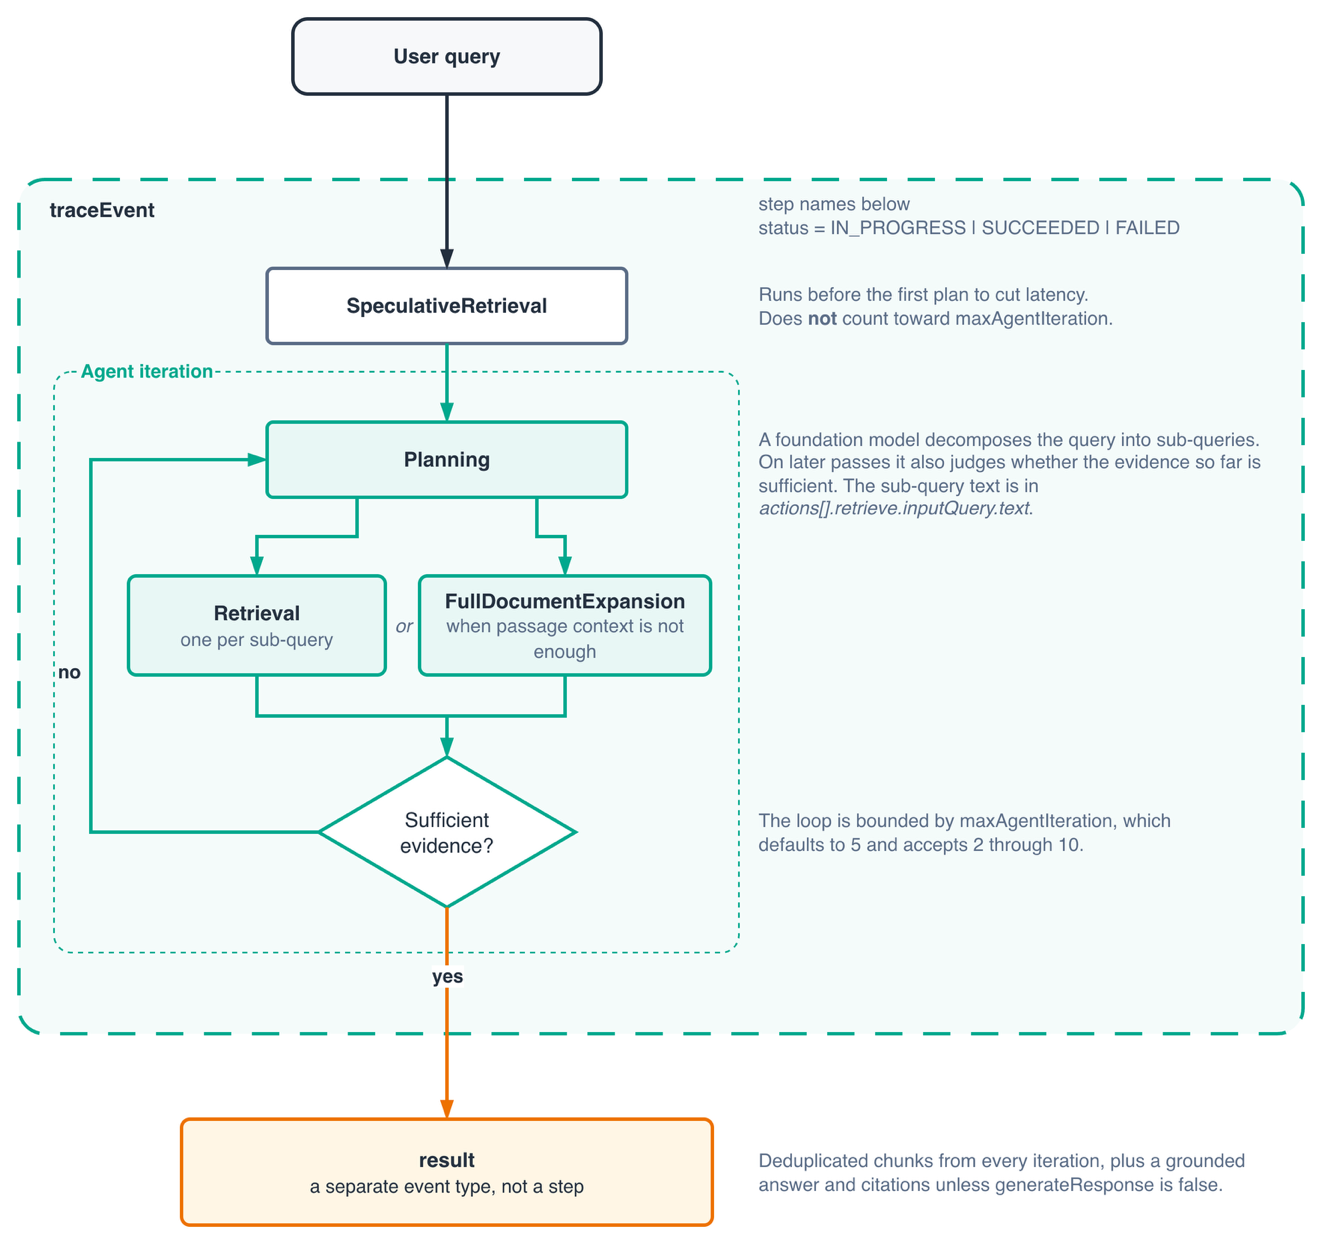
图 2:智能体检索规划循环中的步骤
在基于此构建之前,有两个细节值得注意。去重仅适用于 result 事件,因此由三个子查询检索到的同一个数据块(chunk)在最终结果中只出现一次,但在追踪记录(traces)中会出现三次。
第二点关于评分。Retrieve API 的响应会为每个数据块提供一个类型化的 score 字段,表示其与查询的相关性。而 Agentic retrieval 的结果包含 content、metadata 和 sourceRetriever,但没有对应的类型化评分字段。如果在切换 API 后代码仍尝试读取 result["score"],将获取不到任何内容。如果你需要对相关性进行排序或过滤,请预先考虑这一差异。
在生产环境中,使用 Amazon Bedrock Guardrails 对生成的响应强制执行内容策略和事实核查(grounding checks)。两条检索路径都支持 guardrails。Agentic retrieval 通过 policyConfiguration.bedrockGuardrailConfiguration 支持 guardrails,而不是 LangChain retriever 所接受的 guardrail_config 参数,并且仅支持 BLOCK 模式。如果你依赖 MASK 模式,那么这就是继续使用 Retrieve API 的理由。
maxAgentIteration 接受 2 到 10 之间的值,默认为 5。建议保持默认值。如果设置为 2 或 3,规划器(planner)只会运行一个周期,不会发出子查询,并返回推测性检索步骤已经找到的内容。这相当于以 agentic 的成本实现单次执行(single-shot)行为。从 4 开始才会进行分解。当规划器判断证据充分时,通常会提前停止,因此该上限是一个约束边界而非目标值。
比较两条检索路径
为了了解其在大规模场景下的表现,AWS 在 MuSiQue(一个公开的多跳基准测试)上评估了 agentic retrieval。评估结果显示,与单次检索相比,召回率有所提升,且在最难的问题上增益最大。单跳问题的增益低于五个百分点。最后这个数据符合权衡关系的特征:只有当存在可分解的内容时,分解才有用。
构建 RAG 链
对于标准检索器,通常的 LangChain Expression Language (LCEL) 组合可以直接使用:
from langchain_aws import ChatBedrockConverse
from langchain_core.output_parsers import StrOutputParser
from langchain_core.prompts import ChatPromptTemplate
from langchain_core.runnables import RunnablePassthrough

def format_docs(docs):
    return "\n\n".join(doc.page_content for doc in docs)

llm = ChatBedrockConverse(model=MODEL_ID, region_name=REGION)
prompt = ChatPromptTemplate.from_template(PROMPT_TEMPLATE)

chain = (
    {"context": retriever | format_docs, "question": RunnablePassthrough()}
    | prompt
    | llm
    | StrOutputParser()
)
format_docs 的作用比表面看起来更重要。如果直接将 Document 对象传入提示词,会渲染其 repr,导致模型在上下文中混入元数据噪声。
为了将 agentic retrieval(智能体检索)置于相同的位置,需要将其包装在 RunnableLambda 中,因为它是一个函数而非 retriever:
from langchain_core.runnables import RunnableLambda

def agentic_context(question: str) -> str:
    result = agentic_retrieve(
        knowledge_base_id=KB_ID,
        query=question,
        region_name=REGION,
        number_of_results=10,
    )
    return "\n\n".join(
        item.get("content", {}).get("text", "")
        for item in result.get("results", [])
    )

agentic_chain = (
    {"context": RunnableLambda(agentic_context), "question": RunnablePassthrough()}
    | prompt
    | llm
    | StrOutputParser()
)
请注意,此处未启用 generate_response。该服务本身可以生成答案,但在链式调用中,通常希望使用自己的提示词和模型,因此我们获取检索到的文本块并在下游进行生成。如果你希望减少代码量且只需一次调用,可以使用服务端的生成功能;如果你需要完全控制提示词,则应使用上述包装后的版本。
在标准检索与智能体检索之间进行选择
对于简短、范围明确的问题,请使用 Retrieve。它成本更低、速度更快,支持针对自管理知识库运行,并在结果中返回评分。大多数生产流量都属于此类情况。
当问题涉及多个部分、比较性或探索性内容,或者证据跨越多个知识库时,请使用 AgenticRetrieveStream。它可以在单个请求中注册最多五个知识库,并使用你附加到每个知识库的自然语言描述来路由子查询。另一个 API 完全无法做到这一点。它的每次调用成本更高,需要进行多次模型推理,并且具有两者中较高的延迟。
我们推荐的模式是根据查询形态进行路由,而不是对所有情况采用单一方案。通过分类器或对问题进行启发式判断,可以将大部分流量导向低成本路径,并将规划器保留给真正需要它的问题。
清理资源
删除知识库、其数据源、S3 对象和存储桶,以及你创建的 IAM 角色。包含文档的知识库会继续产生存储费用。
bedrock_agent.delete_data_source(knowledgeBaseId=KB_ID, dataSourceId=DS_ID)
bedrock_agent.delete_knowledge_base(knowledgeBaseId=KB_ID)代码仓库中包含一个清理脚本,该脚本还会清空存储桶并移除角色。
结论
我们展示了如何基于 Amazon Bedrock Knowledge Bases 和 LangChain 构建 RAG 应用,以及 agentic retrieval(智能体检索)如何处理单次检索难以有效回答的多部分问题。我们还指出了当前集成中存在的摩擦点。Agentic retrieval 是一个函数而非 LangChain retriever,因此需要借助 RunnableLambda 将其嵌入到 chain 中。而展示查询计划的 trace events 则需要直接调用 boto3。
Agentic retrieval 以更高的单次调用成本为代价,换取在多跳问题上更好的召回率,并使用内置模型进行查询规划。下一步更有价值的做法是:在将所有请求都路由给 planner 之前,先测量你自己的查询组合特征。
如需入门,请参阅 Amazon Bedrock Knowledge Bases 文档及配套示例代码。若需将此方案应用于你的具体工作负载,请联系你的 AWS 客户团队获取支持。