Thinking Machines 发布 Inkling 2 Mini 循环层模型
Thinking Machines 发布多模态 MoE 模型 Inkling 2 Mini,总参数 26B、激活参数 3.5B,支持最高 100 万 token 上下文,并内置 DSpark 推测器。其核心创新在于中间 12 层以共享权重循环执行三次,每轮保留独立 KV 缓存并读取上一轮的门控消息。vLLM 在 NVIDIA Blackwell、Hopper 与 DGX Spark 上实现 Day-0 支持。
报道正文
本文目录7 个章节
vLLM 上的 Inkling 2 Mini:对循环模型的 Day-0 支持
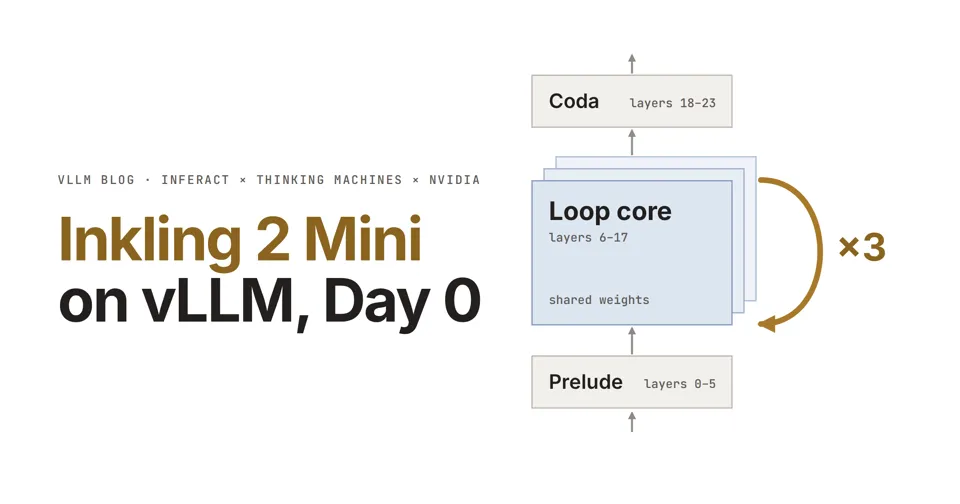
Thinking Machines 今天发布了 Inkling 2 Mini。vLLM 在 Day 0 即支持该模型及其可变循环研究检查点 TML-d24-varloop-research,支持平台包括 NVIDIA Blackwell、Hopper 和 DGX Spark。Inkling 2 Mini 是一个循环模型:其中间 12 层对每个 token 运行三次,权重共享,每次传递都有各自的 KV cache,并从前一次传递接收门控消息。它是一个多模态 MoE,总参数 26B、激活参数 3.5B,上下文长度最高 1M token,并内置原生 DSpark 推测器。
TL;DR
- 循环层。 第 6–17 层以共享权重运行三次传递。每次传递保留自己的 KV cache,并读取前一次传递的门控消息。
- 总参数 26B、激活参数 3.5B、1M 上下文、原生 DSpark。 一个由 Inkling 2 Small 组件构建的多模态 MoE,采用 NVFP4 专家(最后 4 层为 MXFP8)和原生 DSpark 推测器。
- 在 Blackwell、Hopper 和 DGX Spark 上的优化 Day-0 支持。 vLLM 像管理其他缓存层一样管理每次传递的缓存,融合消息读取和控制器,并复用 Inkling 2 Small 的融合 kernel。
- RL 支持。 vLLM 通过 SkyRL 为强化学习提供 Inkling 2 Mini 服务。
- 可变循环研究检查点。 vLLM 还支持 TML-d24-varloop-research,你可以在启动时选择传递次数,以及各次传递是否共享一个 KV cache。
我们提供了支持 Inkling 2 Mini 的 Docker 镜像 vllm/vllm-openai:inkling-2-mini。你可以用以下命令启动模型服务:
docker run --gpus all --ipc=host -p 8000:8000 \
  -v ~/.cache/huggingface:/root/.cache/huggingface \
  vllm/vllm-openai:inkling-2-mini thinkingmachines/Inkling-2-Mini \
  --reasoning-parser inkling --tool-call-parser inkling --enable-auto-tool-choice \
  --speculative-config '{"method":"dspark","num_speculative_tokens":7,"draft_sample_method":"probabilistic"}'
以及可变循环研究检查点,此处为 2 次传递,且各次传递共享一个 KV cache:
docker run --gpus all --ipc=host -p 8000:8000 \
  -v ~/.cache/huggingface:/root/.cache/huggingface \
  vllm/vllm-openai:inkling-2-mini thinkingmachines/TML-d24-varloop-research \
  --reasoning-parser inkling --tool-call-parser inkling --enable-auto-tool-choice \
  --hf-overrides '{"text_config": {"loop_num_passes": 2, "loop_share_cache": true}}'
循环
图 1。前奏与尾声各运行一次;循环核心运行三遍,每一遍都从前一遍读取消息。
前奏、核心、尾声。 24 层被划分为前奏(第 0–5 层)、循环核心(第 6–17 层)和尾声(第 18–23 层)。前奏和尾声各运行一次;核心以共享权重运行三遍,尾声从最后一遍继续。每六层为一组,构成 Inkling 2 Small 中所用块注意力残差的一个块,因此核心的一遍恰好产生两个块。
每一遍都从前奏的输出开始。 普通的循环模型会将第 p 遍的输出送入第 p + 1 遍。而在这里,三遍都从同一个输出开始,第 p + 1 遍仅通过消息看到第 p 遍。
每个子层都会读取消息。 从第二遍开始,每个核心子层的输入(注意力的 query、key 和 value 输入以及 MLP 输入)都会获得各自的消息,这些消息通过注意力残差读取从前一遍的两个块中读取,每层和每种输入类型都有一个学习得到的 query。随后,一个 rank-64 控制器按通道将消息合并到输入中:
h   = W_down · [rms(input), rms(message)]
out = (1 − tanh(W_forget · h)) · input + tanh(W_gain · h) · message
核心有 12 层、每层 4 个输入,因此之后的每一遍每个 token 都会读取 48 条消息。由于 query、key 和 value 输入获得不同的消息,滑动窗口层在第一遍中从同一个输入投影出这三者,而在后续遍中则采用三个独立的输入。
每一遍都保留自己的记忆。 每个核心层在每一遍中都有各自的 KV cache 和 conv-state cache,因此第 p 遍会关注第 p 遍为更早的 token 计算出的 key 和 value。该模型有 24 层,但有 48 个 KV cache 和 48 个 conv-state cache。
来自循环内部的 DSpark 草稿。 3 层的 DSpark 草稿在四次层访问中读取目标的隐藏状态:一次在前奏中,第二遍和第三遍各一次,以及最终输出。
各层本身沿用 Inkling 2 Small 的设计。 每一层都在隐藏维度 2,304 下使用 Inkling 2 Small 的组件:块注意力残差、带门控与 sink 的相对偏置注意力(20 个滑动窗口层和 4 个全注意力层,24 个查询头和 8 个 KV 头)、短卷积,以及 NVFP4(第 0–19 层)和 MXFP8(第 20–23 层)中的 128 个路由专家(top-8)。图像经过一个 23 层 ViT 编码器,其配置与 Inkling 2 Small 的相同。
在 vLLM 中服务该循环
将每轮传递的缓存作为常规缓存层。 vLLM 将核心层的每一轮额外传递注册为独立的注意力层,各自拥有自己的 KV 缓存和卷积状态缓存。KV 缓存管理器和前缀缓存将这些缓存与其他缓存同等对待,因此服务该循环无需新的缓存管理逻辑。
融合的消息读取与控制器。 直接实现会在后续每一轮传递中,为每个核心层启动 4 次消息读取和 4 个控制器,每个都包含多个 kernel。vLLM 在一个注意力残差 kernel 中读取一层的全部四条消息,并堆叠四个控制器的权重,使其 down 投影和 gain/forget 投影以批量 GEMM 方式运行。一个 Triton kernel 计算控制器的 RMS 归一化,另一个 kernel 将门控合并与消息所馈入子层的 RMSNorm 融合。合并在 FP32 下运行且不进行 FMA 收缩,与参考实现一致。
围绕每个子层的融合 kernel。 对于 Inkling 2 Small,vLLM 将每个子层的 all-reduce、短卷积、残差更新、注意力残差混合和 RMSNorm 融合为一个 kernel。vLLM 将这些 kernel 从隐藏维度 4,608 推广到 2,304,并新增一种模式,在 RMSNorm 之前返回 FP32 混合结果,以便后续传递将其消息合并进去。Inkling 2 Mini 在所有张量并行规模下都使用这些 kernel,包括 TP1;在 TP > 1 时,小批量还会通过 NVLink 组播融合 all-reduce。
可变循环研究检查点
Thinking Machines 还发布了 TML-d24-varloop-research,这是一个经过训练、可以以可变传递次数运行的研究检查点。vLLM 通过 --hf-overrides 暴露其两个选项:
docker run --gpus all --ipc=host -p 8000:8000 \
  -v ~/.cache/huggingface:/root/.cache/huggingface \
  vllm/vllm-openai:inkling-2-mini thinkingmachines/TML-d24-varloop-research \
  --reasoning-parser inkling --tool-call-parser inkling --enable-auto-tool-choice \
--hf-overrides '{"text_config": {"loop_num_passes": 2, "loop_share_cache": true}}'loop_num_passes设置遍历次数(至少为 1;默认值为检查点自带的 3)。遍历次数越少速度越快;遍历次数越多质量越高。DSpark 要求使用默认值,因为 draft 读取的是固定的层访问次数。loop_share_cache让核心层的所有遍历共享同一份 KV cache:每次遍历都会覆盖其 token 的键和值,因此后续 token 读取的是最后一次遍历的键和值。Conv 状态则按遍历分别保留。
这两个选项在 Inkling 2 Mini 等固定循环检查点上都会被拒绝。在一台 GB200 上(TP1、4K 上下文、仅前向传播):
| Passes | Decode step, batch 1 | Decode step, batch 32 | KV cache capacity |
|---|---|---|---|
| 1 | 1.51 ms | 3.81 ms | 352K tokens |
| 2 | 2.67 ms | 5.92 ms | 233K tokens |
| 3 | 3.85 ms | 8.11 ms | 175K tokens |
| 3, shared KV cache | 3.86 ms | 8.10 ms | 194K tokens |
共享 KV cache 节省的内存少于丢弃一次 pass,因为每次 pass 的 conv-state 缓存仍然保留。
准确性评估
vLLM 保持了参考实现的数值特性:每一步使用相同的数据类型、相同的 NVFP4 和 MXFP8 激活量化,以及 FP32 消息合并,仅归约顺序有所不同。在固定 prompt 上,vLLM 在 48 层中每一层的隐藏状态与参考实现的差异,大致相当于参考实现自身的 FlashAttention-4 与 PyTorch attention 路径之间的差异;而在给定相同输入时,MoE 输出逐位一致。
在端到端测试中,我们使用 inkling-verify 在最高 1M token 的 needle-in-a-haystack、MMMU-Pro 和 HLE 上测试了准确性,并在启用 DSpark 的情况下测试了 GSM8K。
致谢
我们感谢 Thinking Machines 和 NVIDIA 团队在 vLLM 中集成和优化 Inkling 2 Mini 过程中的紧密合作。