REINFORCE Zero 实现零内核失配异步强化学习
研究团队提出将异步强化学习的性能损失拆解为权重滞后与内核失配两部分,指出内核失配无法被重要性采样修正,必须对齐 rollout 与训练内核。对齐后,无裁剪重要性采样即可稳定训练 20000 步、支持策略滞后 64,训练吞吐达同步训练的 2.40 倍,并已覆盖 DeepSeek-V4.1-Flash、Kimi K3.1 及 AMD MI355X。
报道正文
本文目录17 个章节
零失配,简单异步 RL:REINFORCE Zero、DeepSeek-V4.1 与 Kimi K3.1
TL;DR
- 异步 RL 速度更快,但它训练所用的样本是由旧权重生成的。
- rollout 与 learner 之间的差距由两部分组成。权重滞后变化平滑,未裁剪的重要性采样(IS)可以控制它。内核失配——即 rollout 与训练对相同权重计算出不同数值——则会波动,并且尽管有 IS 仍然持续存在。
- 对齐内核后,未裁剪的 IS 无需样本拒绝门控即可修正剩余的权重滞后。REINFORCE Zero(NVIDIA Research 与 Inferact)稳定训练了 20,000 次更新,在策略滞后 64 下仍能学习,并在内核对齐的情况下达到同步训练训练步吞吐量的 2.40×。
- 零失配现已覆盖 DeepSeek-V4.1-Flash(DAPO rollout 步与快速基线的差距在 10% 以内)、第 0 天的 Kimi K3.1,以及 AMD MI355X 上的 DeepSeek-V4-Flash 和 Kimi K3.1。
- 所有内容都在 Inferact/zero-mismatch-rl。
1. 从同步到异步
上个月,我们展示了 rollout 与训练可以完全一致。在 DeepSeek-V4-Flash 上,vLLM 与训练器在快速内核上对每个采样 token 产生的 logprob 逐位完全相同,rollout 吞吐量仅下降 8.7%。现在有一个 agent skill 可以为每个新模型完成对齐。
那篇文章讲的是同步 RL,它没有权重滞后,因此零失配消除了 rollout 与训练之间唯一的差距。本文讲的是异步 RL,它速度更快,但按设计就是离策略的。那么零失配在那里还重要吗?
我们用 NVIDIA Research 与 Inferact(Jian Hu 等)的一篇新论文来回答:REINFORCE Zero: Kernel Alignment Unlocks Stable Asynchronous RL with Importance Sampling。第 2 至第 4 节中的所有数字均来自该论文。
2. 异步 RL:更快,但离策略
在同步 RL 中,rollout 与训练轮流进行,彼此等待。异步 RL 则同时运行二者:rollout 持续生成,而 learner 同时更新。
代价是权重滞后。用权重版本 v 生成的样本会在版本 k > v 上训练。这个差距 k − v 并不小:REINFORCE Zero 在数学推理上以滞后 2 和 8 运行,在 agentic 工具使用上以滞后 64 运行。
因此,学习器始终在来自较旧策略的样本上进行训练。标准的修正方法是重要性采样(IS):用 π / μ 对每个 token 重新加权,即学习器对该 token 的概率除以 rollout 在采样时记录的概率。问题在于,这种修正能否覆盖全部差距。
3. 两种表现不同的差距
学习器与 rollout 之间的 logprob 差距可拆分为两项:
log π_θk − log μ_v  =  (log π_θk − log π_θv)  +  (log π_θv − log μ_v)
                        权重滞后                内核不匹配
π 是学习器的计算结果,μ 是 rollout 引擎的计算结果。第二项是在相同权重 θv 下对两者进行比较。
权重滞后平滑变化。 它会在最近若干次更新上逐层累积,当每次更新幅度较小时,它遵循一条平滑变化的策略轨迹。这正是 IS 旨在修正的差距。
内核不匹配则波动不定。 它取决于批次组成和数值执行,因此即使 rollout 与学习器使用完全相同的权重,也会引入波动。
图 1:重要性权重偏差 D3 的峰值与中位数之比(对数刻度),基于 DeepSeek-R1-Distill-Qwen-1.5B 上的两次异步运行:内核对齐的 REINFORCE Zero 与使用标准内核的 IS。来源:REINFORCE Zero,表 2。
REINFORCE Zero 论文用 D3 来衡量这一偏差,D3 是每次更新中对所有 token 求 w − 1 − log w 的平均值,其中 w 是重要性权重。当 w = 1 时,每个 token 的该项为 0,并随着 w 偏离 1 而增大。在内核对齐的情况下,D3 的峰值仅为其中位数的 1.50 倍:未截断的 IS 使剩余的权重滞后不匹配保持平滑且受控。而在使用标准内核时,峰值达到中位数的 442.54 倍:尽管使用了 IS,大幅的重要性权重波动依然存在。
因此,先消除内核项。 剩下的就是权重滞后,而普通的未截断 IS 就能修正它,无需截断,也无需拒绝门控。
4. REINFORCE Zero
REINFORCE Zero 是由第 3 节推导出的方案。它包含三个部分。
方案
- 对齐 kernel。 rollout 与 learner 对相同的权重和 token 计算相同的 logprob,正如我们上一篇文章所述。kernel 项恰好为 0,因此剩下的任何差距都是权重滞后造成的。
- 用 token 级 IS 校正权重滞后,不做截断。 rollout 已经记录了它采样的每个 token 的 logprob。learner 用自己的概率除以记录的概率,并直接使用该比值:不截断,不过滤。
- 优化朴素的 REINFORCE。 每个响应的优势是其奖励减去其所在组的平均奖励。token 在响应内取平均。没有价值模型,没有拒绝门控。
对于一批 B 个响应,设 A_i 为响应 i 的优势:
L(θ) = − (1/B) Σ_i (1/T_i) Σ_t A_i · π_θ(a_it | h_it) / μ_i(a_it | h_it)这就是整个算法。
为什么用不截断的 IS
在固定历史下,用精确比值 w = π / μ 对每个采样 token 加权,可使期望更新等于当前策略下的更新。对权重做截断通常会引入偏差。
正确的平均梯度并不足以保证训练稳定。在一个高斯模型中,论文推导了精确的更新误差,并表明这种不匹配会放大更新方差、收窄稳定步长范围,即使在无偏 IS 下也是如此:相同的步长在没有不匹配时能正常学习,而存在不匹配时则会损失奖励。实验指出 kernel 不匹配是大偏差的来源(图 1),因此消除它正是让不截断 IS 保持稳定的关键。
不对齐会发生什么
论文用标准 kernel 运行相同的异步 IS:
- 在最初和最后 1,000 次更新之间,rollout 到 learner 的 KL 中位数上升了 83.33×,在线 AIME24 pass@1 从 34.27% 下降到 13.96%。而对齐 kernel 后则保持平稳。
- 截断前的最大梯度范数达到 38.27,而对齐 kernel 后为 0.0555。
- 加入序列门控可以稳定训练,但到最后的 1,000 次更新时,它会拒绝 24.48% 的序列。REINFORCE Zero 则一个都不拒绝。
在滞后 64 下学习
论文将滞后推到 64。使用 Qwen3-4B、Python 工具和 16K 上下文,REINFORCE Zero 在策略滞后 64 下训练:一个样本可能来自比 learner 旧多达 64 个版本的权重。它在 5,000 次更新中持续学习:平均奖励从最初 100 次更新的 0.287 上升到约 0.78,AIME24/25/26 pass@1 在同一次运行中也有所提升。
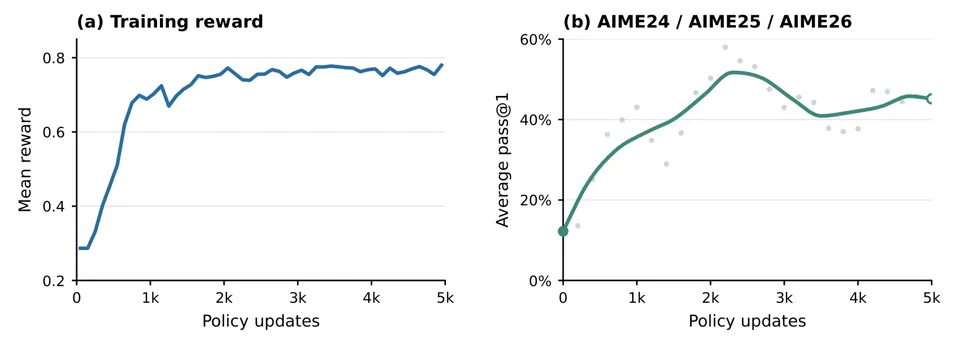
REINFORCE Zero 在滞后 64 下的表现:训练奖励与 AIME pass@1
图 2(REINFORCE Zero,图 6):使用 Qwen3-4B 和 Python 工具,在滞后 64 下经过 5,000 次更新进行学习。左图:训练奖励,100 次更新的均值。右图:在 200 次更新的检查点上的等权重 AIME24/25/26 pass@1(点)及平滑趋势(曲线)。
结果
| 设置 | 结果 |
|---|---|
| 吞吐量,16 块 GPU,12K 次更新 | 在 kernel 对齐的情况下,训练步吞吐量达到同步训练的 2.40×(68.55 小时 vs 164.77 小时),质量相当 |
| 20K 次更新的推理任务,DeepSeek-R1-Distill-Qwen-1.5B | 在 lag 2 和 8 下保持稳定;rollout 到 learner 的 KL 保持平稳 |
| 高 lag,Qwen3-4B + Python 工具 | 在 lag 64 下经过 5,000 次更新仍能学习;平均奖励 0.287 → 约 0.78 |
| 带工具的 MoE,Qwen3-30B-A3B | 在 3,000 次更新中,宏平均 pass@1 从 31.29% → 71.55% |
| 计算机使用,Nemotron-3-Nano-Omni-30B 在 OSWorld 上 | 经过 428 次更新后,Pass@1 从 50.97% → 56.16% |
在 6,000 次更新时的 1.5B 推理任务上,各变体的表现与分析预测一致:
| 配方 | 对齐内核 | 异步 | 宏平均 pass@1 |
|---|---|---|---|
| 基础模型 | — | — | 40.29% |
| 同步 | ✓ | ||
| 48.91% | |||
| IS | |||
| ✓ | 45.32% | ||
| IS + 序列门控 | |||
| ✓ | 46.79% | ||
| IS + token 门控 | |||
| ✓ | 44.59% | ||
| 分数居中,无 IS | ✓ | ✓ | 47.50% |
| REINFORCE Zero,滞后 2 | ✓ | ✓ | 48.80% |
| REINFORCE Zero,滞后 8 | ✓ | ✓ | 48.53% |
异步 REINFORCE Zero 与同步训练效果相当。所有标准内核变体都落后,无论采用哪种修正方式;在使用对齐内核的情况下,不带 IS 的 Score Centering 介于两者之间。
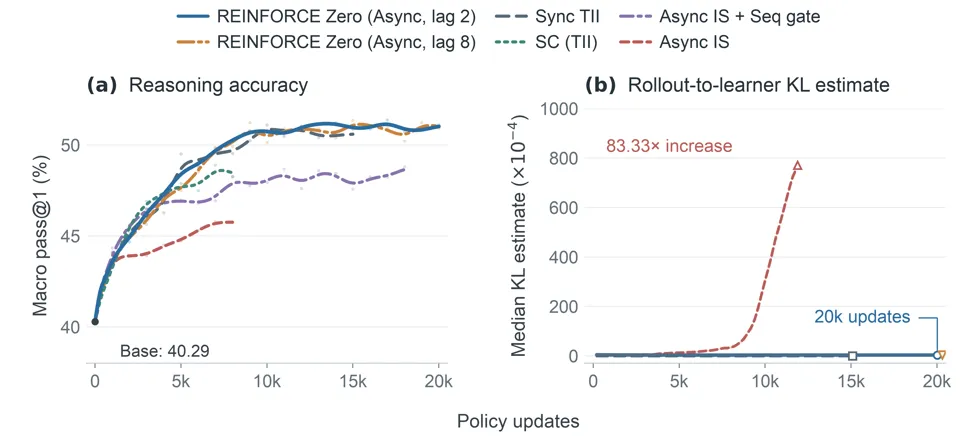
REINFORCE Zero:推理准确率与 rollout 到 learner 的 KL
图 3(REINFORCE Zero,图 1)。左:宏观 pass@1。右:rollout 到 learner 的 KL。标准内核 IS 向上漂移;REINFORCE Zero 在 20,000 次更新中保持平稳。
对齐在这里的代价
对齐内核比最快的标准内核更慢。在 OSWorld 上,REINFORCE Zero 的平均步耗时为 944.25 秒,而带序列门控的标准内核 IS 为 884.17 秒,高出 6.8%。论文中的模型使用我们上一篇博文中的 agent skill 进行对齐;训练代码位于 NVIDIA-NeMo/labs-molt。
5. 旗舰模型:DeepSeek-V4.1 和 Kimi K3.1
REINFORCE Zero 从对齐内核出发,而每个新模型都会带来需要对齐的新算子。自上一篇博文以来,有两个旗舰版本实现了零不匹配:DeepSeek-V4.1-Flash,以及发布当天的 Kimi K3.1。以下运行验证了这些模型上的对齐;在这些模型上进行长时间异步运行是下一步工作。
贯穿全文,diff 0 意味着 rollout 和 trainer 对每个采样 token 计算出的 logprob 逐位完全相同。
DeepSeek-V4.1-Flash,保持发布精度
一致路径端到端保持发布精度:FP8 和 MXFP4 权重、MegaMoE、带滑动窗口的稀疏注意力,以及 DSpark 投机解码,并配合 CUDA graphs。Megatron-LM trainer(mLite,由 NVIDIA DevTech 的 Yan Bai 开发)按相同顺序调用 rollout 自身的内核。关键算子是在前缀缓存下的滑动窗口:agentic RL 需要开启前缀缓存,而缓存命中必须给出与未命中相同的 logprob。
在 16 节点 × 4 GB200 上,128K 上下文的 SWE-bench Pro agentic RL 在每一步都保持 diff 0。对于 DAPO 数学 rollout,每节点 128 条轨迹、响应最长 8K token,一致 rollout 步耗时保持在快速基线的 10% 以内。
Kimi K3.1,第 0 天
Kimi K3.1 发布,day-0 vLLM 支持,并包含零失配 RL。难点在于 KDA 线性注意力:prefill 逐块计算,decode 逐 token 计算,两者的舍入方式不同。现在 decode 对同一 chunk 行重复 prefill 的算术,因此 prefill、decode 和训练器三者结果一致,无论是基础模型还是每个模块上的 LoRA 适配器。在 4 节点 × 4 GB300 上,使用 LoRA 的 100 步 DAPO 训练保持 diff 为 0,AIME 24/25/26 mean@8 从 0.451 升至 0.664。性能优化仍在进行中。
6. 超越 NVIDIA:AMD MI355X
零失配是内核的属性,而非某一厂商的属性。在 MI355X 上,与在 NVIDIA 上一样,训练器的前向调用 vLLM 自身的模块和内核,VLLM_BATCH_INVARIANT 在一致版本和快速版本之间切换。
7. 开源
REINFORCE Zero:论文和代码见 hijkzzz/REINFORCE-Zero,训练代码见 NVIDIA-NeMo/labs-molt。
零失配:Inferact/zero-mismatch-rl 包含 agent skill,以及本文中每个模型的配方、遇到的问题、修复方式及代码。
下一步:在这些大模型上进行长时间异步运行,以及对 Kimi K3.1 进行性能优化。
致谢
感谢(按组织字母顺序):
- Verda,为 SWE-bench Pro agentic RL 运行提供沙箱
- verl 团队