Interconnects 发布开源模型经济仪表盘 量化推理市场数据
Interconnects 推出开源模型采用与性能聚合仪表盘,旨在解决当前开源模型市场数据噪声大、不精确的问题。该工具通过整合平台指标、初创公司营销数据及公开评测,提供对开源推理市场规模的近似估算,并与 Google 等闭源巨头的数据进行对比分析。
报道正文
我运行时间最长的 Agent 测试平台一直在构建 Interconnects Dashboard —— 一个聚合了全网关于开源模型采用率和性能最佳数据的工具。这个仪表盘是免费提供的,并且正变得相当有用。尽管如此,我们目前拥有的所有关于开源模型采用率的测量数据都极其不精确。我们有嘈杂的平台指标、来自初创公司的营销相关指标,以及不完美的公开评估结果。要弄清楚局势走向,需要一双内行的眼睛。这些研究笔记是我对当前状况的最佳近似估计。
与 Interconnects 上的大多数内容一样,我们的目标是创造远超所获取的价值,因此仪表盘上的数据在可预见的未来将保持免费。这些笔记将比我许多文章更原始,是一个分享我正在思考但尚未拥有完整证据(暂时)之内容的地方。它们主要面向付费用户,这使我能够更自由地表达观点。如果你从事 AI 政策或面向政策的研究工作,请联系我们,我们很可能为你提供折扣或免费访问权限。
我今天想要解决的主要问题是:开源模型推理的市场规模如何?它是否在增长?相对于 OpenAI/Anthropic 而言,它是否只是一个微不足道的误差项? 我一直在努力建立尽可能好的测量方法,主要将开源模型推理初创公司 Baseten、Fireworks 和 Together AI 作为风向标(同时也参考 OpenRouter 的 token 量中开源模型的占比,值得庆幸的是,他们通过 API 报告了这一数据)。超大规模云服务商(Hyperscalers)在此领域可能也占据重要份额,例如 Amazon Bedrock 和 Azure 的模型花园(Model Garden),但我尚未看到他们按模型类别细分使用情况。这些初创公司的命运与开源模型推理作为一个品类的成功与否直接相关度更高。
对于最新数据,我们可以从我关于开源模型经济的演讲中的一张幻灯片开始(录像见此处)。这是开源模型初创公司随时间推移公布的 token 量数据,采用对数刻度。
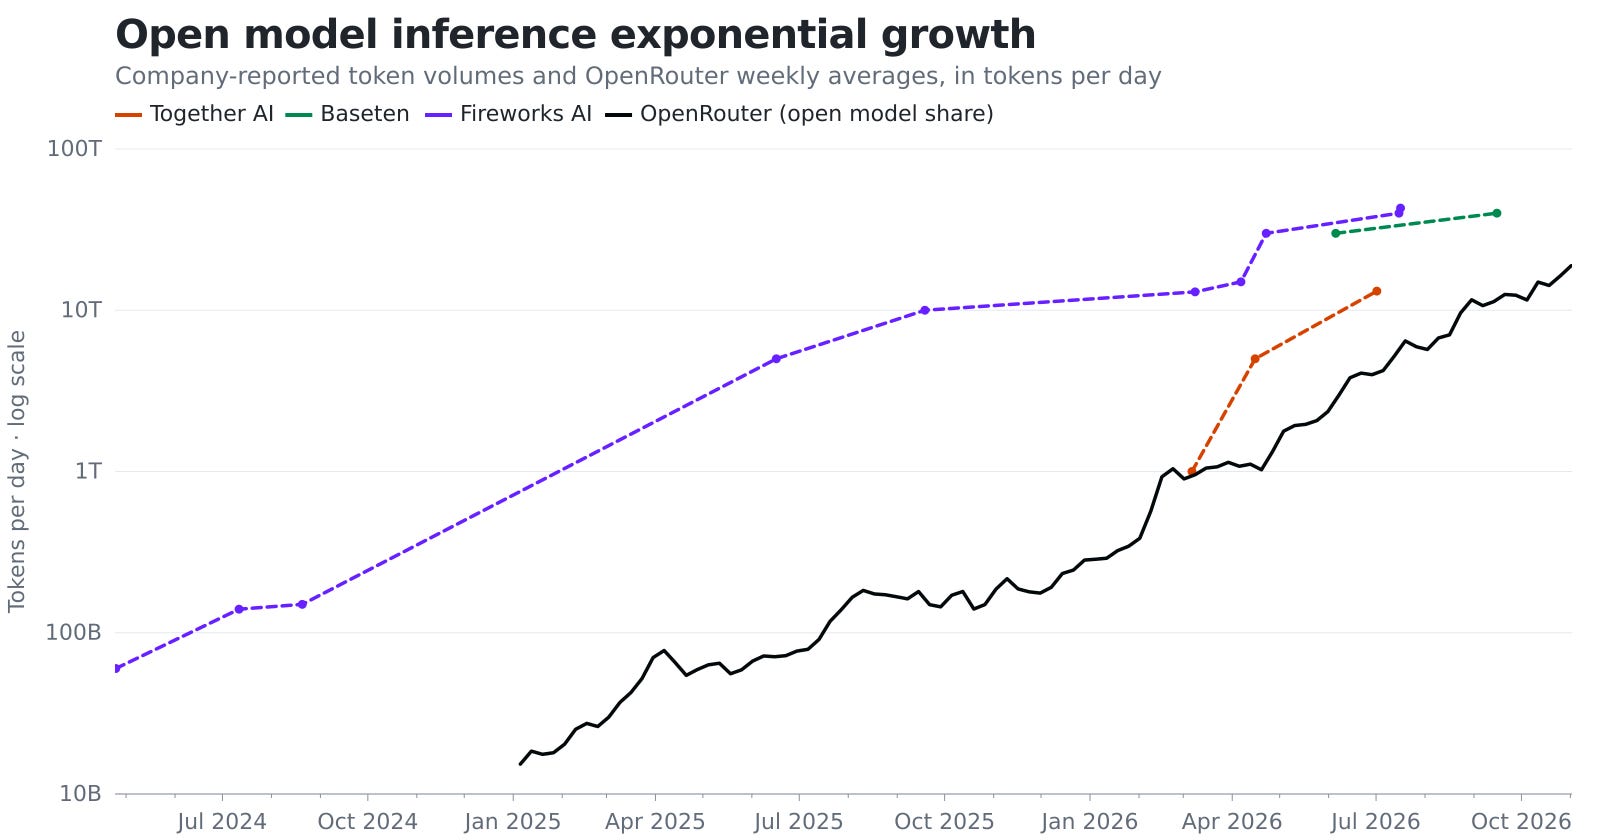
这显示出近乎指数级的增长,随后将迎来 GLM 5.2 在开放智能体方面的阶跃式变革带来的进一步上升。例如,Fireworks 在本周其首次公司大会上宣布,他们正在为客户的定制模型提供超过每天 40T tokens 的服务。这只是他们推理业务的一部分,据称该垂直领域自今年夏季以来增长了超过 2 倍,因此我预计当他们下次更新数据时,今秋的总体数字将远超 100T tokens。
面对这些数字,我的第一反应是将其与任何可比的闭源模型或超大规模公司进行基准对比,至少在 token 数量方面如此。幸运的是,Google 在其财报中会披露整个平台及 API 使用的 token 总量。我们可以将这两个数字叠加到开源模型推理平台上, resulting plot 如下所示: