RadixArk 开源 27B 智能体模型 长程任务训练仅用 18 天
RadixArk 发布首个模型 DaisyRose-27B,基于 Qwen3.8-27B 用强化学习在长程智能体任务上后训练,仅用 1200 条精选任务、144 张 H200 训练 18 天。Terminal-Bench 4.1 pass@1 从 5.6% 提升至 12.0%,权重以 Apache 2.0 开源。
报道正文
本文目录7 个章节
DaisyRose-27B:推动后训练效率的前沿
团队文章 发布于 2026 年 11 月 18 日 点赞 3
[Jason Chen jzsc 关注](https://huggingface.co/jzsc) [RadixArk](https://huggingface.co/RadixArk) 
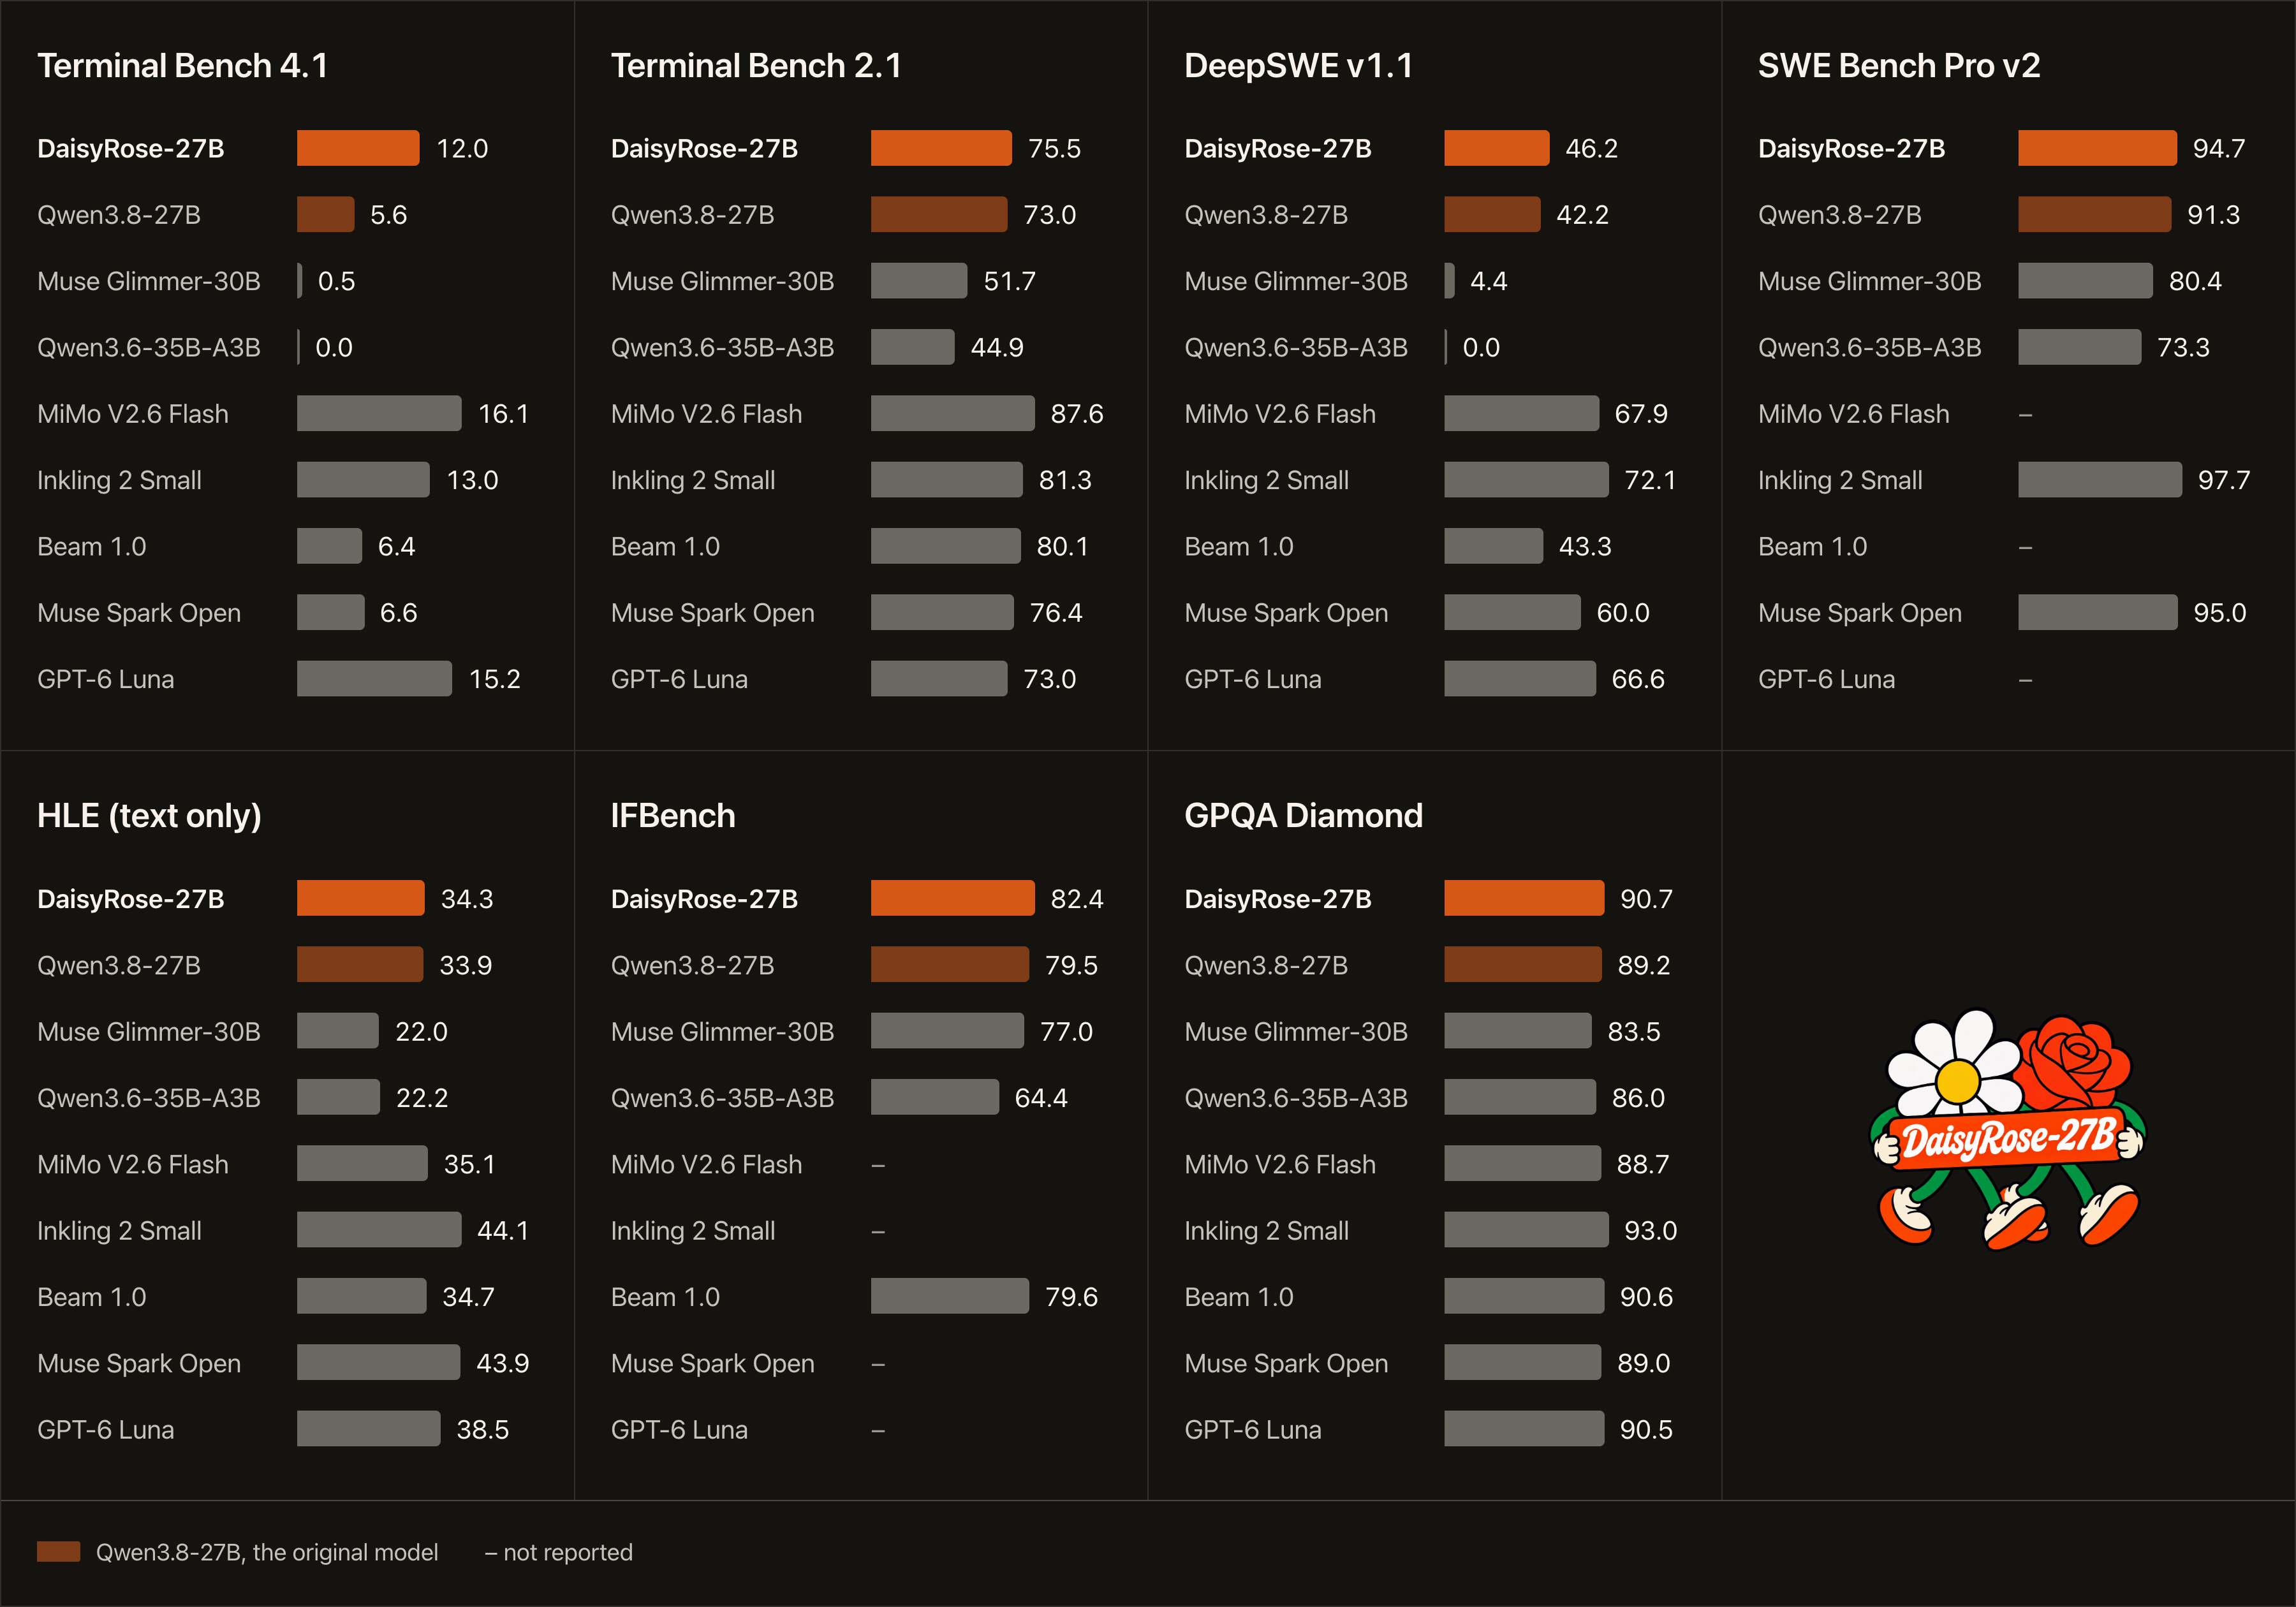
今天我们发布 DaisyRose-27B,这是 RadixArk 的首个模型,基于 Qwen3.8-27B 构建,并使用 Miles 通过强化学习训练而成。我们在长时程智能体任务上对其进行了训练,会话长度最高可达 100 万 token,仅用 1,200 个精选任务,在 144 块 H200 GPU 上历时 18 天完成。DaisyRose-27B 将 Terminal-Bench 4.1 的 pass@1 从 5.6% 提升至 12.0%。除 Terminal-Bench 4.1 之外,它还在多种其他推理、指令遵循和编码基准测试上取得了提升。
检查点以 Apache 2.0 许可发布:
该模型保留了 Qwen3.8-27B 的架构、分词器、聊天模板、图像理解能力以及 256K token 上下文窗口。更长的训练会话通过 harness 摘要来跨越多个轨迹。有关模型属性和推理设置,请参阅模型卡。
运行 DaisyRose-27B
我们建议使用 SGLang 和 DSpark 投机解码来部署 DaisyRose-27B。SGLang cookbook 提供了针对不同 GPU 和检查点格式的启动配置。
在端口 30000 上以服务模型名 DaisyRose-27B 启动服务器后,你可以使用 OpenAI Python 客户端发送请求:
from openai import OpenAI

client = OpenAI(
    base_url="http://localhost:30000/v1",
    api_key="none",
)

response = client.chat.completions.create(
    model="DaisyRose-27B",
    messages=[
        {
            "role": "user",
            "content": "How many positive divisors does 360 have?",
        }
    ],
    temperature=1.0,
    top_p=0.95,
    extra_body={"top_k": 20, "min_p": 0.0},
)print(response.choices[0].message.reasoning_content)
print(response.choices[0].message.content)该模型默认在回答前进行思考。其推理过程通过 reasoning_content 返回,最终答案则通过 content 返回。这些设置遵循模型卡片的快速入门指南。
基准测试结果
| 基准测试 | Qwen3.8-27B | DaisyRose-27B |
|---|---|---|
| Terminal Bench 4.1 | 5.6 | 12.0 |
| Terminal Bench 2.1 | 73.0 | 75.5 |
| DeepSWE v1.1 | 42.2 | 46.2 |
| SWE Bench Pro v2 | 91.3 | 94.7 |
| HLE(纯文本) | 33.9 | 34.3 |
| IFBench | 79.5 | 82.4 |
| GPQA Diamond | 89.2 | 90.7 |
DaisyRose-27B 在上述所有基准测试中的得分均高于原始 Qwen3.8-27B 模型。提升最大的是 Terminal Bench 4.1,pass@1 从 5.6% 升至 12.0%。
各项基准测试的得分取 BF16 与 FP8 两次运行中的较高值;在两者都进行了评估的项目上,二者差距均小于一分。模型卡中包含了对比来源与评估设置。
训练设置中的三个方面使本次发布成为可能:精心设计的任务、高效的训练后端,以及可靠的沙箱。
高质量训练数据
我们与 Eigent AI 合作构建了这些任务,起点是其在机器学习、软件工程、科学及其他领域的大量任务池。我们共同构建了数千个候选任务,其中约 1,200 个进入了最终训练集。
我们依据三项标准筛选任务:
- 每个任务都针对原始模型所犯的某个错误。 我们在每个任务上运行 Qwen3.8-27B,并围绕我们希望模型不再犯的错误重新设计每个任务。随后我们调整难度,直到解决率落入有用的学习区间。
- 每个任务都需要若干相互依赖的步骤。 智能体必须在长时间作业中进行推理、规划与执行。每次尝试在沙箱中最多有 1.5 小时,涉及超过 100 次工具调用和超过 256K 输出 token。
- 任务必须奖励真正解决问题。 我们结合模型的尝试逐一审查了每个任务。那些无需解决预期问题即可通过、或存在设计缺陷的任务,均被修复或移除。
高效的训练后端
RadixArk 使用 Miles(我们面向大规模模型后训练的开源强化学习框架)以全异步模式训练 DaisyRose-27B:智能体持续工作,模型同时学习,二者互不等待。128 块 H200 负责智能体任务的推理,另有 16 块运行训练器并从轨迹中学习。每一步之后,更新后的模型会分发到运行智能体的 128 块 GPU 上。学习过程运行在我们的内部训练后端上,该后端专为智能体训练而构建:每一步都从少量极长的会话中学习,其中一些会话长达 1M token,并通过 harness 摘要折叠为多条轨迹。
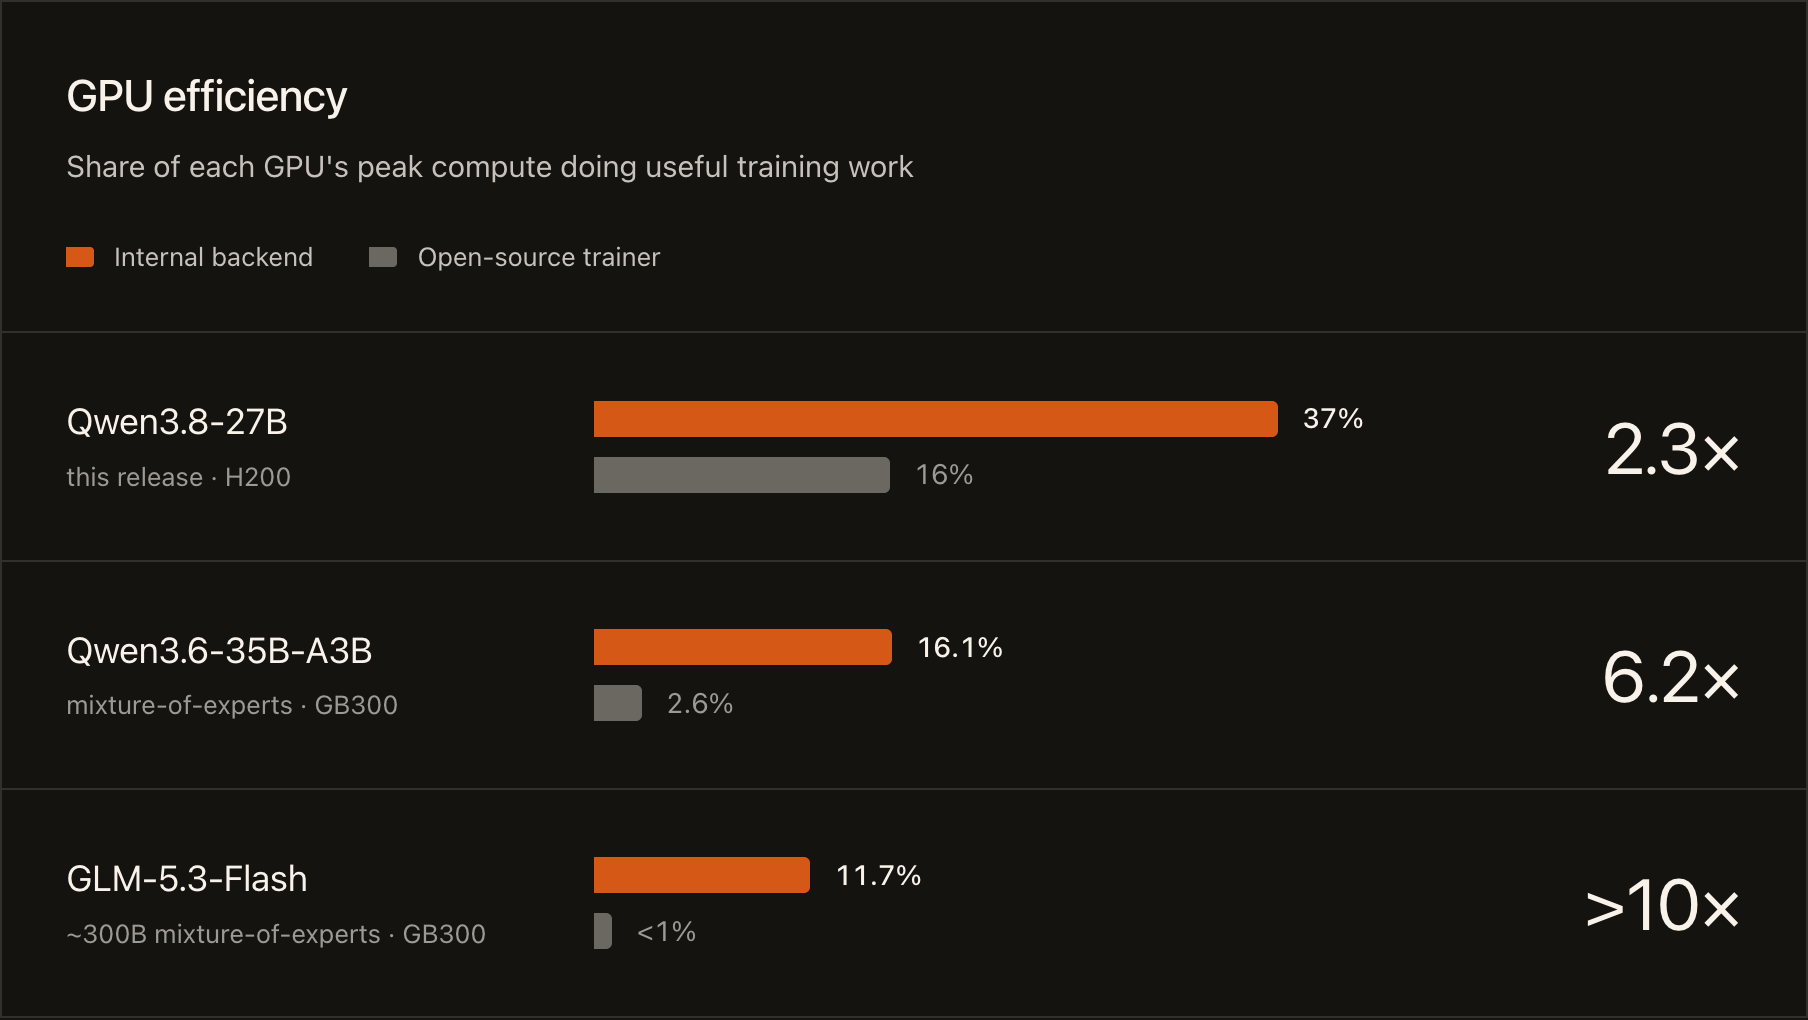
训练成本降低 57%。 在此次发布中,每块 GPU 峰值算力的 37% 投入到了有效的训练工作中(模型 FLOPs 利用率,即 MFU),这是在我们后端上的表现。基于 Megatron 构建的开源训练器在可比运行中仅达到 16%。因此,同样的训练所需的 GPU 时间减少了 57%。在混合专家模型上,提升更为显著:Qwen3.6-35B-A3B 上达到 6.2 倍,而在约 300B 参数的 GLM-5.3-Flash 上超过 10 倍。
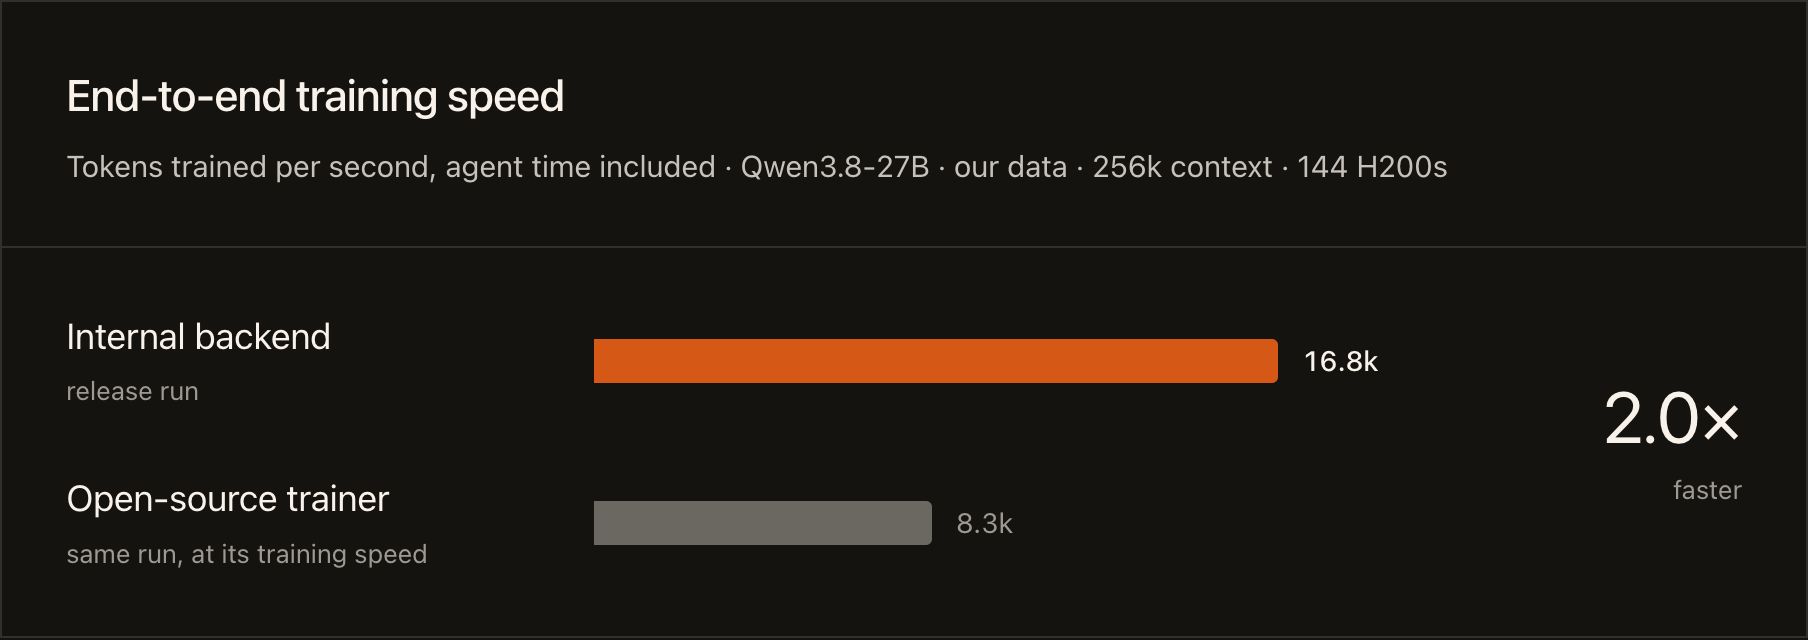
端到端速度提升 2 倍。 计入智能体在其任务上花费的时间,此次发布运行在 144 块 GPU 上训练速度约为每秒 16,800 个 token。开源训练器在相同 GPU 上约为 8,300 个。
数周稳定运行。 此次发布运行在 144 块 H200 上训练了数周,总计 63,000 GPU 小时。从第一步到最后一步,其速度和效率始终保持稳定。
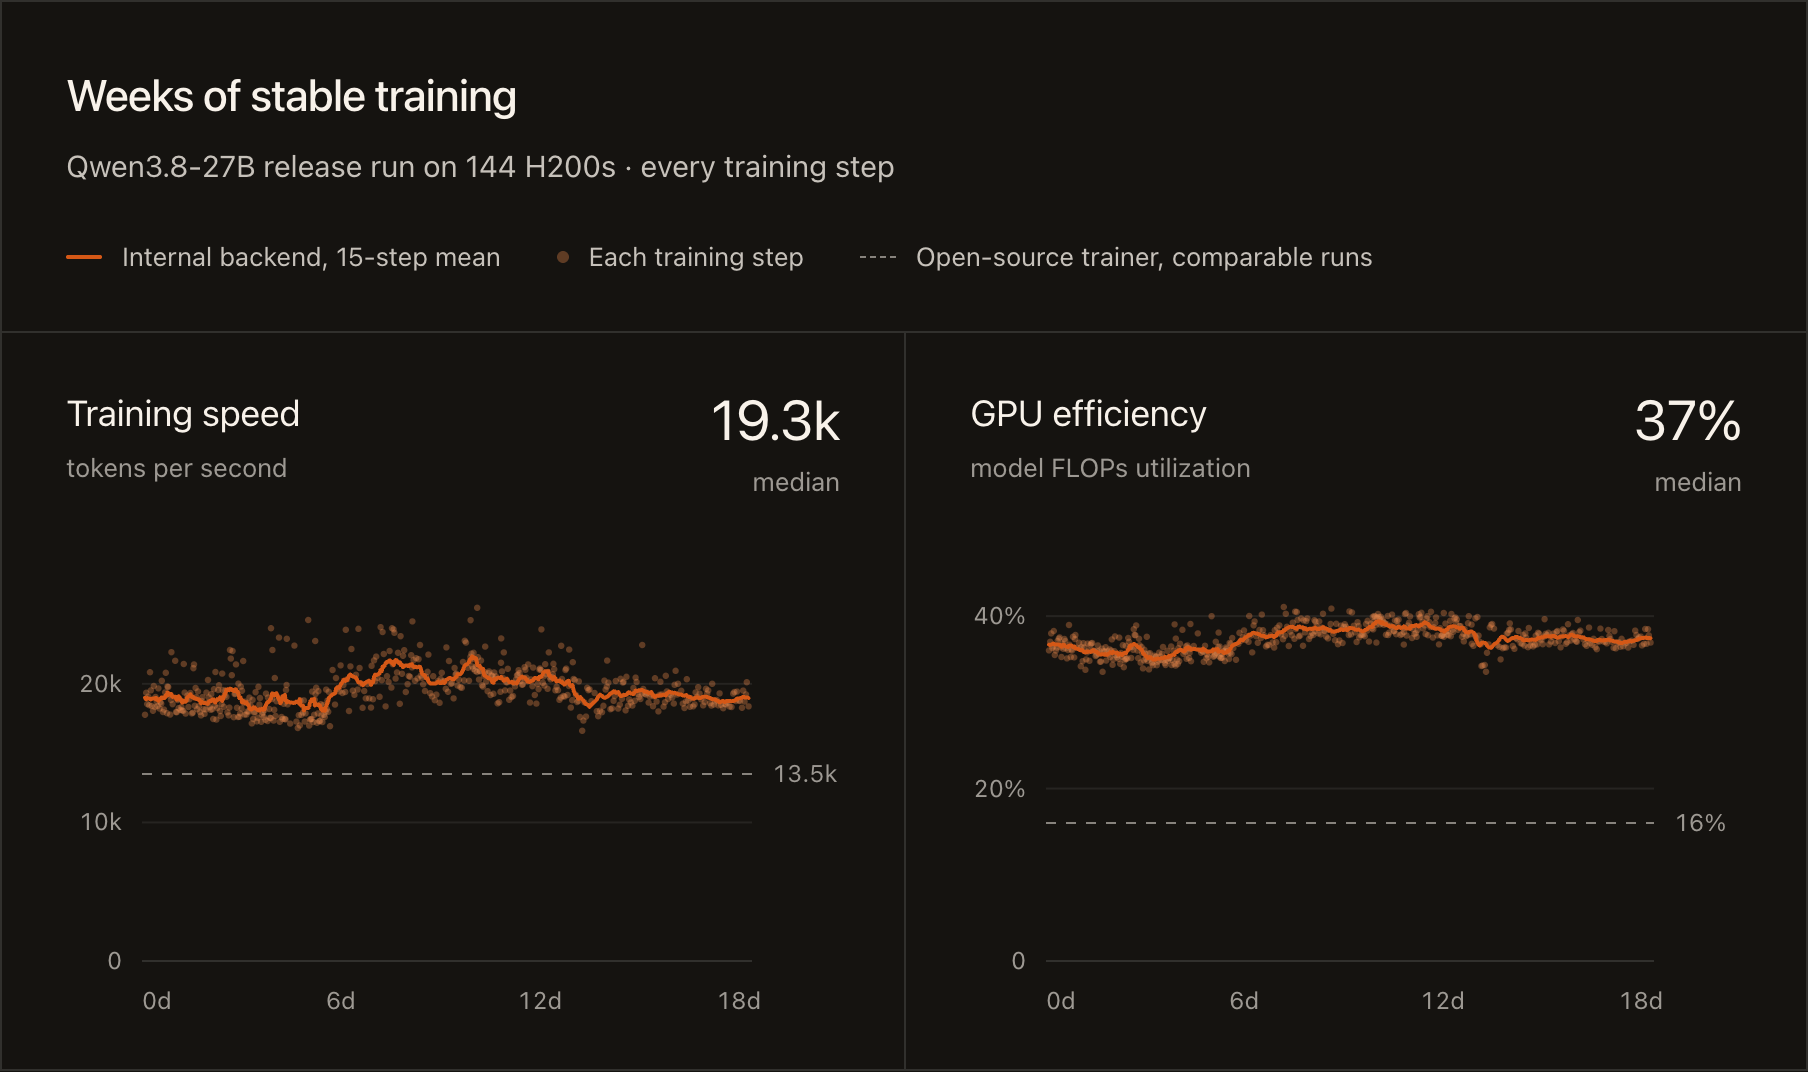
DaisyRose-27B 发布运行在 144 块 H200 上的每个训练步骤,按总训练时间绘制。虚线:可比运行中的开源训练器。
稳健的沙箱服务
每次训练尝试都在沙箱中运行:任务环境的一个全新副本,智能体在其中执行命令、编辑文件,然后被评分。
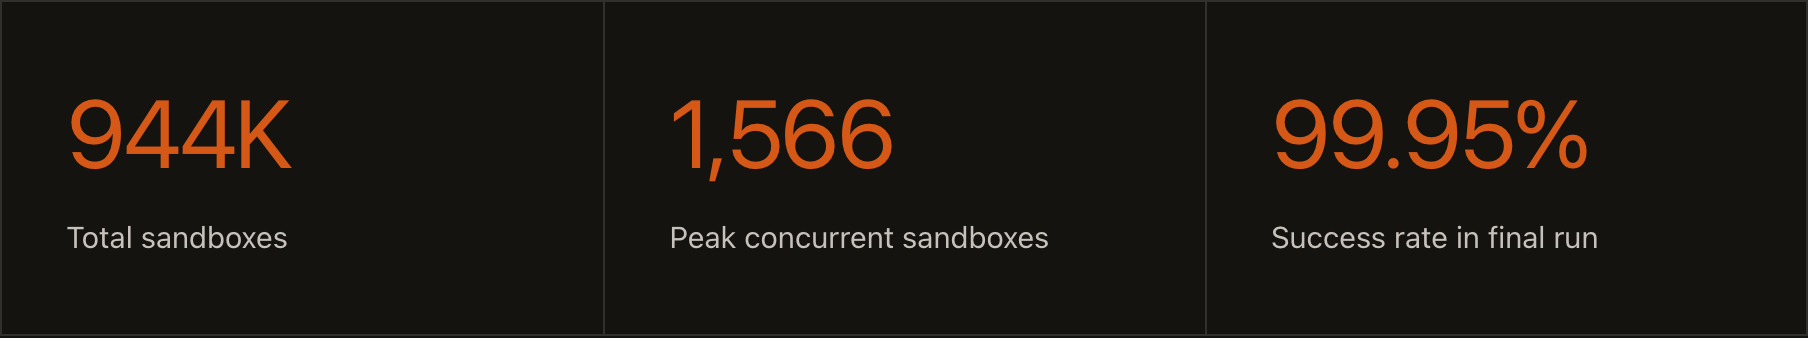
我们的服务基于开源项目 AgentENV 构建,我们也为其贡献修复。在九月中旬到十一月中旬期间,它为本项目运行了约 944,000 个沙箱,最高同时运行 1,566 个。
该服务从一台机器扩展到多达 12 台。我们对其进行了十次升级,几乎全部在训练运行期间完成。在全部九周中,99% 的沙箱创建成功;自十月下旬以来,该数字已超过 99.95%。
该项目沙箱的云基础设施成本,比使用主流云沙箱提供商运行相同沙箱低约 80%。我们降低成本的一种方式是让每个沙箱的内存分配随其实际使用量动态增减,从而让更多沙箱共享每台机器。
试用模型或训练你自己的模型
下载 DaisyRose-27B,按照 SGLang 服务指南操作,或使用 Miles 训练你自己的智能体。
我们很想了解 DaisyRose-27B 在你的任务上的表现,包括它在哪些方面存在不足。欢迎在模型的 Community 标签页中分享你的配置和结果。
我们感谢 Eigent AI 在训练数据方面与我们紧密合作,感谢 Qwen 团队打造了 Qwen3.8-27B。我们也感谢 Miles 和 SGLang 社区,以及其他开源项目,包括 slime、AgentENV 和 Harbor。
改编自 RadixArk 原文。