OpenAI 发布人类偏好学习研究:奠定 RLHF 基础
OpenAI 于 2017 年发布论文《Learning from Human Preferences》,提出通过人类反馈训练奖励模型的方法。该研究确立了基于人类偏好的强化学习(RLHF)范式,为后续大语言模型的对齐与指令微调提供了核心理论支撑。
报道正文
本文目录4 个章节
- 研究
- 产品
- 企业
- 开发者
- 公司
- 基金会(在新窗口中打开)
- 研究
- 产品
- 企业
- 开发者
- 公司
- 基金会(在新窗口中打开)
从人类偏好中学习 | OpenAI
2017 年 6 月 13 日
从人类偏好中学习
收听文章 4
分享
挑战
构建安全 AI 系统的一个步骤是消除人类编写目标函数的需求,因为使用复杂目标的简单代理指标,或者在定义复杂目标时出现细微偏差,都可能导致不良甚至危险的行为。我们与 DeepMind 的安全团队合作,开发了一种算法,该算法能够通过被告知两种提议行为中哪一种更好,来推断人类的意图。
我们提出了一种学习算法,利用少量人类反馈来解决现代强化学习环境中的问题。此前已有研究探索过结合人类反馈的机器学习系统,但我们将该方法进行了扩展,使其能够处理更为复杂的任务。我们的算法仅需从人类评估者处获取 900 比特的反馈信息,便学会了完成后空翻——这一看似简单的动作虽然易于评判,却难以精确定义。
我们的算法通过约 900 个独立比特的人类评估者反馈,学会了完成后空翻。
整体训练过程是一个由人类、智能体对目标的理解以及强化学习(RL)训练构成的三步反馈循环。
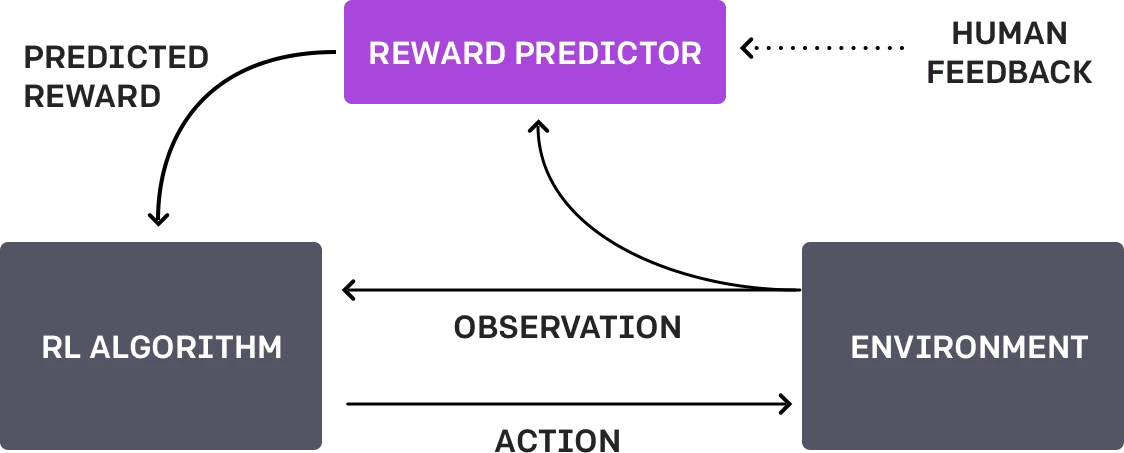
我们的 AI 智能体最初在环境中随机行动。每隔一段时间,系统会将两段展示其行为的视频片段提供给人类,由人类判断哪一段更接近于实现目标——在本例中即为后空翻。AI 通过寻找最能解释人类判断结果的奖励函数,逐步构建起对任务目标的模型。随后,它利用强化学习来掌握达成该目标的方法。随着行为表现的改善,它会持续就那些自己最不确定优劣的轨迹对向人类寻求反馈,从而进一步细化其对目标的理解。
我们的方法展现出令人鼓舞的样本效率——如前所述,完成“后空翻”视频任务所需的反馈信息量不足 1000 比特。这仅耗费了人类评估员不到一小时的时间,而在此期间,策略在后台积累了约 70 小时的总体经验(以远快于实时的速度进行模拟)。我们将继续致力于减少人类需要提供的反馈量。你可以在下方的视频中观看加速版的训练过程。

00
我们在模拟机器人和 Atari 领域的多项任务上测试了该方法(且未获知奖励函数:即在 Atari 中无法访问游戏得分)。我们的智能体能够从人类反馈中学习,在许多测试环境中实现强劲甚至超越人类的表现。在下方的动画中,你可以看到使用我们技术训练的智能体在玩各种 Atari 游戏。每帧右侧的水平条代表智能体对人类评估员对其当前行为认可程度的预测。这些可视化结果表明,通过人类反馈训练的智能体学会了重视 Seaquest 中的氧气(左图)、预判 Breakout 和 Pong 中的奖励(中间图),或掌握如何在 Enduro 中从碰撞中恢复(右图)。


需要注意的是,反馈无需与环境的标准奖励函数保持一致:例如,我们可以训练智能体在《Enduro》游戏中精确地与其他车辆保持同步,而不是通过超越它们来最大化游戏得分。我们还发现,在某些情况下,基于反馈的学习效果优于使用标准奖励函数的强化学习,因为人类对奖励的塑造往往比环境设计者更为合理。
挑战
我们算法的性能取决于人类评估者对何种行为“看起来”正确的直觉。如果人类对任务缺乏深刻理解,他们提供的反馈可能就不够有帮助。与此相关的是,在某些领域,我们的系统可能导致智能体采用欺骗评估者的策略。例如,一个本应抓取物体的机器人,却将机械臂置于摄像头和物体之间,从而制造出正在抓取的假象,如下图所示。
我们通过添加视觉线索(上述动画中的粗白线)来解决这一特定问题,以便人类评估者更容易判断深度。
脚注


相比之下,我们花了两个小时编写自己的奖励函数(如右上方的动画所示),以使机器人完成后空翻。虽然它成功了,但其优雅程度远不如仅通过人类反馈训练出的模型(左上方)。我们认为,在许多情况下,人类反馈能让我们比手动精心构建目标函数更直观、更快速地指定具体目标。
你可以使用以下针对 Hopper 环境的奖励函数,在 gym(opens in a new window) 中复现这个后空翻动作:
Python
1def reward_fn(a, ob):2 backroll = -ob[7]3 height = ob[0]4 vel_act = a[0] * ob[8] + a[1] * ob[9] + a[2] * ob[10]5 backslide = -ob[5]6 return backroll * (1.0 + .3 * height + .1 * vel_act + .05 * backslide)
[注:本文篇幅超长,以上为核心前篇精译,后续内容保留原文呈现]
Authors
Dario Amodei, Paul Christiano, Alex Ray