微软开源 TokenEconomizer 让编程智能体降本 30.9%
微软研究院发布开源插件 TokenEconomizer,通过从智能体历史会话中学习微技能、裁剪工具与干预失败循环,在不改动模型与智能体本身的前提下降低 token 消耗。在 277 个真实修 bug 任务上,多款编程智能体成本下降 18.4%–30.9%,所有测试仓库均实现降本且任务成功率基本持平。
报道正文
本文目录5 个章节
概览
- 开发者日复一日地在相同的代码库中使用 AI 编码智能体,但智能体往往每次会话都从零开始:重新发现熟悉的事实、加载未使用的工具,并重复不成功的做法。
- TokenEconomizer 是一个开源插件,它从智能体在某个代码库中的过往会话中学习,以减少未来会话中的浪费,而无需修改智能体或其底层模型。
- 在 277 个真实的缺陷修复任务中,TokenEconomizer 在多个 AI 编码智能体上将成本降低了 18.4–30.9%。在所有测试过的代码库中成本都有所下降,而任务成功率基本保持稳定。
AI 编码智能体正越来越多地帮助开发者基本自主地修复缺陷和构建功能,但每一次与其模型的交互都会消耗 token。在每次会话中,智能体都会向模型发送指令、工具描述和会话历史。大多数降低这一成本的努力都聚焦于单个任务。然而开发者会反复回到相同的代码库,这为智能体提供了从以往工作中学习的机会。若缺乏这种学习,智能体可能会反复重新发现如何运行测试、加载从未使用的工具,或花费数十个回合反复处理同一个错误。
在我们的论文 TokenEconomizer: Experience-Driven Black-Box Cost Control for Coding Agents 中,我们提出了一个简单的问题:在某个代码库中的经验能否帮助智能体更高效地解决未来的任务?TokenEconomizer 是来自加州大学伯克利分校、微软研究院和微软安全部门的一个开源插件,它将已完成的会话转化为对后续会话的指导。它无需更改智能体或其底层模型即可减少浪费,因此开发者可以将其与已经依赖的编码智能体配合使用。
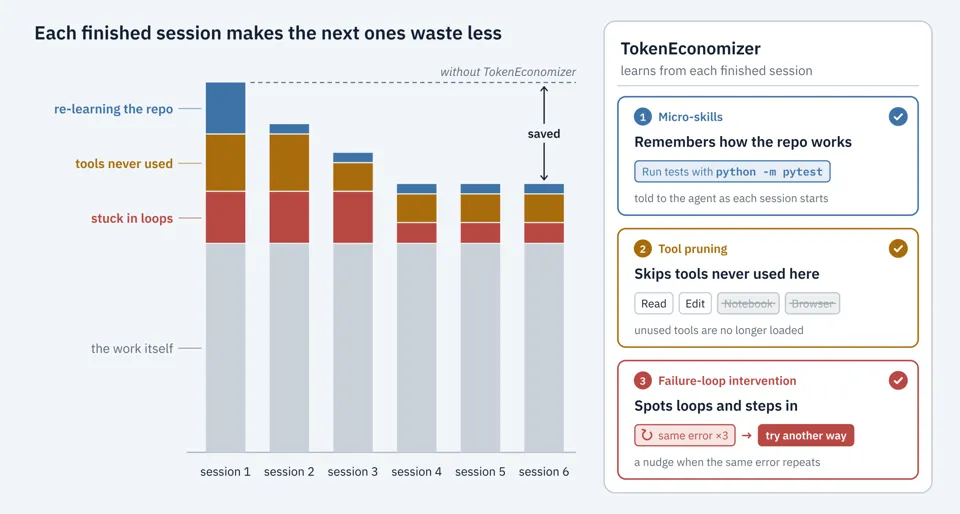
图 1. 每一次完成的会话都会让 TokenEconomizer 对该代码库有所了解,因此后续会话消耗的 token 更少。
token 都花在哪里了
我们首先在 SWE-Bench 的 60 个任务上对 Claude Code 进行了性能分析。SWE-Bench 是一个基准测试,涵盖开源 Python 项目中的真实缺陷修复,我们按顺序运行每个仓库的任务。三类浪费反复出现:
- 重复发现相同事实。当一个仓库累计完成至少五个任务后,30% 的工具调用重复了该仓库中较早任务的某个操作。只有 7% 与另一个仓库历史中的操作相匹配。
- 为未使用的工具付费。智能体每一轮都会收到 23 个工具描述,但其中 16 个从未被调用。
- 卡在失败上。失败的任务占 17%,却占了 32% 的开销。
我们还测试了三个流行的开源插件,每个都围绕一种固定的成本节约策略构建。每个插件都在某些仓库中降低了成本,但在其他仓库中则没有。综合来看,这些发现表明,有效的成本控制必须适应仓库,而不是在所有地方都应用相同的策略。
TokenEconomizer 如何工作
每次会话结束后,TokenEconomizer 会读取会话日志,并更新它对仓库的了解。然后,它通过三种机制采取行动,仅使用智能体已经提供的接口,如图 2 所示。
微技能 用一行笔记捕获仓库特定的知识。TokenEconomizer 识别跨会话的重复模式,并提出相应的笔记。只有在多次会话确认该模式后,这些笔记才会被添加到智能体的起始上下文中;如果后续证据与之矛盾,则停用该笔记。
工具剪枝 移除仓库历史表明智能体不太可能使用的工具,同时始终保留用于运行命令和编辑文件的核心工具。被移除的工具可以在需要时恢复。
失败循环干预 监视持续遭遇相同失败的智能体。一个评判模型决定智能体是真的卡住了,还是仍在取得进展。如果它卡住了,智能体会收到一条简短笔记,建议采用不同的方法。在开源插件中,如果智能体在收到笔记后仍然卡住,TokenEconomizer 会提醒开发者,而不是自行停止工作。
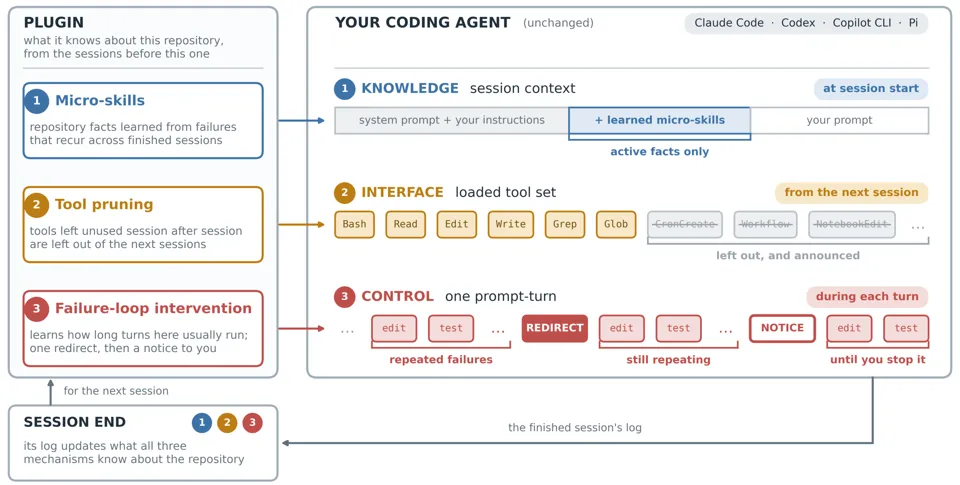
图 2. TokenEconomizer 与一个保持不变的编码智能体协同工作。微技能补充已学习的事实,工具剪枝精简已加载的工具,失败循环干预则重定向卡住的工作。每个完成的会话都会更新这三者。
该控制器被设计为在新证据出现时修订其决策。所报告的节省也计入了 TokenEconomizer 自身模型调用的成本。
在每个代码仓库中节省成本
我们在来自六个代码仓库的 277 个 SWE-Bench 任务上评估了 TokenEconomizer,使用了五种不同的 AI 编码智能体与模型组合。对于每个代码仓库,TokenEconomizer 在开始时都没有任何先前的会话历史。
如图 3 所示,TokenEconomizer 将平均成本降低了 18.4–30.9%,并在全部 30 个仓库-组合配对中节省最多,且没有性能损失。相比之下,降低模型的推理强度虽能节省相近或更多的成本,却会导致显著的性能下降。
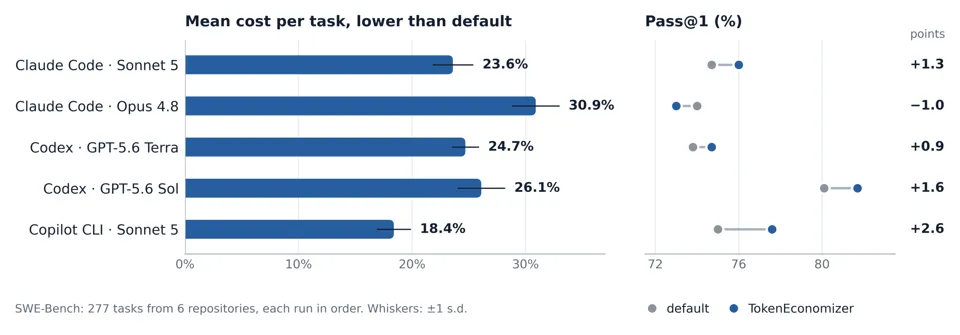
图 3. 在 SWE-Bench 上,TokenEconomizer 在五种智能体-模型组合中将每个任务的平均成本降低了 18.4–30.9%(左),同时其中四种组合的 Pass@1 有所上升(右)。
节省会随着经验的积累而增长。在 TokenEconomizer 学习期间,早期任务可能成本更高,但如图 4 所示,到第六个任务时,每个代码仓库的累计成本都降到了默认水平以下。每种机制都能单独带来节省,而将三者结合则能实现最大幅度的降低。
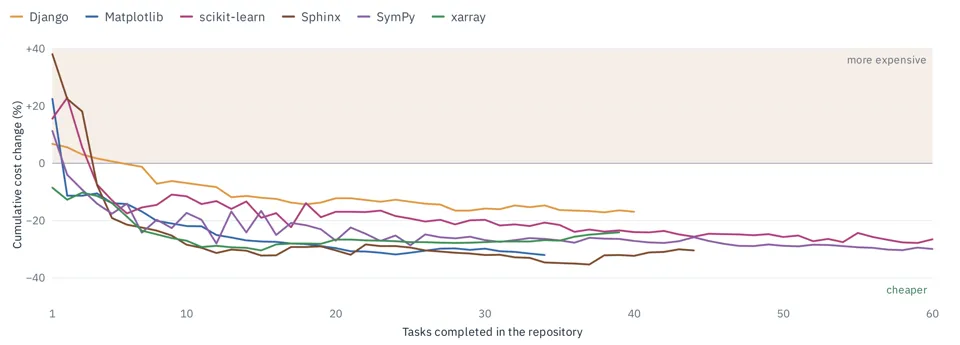
图 4. 使用 Claude Code 时,各代码仓库任务相对于默认水平的累计成本变化。从零历史开始,每个代码仓库到第六个任务时都变得更便宜。
这些节省也延续到了顺序式 Web 开发中,在 Web-Bench 上成本降低了 16.0–21.2%。在安全审计方面,由于每个任务都在新的代码仓库中进行,成本降低了 6.4–19.6%。
展望未来
TokenEconomizer 为编码智能体开辟了一条新路径:它们不仅能学会如何解决任务,还能学会如何更有效地使用计算资源。其轻量级控制器展示了经验如何在不改变底层智能体或模型的情况下提升效率。
这个开源插件让开发者和研究人员能够接触这些方向。它被设计为可与现有 AI 编码智能体并行运行,无需修改其底层模型,自身也不需要 API 密钥,并将学习到的内容保留在开发者本地机器上。我们邀请社区将其作为起点,探索能够随着经验积累而变得更加足智多谋的智能体——既调整它们的工作方式,也调整它们所掌握的知识。
文章 TokenEconomizer:从经验中学习,让 AI 编码智能体更高效 首次发表于 Microsoft Research。