Google DeepMind · 2026/10/14 00:01:58
谷歌发布 Gemini 4 Argon:ERQA 基准得分 87% 领跑具身推理,打通机器人全生命周期控制与仿真重建
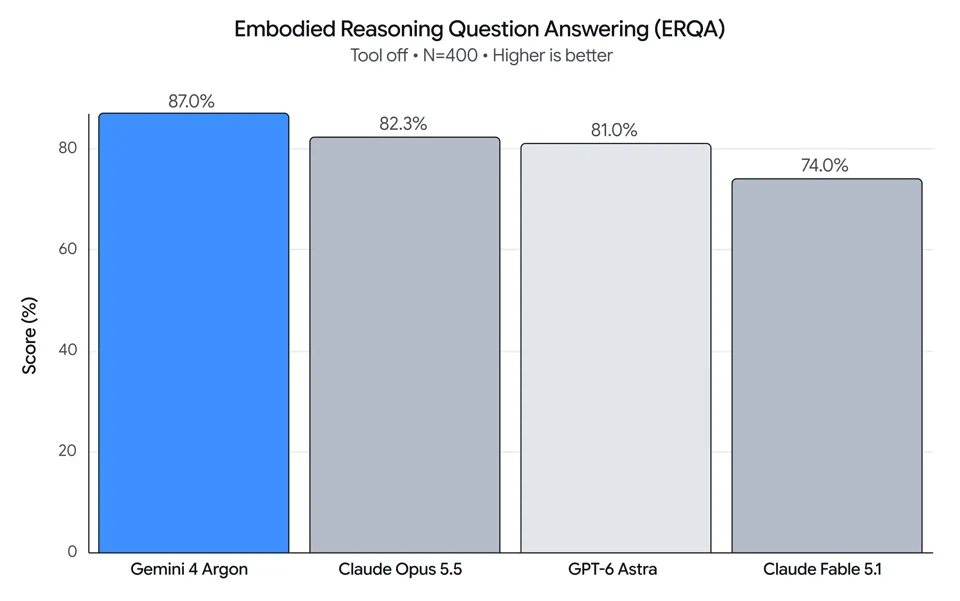
谷歌推出面向机器人领域的通用物理推理模型 Gemini 4 Argon,在具身推理基准测试(ERQA)中以纯推理方式取得 87% 的分数,超越所有其他前沿模型。该模型具备显著的物理理解、代码生成及视觉语义推理能力,支持从移动操作控制到基于摄像头视频重建物理校准仿真孪生体(Real2Sim)的全生命周期应用。目前开发者可通过 Google 平台立即调用该模型进行构建。
报道全文原始报道全文
本文目录14 个章节
2026 年 10 月 13 日
Gemini 4 Argon 在物理理解、代码生成和视觉语义推理方面实现了阶跃式突破,解锁了机器人技术栈中的全新工作流,并加速迈向物理 AGI 的进程。
这一能力飞跃可在 具身推理(ERQA)基准测试 中得以验证,该测试旨在评估模型理解和解决三维环境中物理及空间问题的能力。仅依靠纯推理,Argon 取得了 87% 的成绩,超越了所有其他前沿模型。
作为一款通用的物理推理模型,Argon 可应用于整个机器人生命周期。在本文中,我们将分享 Argon 在四个关键领域的代表性提示词:
- 机器人控制 → 基于 MuJoCo 的移动操作练习、零样本机器人控制以及视频世界模型的闭环转向。
- Real2Sim(真实到仿真)→ 从机器人摄像头画面、第一人称人类视频或手绘草图中重建经过物理校准的仿真数字孪生体。
- 物理理解 → 智能体多模态事后标注,包括对灵巧性的深入理解、密集价值函数及进度估计。
- 研究与自我改进 → 通过仿真进行动作优化,以及在硬件上进行迭代式自我改进。
利用 Argon 解锁机器人控制
1. Spot 移动操作:通过 MuJoCo 练习将垃圾投入脚踏式垃圾桶
Argon 控制波士顿动力公司的 Spot® 四足机器人(12 自由度腿部 + 6 自由度机械臂)学习一项新技能:踩下脚踏式垃圾桶以丢弃易拉罐。Argon 首先创建一个脚踏式垃圾桶的可动 MuJoCo 数字孪生体,在踩踏物理踏板并将易拉罐丢入打开的垃圾桶之前,先在虚拟环境中练习其动作。
抱歉,您的浏览器不支持播放此视频
Spot 移动操作 —— 真实到仿真再到真实的脚踏式垃圾桶投放流程:Spot 拾起易拉罐,检查腕部摄像头,在 MuJoCo 中练习三腿三角平衡,踩下脚踏板,确认手部位于打开的垃圾桶中心,然后将易拉罐投入其中。
提示词:
你身后有一罐健怡可乐,左手边的黑色桌子上也有一罐。 使用 spot-mobile-manipulation 技能将它们拾起,并丢入黑色的脚踏式垃圾桶中。 在踩下踏板之前,请通过前置摄像头确认你的右脚目标已对准踏板中心,并使用双智能体验证集群(脚部验证器和手部验证器)来验证脚部踩踏动作以及手部的三维对齐情况,确保手准确进入桶内后再释放物体。
纯文本 已复制
2. 零样本控制
Argon 控制一个简单的机械臂,将倒下的马克杯扶正,并将揉皱的餐巾纸放入杯中。Argon 利用视觉坐标框架和动作原语进行推理,分多轮完成此任务。
抱歉,您的浏览器不支持播放此视频
左图:第三人称真实机器人视角;右图:经过校准的手腕相机视图,叠加了投影的 2 厘米世界坐标和夹爪闭合标线。
提示词:
[附件: wrist_cam.png, obs.json]

任务:让机械臂重新调整马克杯使其直立,并将餐巾纸放入杯中。

## 执行纪律
- 只需输出 1 句观察结果,紧接着立即输出你的 `curl` 命令(第 1 轮包含 `# Plan:`,每一轮都包含 `# Thought:`)。所有所需信息均包含在 `obs.json` 以及绘制在 `wrist_cam.png` 上的校准标线/网格中。

## 视觉坐标参考(标注于 wrist_cam.png)
- `+X`(图像中的 UP/向上):远离机器人底座 | `-X`(DOWN/向下):朝向机器人底座
- `+Y`(图像中的 LEFT/向左):世界左侧         | `-Y`(RIGHT/向右):世界右侧
- `+Z`:高于桌面的高度                | `黄色数字`:世界 (X, Y) 坐标,单位为厘米(在 `grid_z` 处的 2 cm 网格)
- `青色 + 十字准星`:当前的 3D 捏取中心
- `青色 [ + ] 括号`:当前夹爪的开合线
- `绿色线条`:当前物体的长轴方向(`yaw_deg`: 0° = 沿 +X 垂直,90° = 沿 +Y 水平)
- `pitch_deg = 90°`:垂直向下 (-Z) 的俯视抓取/放置;`pitch_deg < 60°`:沿手指轴线倾斜的同轴接近

## 闭环回合工作流
1. 检查当前状态并查看 `wrist_cam.png`:
   `curl -s http://127.0.0.1:8081/obs`(返回 `ee_pos`、`holding`、`status`、`workspace`、`wrist_cam_path`)。
2. 在第 1 回合预先选择 VLM 调用粒度:
   - 粗粒度(2–4 次调用):`look_at` -> `grasp` -> `place` -> `done`
   - 抓取前悬停验证(4–7 次调用):`look_at` -> `goto(z=0.04)`(验证青色 `[ + ]` 括号是否跨在目标上)-> `grasp` -> `place_until_contact` -> `done`
   - 精细视觉伺服(8–20 次调用):`look_at` -> `grasp` -> 预姿态 `goto` -> 闭环 `move_by` / `move_until_contact` -> `done`
3. 发送运动原语(`POST /plan`),并在每一回合后通过更新后的 `wrist_cam.png` 进行视觉验证。如果 `status == "grasp_failed"`,请调用 `robot.look_at(...)` 重新观察并恢复闭环控制。

## Code-as-Policies 原语 (`POST http://127.0.0.1:8081/plan`)
robot.look_at(x=0.35, y=0.13, z=0.14, grid_z=0.015)
x, y = robot.deproject(u=0.52, v=0.48, z_plane=0.015)
robot.grasp(x=x, y=y, z=0.015, yaw_deg=-35, pitch_deg=90)
robot.place(x=0.24, y=0.06, z=0.075)
robot.place_until_contact(x=0.24, y=0.06, z=0.015, max_lag=0.012, relief=0.002)
robot.goto(x=0.28, y=0.05, z=0.04, arc_z=0.14, pitch_deg=25, azimuth_deg=90, roll_deg=0, speed=0.10)
robot.move_by(forward=0.025, dz=-0.002, dpitch_deg=-3, droll_deg=5, speed=0.04)
robot.move_until_contact(dz=-0.06, speed=0.03, max_lag=0.012, relief=0.002)
纯文本已复制
3. Omni 控制
Argon 在 Gemini Omni World Model 中操控机器人,将五个散落的 Scrabble 字母块(G, R, A, N, O)重新排列成一行,拼写出 A - R - G - O - N。Argon 并非指定一个静态提示词,而是在闭环视觉回路中进行引导。它编写带时间戳的动作提示词,检查中间 rollout 的关键帧,并不断优化其提示词。
抱歉,您的浏览器不支持播放此视频
迭代式视频世界模型引导灵巧手:33 步引导视频 Rollout 拼写 A-R-G-O-N。
提示词:
Goal: {task_goal}

<omni_prompt>
[00:00.000] The left hand remains retracted at the side, keeping the workspace clear for camera visibility. The right hand reaches toward the target object on the table.
[00:02.500] The right fingertips push the object smoothly into the center of the table, leaving its starting area empty.
[00:05.000] The right hand opens and retracts to the side so all placed objects remain in clear view of the camera.
</omni_prompt>

在仿真启动之前,你可以调整以下内容:
(1) 静态物体资产:逼真的几何形状、碰撞体、质量、惯性、摩擦力和关节,外观需接近真实物体,以及 t = 0 时的初始物体姿态。
(2) 离线规划的机器人指令,仅在真实指尖靠近物体的帧中进行修改。每条指令必须保持在记录的遥操作轨迹的 0.55 rad(手臂关节)和 0.65 rad(手部关节)范围内。在其他所有地方,原样重放记录的轨迹。

禁止仿真作弊:任务物体只能通过机器人手与环境之间的真实 MuJoCo 接触(mj_step)来移动。
t = 0 之后不允许的操作:更改 MjModel 参数;对物体施加外力或力矩;焊接或等式约束;超出关节空间 PD 控制的前馈力矩;设置或回滚物体的 qpos/qvel;禁用或排除碰撞;报告非来自 MuJoCo 求解器的接触力(例如,复制记录的触觉读数)。

立即以交互式 HTML 会话查看器形式呈现重建的场景和 rollout 结果,每个 episode 一页,显示:
- 底部:同步时间轴(播放、拖动、速度控制),驱动所有面板。
- 左侧面板:交互式 3D Blender 场景,显示仿真的机器人和物体,随着回放进度显示接触点和力箭头。
- 右侧面板:所有 3 个摄像头的真实与仿真视图并排对比。真实与仿真手指力的可视化。
纯文本已复制
2. 人类视角到仿真
给定一段第一人称的人类操作任务视频,Argon 识别出任务相关的物体,将粗糙的边界框替换为用于凹形容器的复合凸分解网格,并将人手轨迹重定向到具有 76 自由度双臂人形机器人及 22 自由度五指手的 MuJoCo 接触物理模型中。
抱歉,您的浏览器不支持此视频播放
人类视角到仿真 — 从第一人称人类视频到灵巧人形孪生体:左侧显示输入的第一人称人类 RGB 视频;右侧显示同步的 500 Hz MuJoCo + Blender Cycles 多视角仿真 rollout。
提示词:
[Attached: egocentric_human_video.mp4, candidate_sim_views.png, hand_3d_keypoints.json]

你正在构建一个物理可解的 500 Hz MuJoCo 操作环境(`scene.xml`)以及 Blender 工作室渲染,以忠实复现 `egocentric_human_video.mp4` 中展示的双臂人形机器人桌面任务,该机器人配备具有 22 自由度的灵巧五指手:

1. 场景重建与相机标定:
   - 仅识别与操作相关的物体(被抓取的目标物体和接收容器或地标),并从第一人称视角相机的内参/外参三角测量其 3D 桌面坐标。
   - 用复合凸分解 3D 网格替换粗糙的边界框,使凹形容器(嵌套碗、凹槽木托盘、开放式料箱)能够支持物理内部放置。

2. 500 Hz 灵巧运动拟合压力测试:
   - 将 3D 人类手腕和手指关键点重定向到人形机器人的 7 自由度手臂和 22 自由度手部关节,并在 MuJoCo 中以 500 Hz(dt = 0.002s)步进轨迹,且无零运动学焊接约束。
   - 验证拇指与手指的对向力封闭、清洁的物体提升(> 2 cm)以及在目标地标内部或旁边的稳定最终放置。

### **3. 从草图到仿真**

借助 Argon,开发人员可以拍摄一张粗略的纸笔草图照片——显示 Apollo 2 人形机器人沿抛物线弧线投掷球体,以推倒桌上 3-2-1 堆叠的箱子——Argon 会自动构建 GPU 加速的 `mujoco_warp` 场景,合成平衡的 76 自由度全身及五指投掷轨迹,在闭环物理中验证 6/6 目标击倒,并导出 Blender 4.5 Cycles 渲染结果。

抱歉,您的浏览器不支持此视频播放

草图到仿真 — 手绘草图转换为灵巧人形机器人轨迹 & Cycles 渲染。

*提示词:*

```plaintext
[附件: hand_drawn_throw_sketch.jpg]

将此手绘草图转换为 `mujoco_warp` 中的物理验证人形机器人仿真,以及光线追踪的 Blender Cycles 视频:

1. 基于草图的场景与运动学设置:
   - 解析 `hand_drawn_throw_sketch.jpg` 中的空间布局:将 76 自由度人形机器人(32 自由度身体配备两个 22 自由度五指灵巧手)放置在原点,面向一张桌子,桌上有一个由 6 个刚性目标箱子组成的 3-2-1 金字塔结构,右手五指手中抓握着一个投射球体。

2. 全身平衡与灵巧投掷合成:
   - 合成一个 50 Hz 的全身投掷轨迹(140 步,2.80 秒),涵盖四个阶段:(1) 稳定站立姿态及五指强力抓握闭合,(2) 躯干/肩部蓄力并伴随踝-髋关节质心补偿,(3) 向前鞭打式加速,以及 (4) 在手部速度峰值时同步张开 22 自由度的五指,使球沿抛物线轨迹射入金字塔第二层中心。
   - 在 `mujoco_warp` 接触物理环境中验证人形机器人保持直立平衡(骨盆漂移 < 3 cm)并击倒全部 6 个目标方块。
Plain text Copied
借助 Argon 解锁物理理解能力
1. 后见标注与数据质量
Argon 具备对灵巧操作的精确物理理解能力,能够从视频中提供详细的分割和文本标注。Argon 能够识别操作不佳的片段,例如停顿、不稳定的抓握和失误。给定一段双臂 ALOHA 2 机器人在 136 秒内将一张正方形纸折叠成折纸狐狸的俯视视频,Argon 生成了一个时间对齐的四层级后见标注层次结构:Episode Goal(G1)、6 个连续的 Semantic Subtasks(G2)、17 个接触级 Atomic Primitives(G3),以及自动 Quality Control (QC) 重加权机制,该机制在发生失误和重试期间保持任务进度不变。
Sorry, your browser doesn't support playback for this video
Argon Multi-Granularity Hindsight & Telemetry HUD.
Prompt:
[Attached: Aloha2_Origami_20250309.mp4]

Produce a time-aligned multi-granularity hindsight annotation JSON with four levels:
1. G1_episode_instruction: Concise imperative sentence describing the overall manipulation goal.
2. G2_subtasks: Contiguous semantic subtask phases specifying which arm(s) anchor vs. fold/rotate the object.
3. G3_atomic_primitives: Fine-grained contact-level primitives (3–15s) aligned with grasp closure, crease sweeps, release, or retry attempts.
4. quality_control_and_reweighting: Hold task_progress_pct flat during non-progressing slip/delamination retry loops and downweight them (0.15x–0.25x) for Behavior Cloning.
Plain text Copied
2. 找出那个不同的球
为了用机器人重现经典的 12 球天平称重谜题,Argon 构建了一个双臂 Franka FR3 MuJoCo 环境,其中包含 12 个外观完全相同的台球(其中一个秘密地较重或较轻)以及一个可活动的罗伯瓦尔双盘天平。随后,他们编写了一个仅依赖视觉的闭环求解器,该求解器通过立体 RGB 相机对球体进行三角测量定位,在每次称重后视觉读取天平的倾斜状态,并在 3 次称重内将异常球隔离到重球(红色)或轻球(蓝色)托盘中。
抱歉,您的浏览器不支持播放此视频
寻找异常球(仅视觉闭环求解器):双臂 Franka FR3 在金/青色托盘上称量候选球,读取立体天平倾斜度,并在 3 次称重内将确认的重异常球隔离至红色托盘。
提示词:
# Prompt 1 — Physics-Accurate MuJoCo Environment & Benchmark Generation
Make a MuJoCo environment where a dual-arm robot (two 7-DoF Franka FR3 arms with parallel-jaw grippers on a shared tabletop) is tasked to solve the classic 12-ball balance scale weight puzzle from https://www.mathsisfun.com/pool_balls_solution.html.
1. Create 12 visually indistinguishable pool balls in a 2x6 starting rack (11 standard 150 g, 1 odd ball either 270 g or 30 g).
2. Build a functional two-pan Roberval balance scale at the center of the table with parallelogram equality constraints (`mjEQ_JOINT`) so the Left (Gold) and Right (Teal) pans stay horizontal, plus Red (Heavy) and Blue (Light) submission trays.
3. Track distinct settled weighings (`weighing_count`) and reward `1.00` for isolating the true odd ball in the correct Heavy/Light tray within <= 3 weighings.

# Prompt 2 — Closed-Loop Vision-Only Solver
Implement an independent closed-loop policy relying strictly on stereo RGB camera inputs (`head_camera_left_rgb_image`, `head_camera_right_rgb_image`) and robot proprioception (`add_privileged_task_observations=False`):
1. Segment the 12 balls, Gold/Teal pans, and Red/Blue trays in both stereo views and triangulate their 3D coordinates.
2. Visually read the balance scale tilt after each weighing from stereo vertical pixel disparity (+1 = left heavier, -1 = right heavier, 0 = balanced).
3. Rotate the gripper wrist yaw by 90 degrees when grasping/placing inside the narrow scale pans to clear the raised rims, and isolate the odd ball into the Red or Blue tray within <= 3 weighings.
Plain text Copied
3. 价值函数
Argon 是一种面向机器人任务的通用价值函数。在基于人类 UMI 数据集的一段 60 秒双臂环分拣任务片段上进行评估时,Argon 会迭代检查同步的头相机、左夹爪和右夹爪视频流,重点关注接触转换时刻,从而生成密集的价值函数/任务进度预测,并将轨迹分解为具有正向、中性和负向进度斜率的 28 个片段。
抱歉,您的浏览器不支持播放此视频
价值函数:同步的三摄像头 UMI 回放(头部、左夹爪、右夹爪),与动画化的任务进度曲线及双臂分段标注锁定对齐。
提示词:
[Attached: umi_head.mp4, umi_left_gripper.mp4, umi_right_gripper.mp4]

Look at 3 videos of human wearing a gripper performing activities from head, left, right gripper views. Look at the videos thoroughly and give a detailed plot of progress at the task (with positive, neutral, negative slope), identifying important segments in the video and labeling the activities. Look at individual frames or subsegments of the video if necessary to get a better understanding.
Plain text Copied
通过 Argon 解锁研究与自我改进
1. 通过仿真实现动作改进
Argon 可以在仿真环境中生成新数据,以提升通用视觉-语言-动作(VLA)模型的性能。从一张真实桌面的 RGB 照片开始,Argon 自主构建一个经过校准的 MuJoCo 仿真孪生体,定义新任务,并合成闭环运动生成器以收集超过 4,500 个域随机化仿真回合——这将真实世界物理机器人的成功率从 56% 提升至 75%,并将完成时间从 35 秒缩短至 24 秒。
抱歉,您的浏览器不支持播放此视频
通过仿真实现动作改进:提升了真实世界评估基准的表现(成功率从 56% → 75%,完成时间从 35s → 24s)。
提示词:
[Attached: real_tabletop_photo.jpg]

你有一张俯视 RGB 相机照片(`real_tabletop_photo.jpg`),拍摄的是一个双臂机器人工作区(两个配备平行夹爪的 7 自由度 Franka FR3 机械臂,以及 4 个 RGB 相机),面向一张摆放着照相亭派对道具的桌子。
1. 为所有 9 件派对道具重建程序化 3D 网格和复合 MuJoCo 碰撞基元,使其匹配真实世界的尺寸、颜色和静止姿态,包括用于柔软毛绒帽子的弹簧铰链式可变形冠部面板。
2. 定义一个包含 77 项任务的单臂和双臂课程(抓取放置、扶正、定向推动、空中交接、双臂舀取并推动,以及流水线式桌面清理)。
3. 合成一个闭环逆运动学(IK)轨迹生成器,覆盖 ±10 cm 的姿态随机化,在 MuJoCo 物理环境中验证 `reward == 1.0`,并导出超过 4,500 个 episode 用于 VLA 微调。

### **2. 视觉抓取与放置的自我改进**

在一个简单的 6 自由度机械臂上,Argon 通过试验和自我反思,迭代地提升抓取与放置任务的执行速度和放置精度。

抱歉,您的浏览器不支持播放此视频

SO-101 视觉引导抓取与放置 — 跨迭代 1 → 2 → 3 的硬件自我改进:迭代 1(58.9秒),迭代 2(22.9秒,放下时擦过盒子边缘),以及迭代 3(17.4秒,正中落下)。

*提示词:*

```plaintext
# Stage 1 — Measure Objects & Dry-Run Plan (No Hardware Motion)
Stage 1: measure objects — find the objects and plan the whole motion. The arm does not move in this stage.

A. I put a LEGO brick and a box on the table in front of the arm, and the wooden box to one side. Find the brick and the wooden box in the image. And also in the real world. Show this in an annotated image.

B. A dry-run plan (no hardware). Write the planner to pick and place the lego block. Print the plan table, draw all poses onto the overhead image, and stop. Do not move the robot.
Report with evidence.

# Stage 2 — Pre-Pick Hover & Wrist-Camera Verification
Stage 2: Put the gripper above the brick without touching it, and verify with the wrist camera that the arm and the vision agree. Please record executions with both cameras (compressed video is OK).

# Stage 3 (Autonomous Pick-and-Place → Self-Improvement → Optimization):
1. Execute autonomously: Turn the Stage 1 dry run into a real grasp, lift, and place into the wooden box. Run it yourself subject to safety rules from AGENTS.md.

2. 自我改进:当尝试失败时,自行诊断。审查自己的日志和腕部/俯视视角视频,找出根本原因,在试运行中验证修复方案,然后重试。

3. 基于反馈优化:一旦成功,在安全限制内(规则 R5)将其速度至少提升 2 倍,除非我授权进一步提速或提供反馈。
纯文本已复制
3. 在 MuJoCo WebAssembly 中通过单条提示复现机器人学论文
Argon 只需针对每篇论文输入一条提示,即可阅读机器人控制手稿及任何发布的检查点,将物理模型和闭环控制器(从 DeepLoco 中的 7 网络分层运动控制和 HUSKY 中的 50 Hz PPO 执行器,到 Whole-Body MPC 中的 Web Worker iLQR)移植为自包含的 MuJoCo WebAssembly 浏览器实验环境,并在无头 Chromium 中进行验证。
抱歉,您的浏览器不支持播放此视频
五篇里程碑式的足式与人形机器人论文在浏览器中实时运行(MuJoCo WASM):Robotic Soccer OP3 1v1、DeepLoco、Massively Parallel Deep RL ANYmal C、Whole-Body MPC Go2 以及 HUSKY G1 滑板运动(由 Argon 复现的 68 个交互式浏览器沙盒之一)。
提示词:
[附件: paper.pdf, optional author_checkpoints/ or urdf_assets/]

从头开始使用 MuJoCo WebAssembly 复现论文 "<Paper Title & arXiv ID>",并部署一个自包含的浏览器实验环境 + 视觉文章:
1. 在 MuJoCo XML 中精确匹配论文的物理时间步长、执行器增益 (kp/kv)、扭矩限制和运动学约束,并使用 JavaScript 以论文指定的精确控制频率运行真实的神经网络推理或 Web Worker iLQR。
2. 构建 `index.html`(带有相机预设、实时遥测图表和扰动注入功能的 Spatial UI 模拟器)和 `scrollytelling.html`(交互式视觉文章)。
3. 运行无头 Chromium (Playwright) 验证循环,断言控制台错误数为 0,且在 300+ 帧内任务进度非零。
纯文本已复制
利用 Argon 推进具身智能
Argon 融合了编程、视觉感知、物理仿真和具身机器人控制。通过对多视角视频、3D 几何、接触力学和本体感觉遥测数据进行原生推理,Argon 不仅理解场景中物体是什么,还理解它们如何与智能体进行物理交互以完成全身灵巧任务。Gemini 4 Argon 标志着加速迈向物理通用人工智能(Physical AGI)的重要里程碑。通过构建这一核心智能,我们的目标是赋能能够与人类协作解决复杂挑战的机器人技术。
入门指南
您现在即可在 Google 的开发者平台上开始使用 Gemini 4 Argon 进行构建: