OpenAI 发布 HealthBench 基准 评估 AI 医疗对话能力
OpenAI 推出 HealthBench 和 HealthBench Professional 两项新基准,用于评估大模型在真实健康对话中的表现。HealthBench 包含 5000 个日常用户场景,而 Professional 版聚焦 525 个高难度临床医生场景,均依据医生制定的评分标准从准确性、完整性等五个维度进行打分。
报道正文
我们即将上线 HealthBench 和 HealthBench Professional 排行榜,这两个基准测试旨在评估 AI 模型在真实健康对话中的响应表现
HealthBench 和 HealthBench Professional 是 OpenAI 推出的基准测试,它们依据医生制定的评分标准(rubrics),对模型在真实健康对话中的回复进行打分。
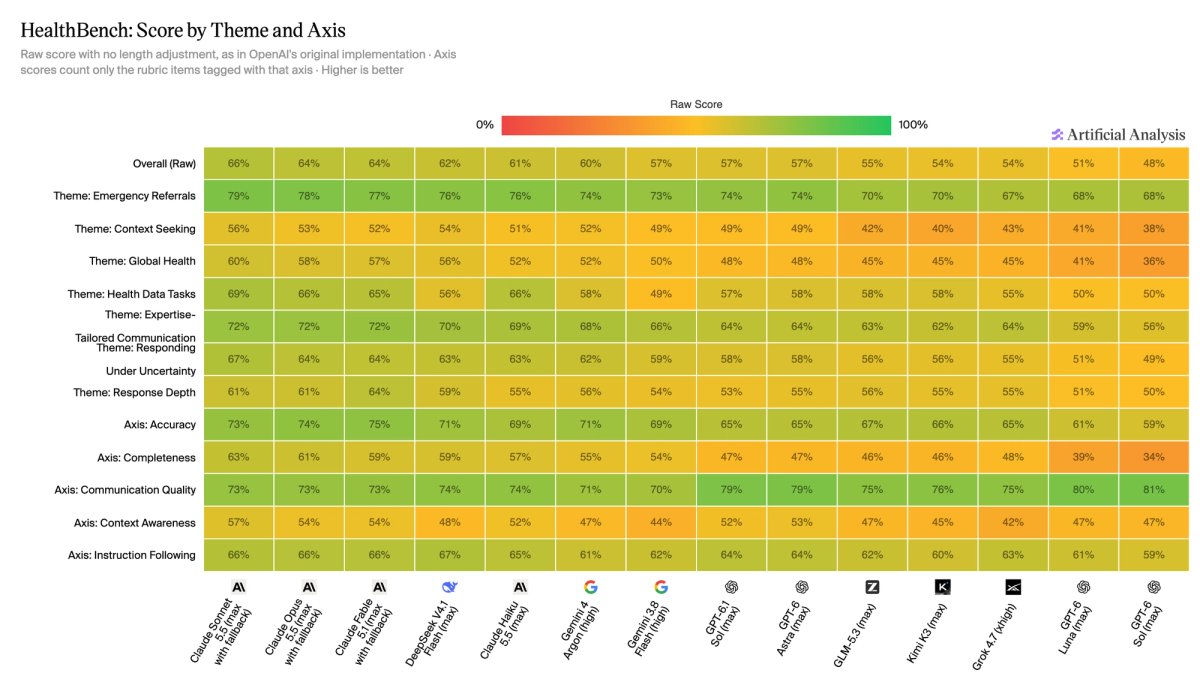
HealthBench 使用 5,000 个与普通用户及医疗工作者进行的健康对话来测试模型。这些对话涵盖从急诊转诊到全球健康等七大主题,每个评分标准均归属于五个维度之一:准确性、完整性、沟通质量、情境感知以及指令遵循。HealthBench Professional 则是一个包含 525 个对话的较小数据集,与 HealthBench 不同的是,其所有对话对象均为临床医生。这些对话涵盖咨询、写作和研究任务,并包含专门设计用于挑战模型的对抗性和高难度对话。
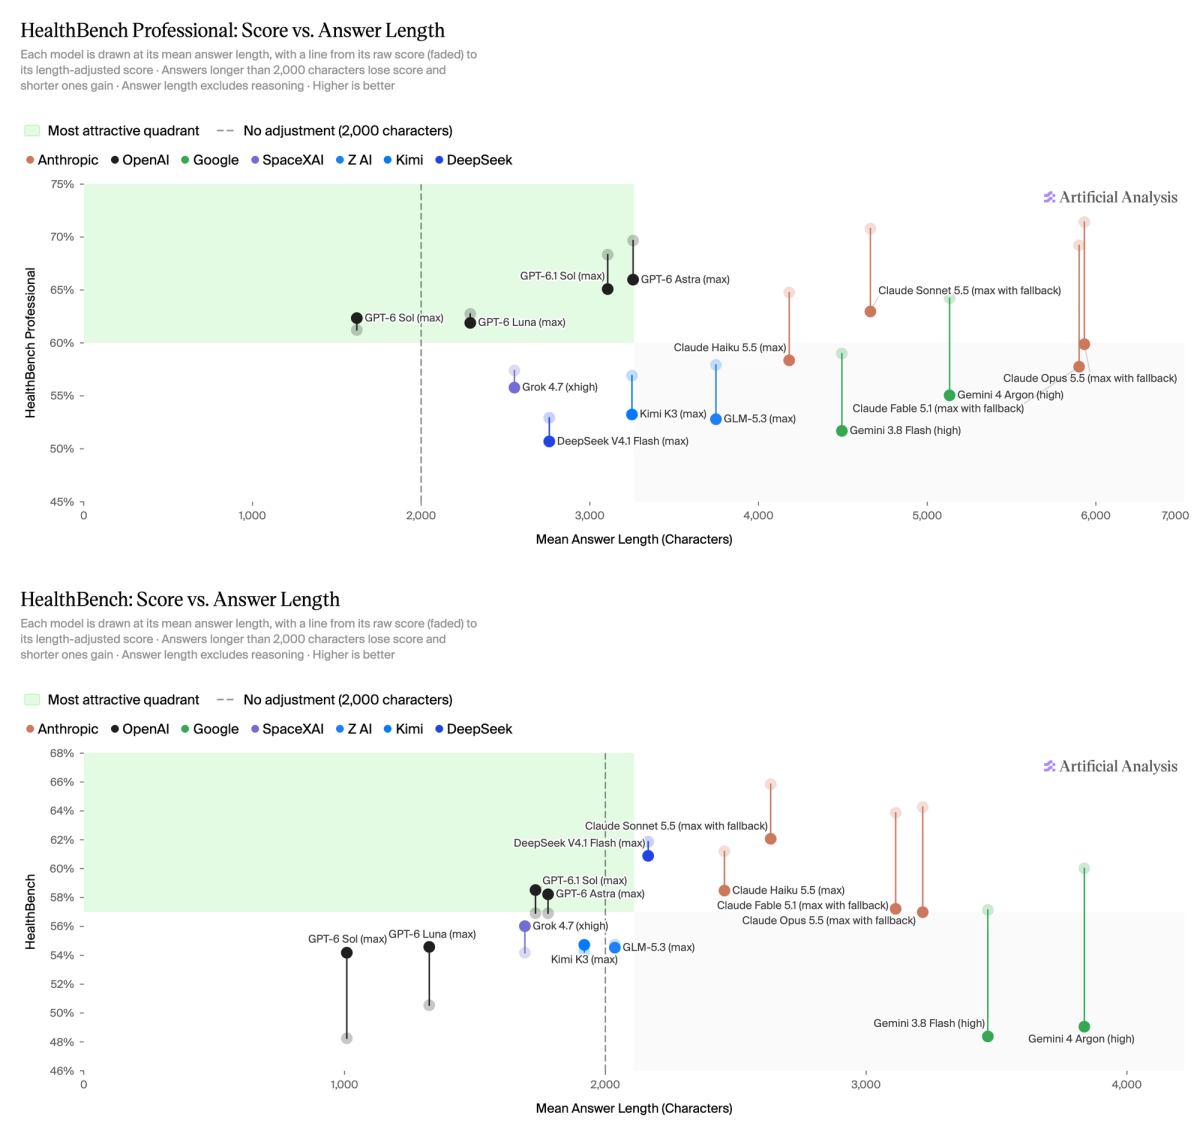
我们同时报告原始得分(获得的评分标准分数占比)以及 OpenAI 报告的长度调整得分。长度调整得分会降低超过 2,000 字符的回复得分,并提高较短回复的得分。与 OpenAI 最初的实现方式一致,HealthBench Professional 由 GPT-5.4 (low) 进行评分,而 HealthBench 则由 GPT-4.1 进行评分。
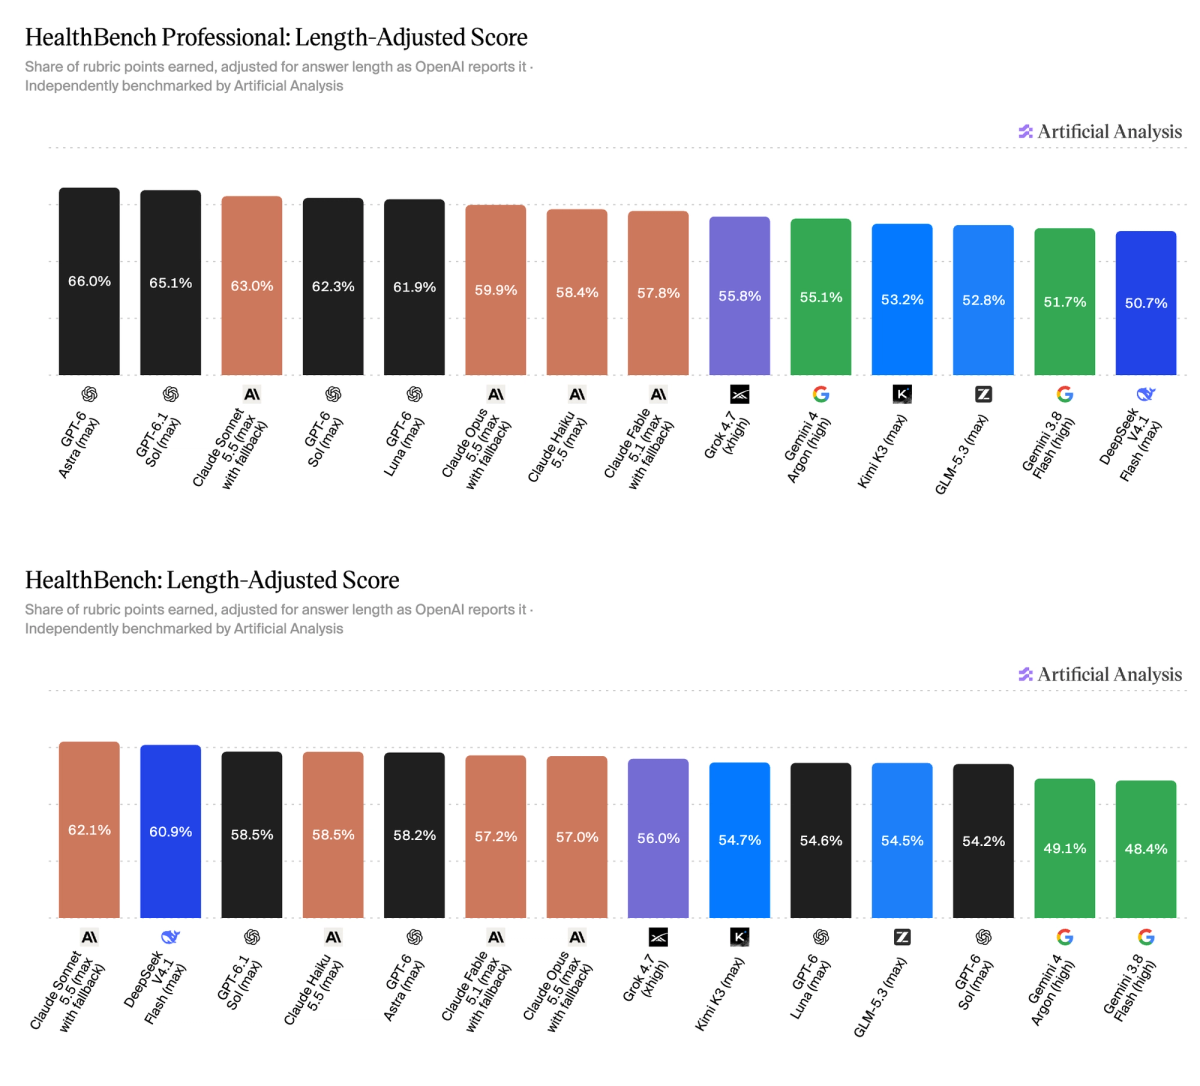
HealthBench Professional 的关键结果:
➤ GPT-6 Astra 和 GPT-6.1 Sol 位居榜首: GPT-6 Astra (max) 的长度调整得分为 66.0%,与 GPT-6.1 Sol (max, 65.1%) 相当,并领先于 Claude Sonnet 5.5 (max with fallback, 63.0%)
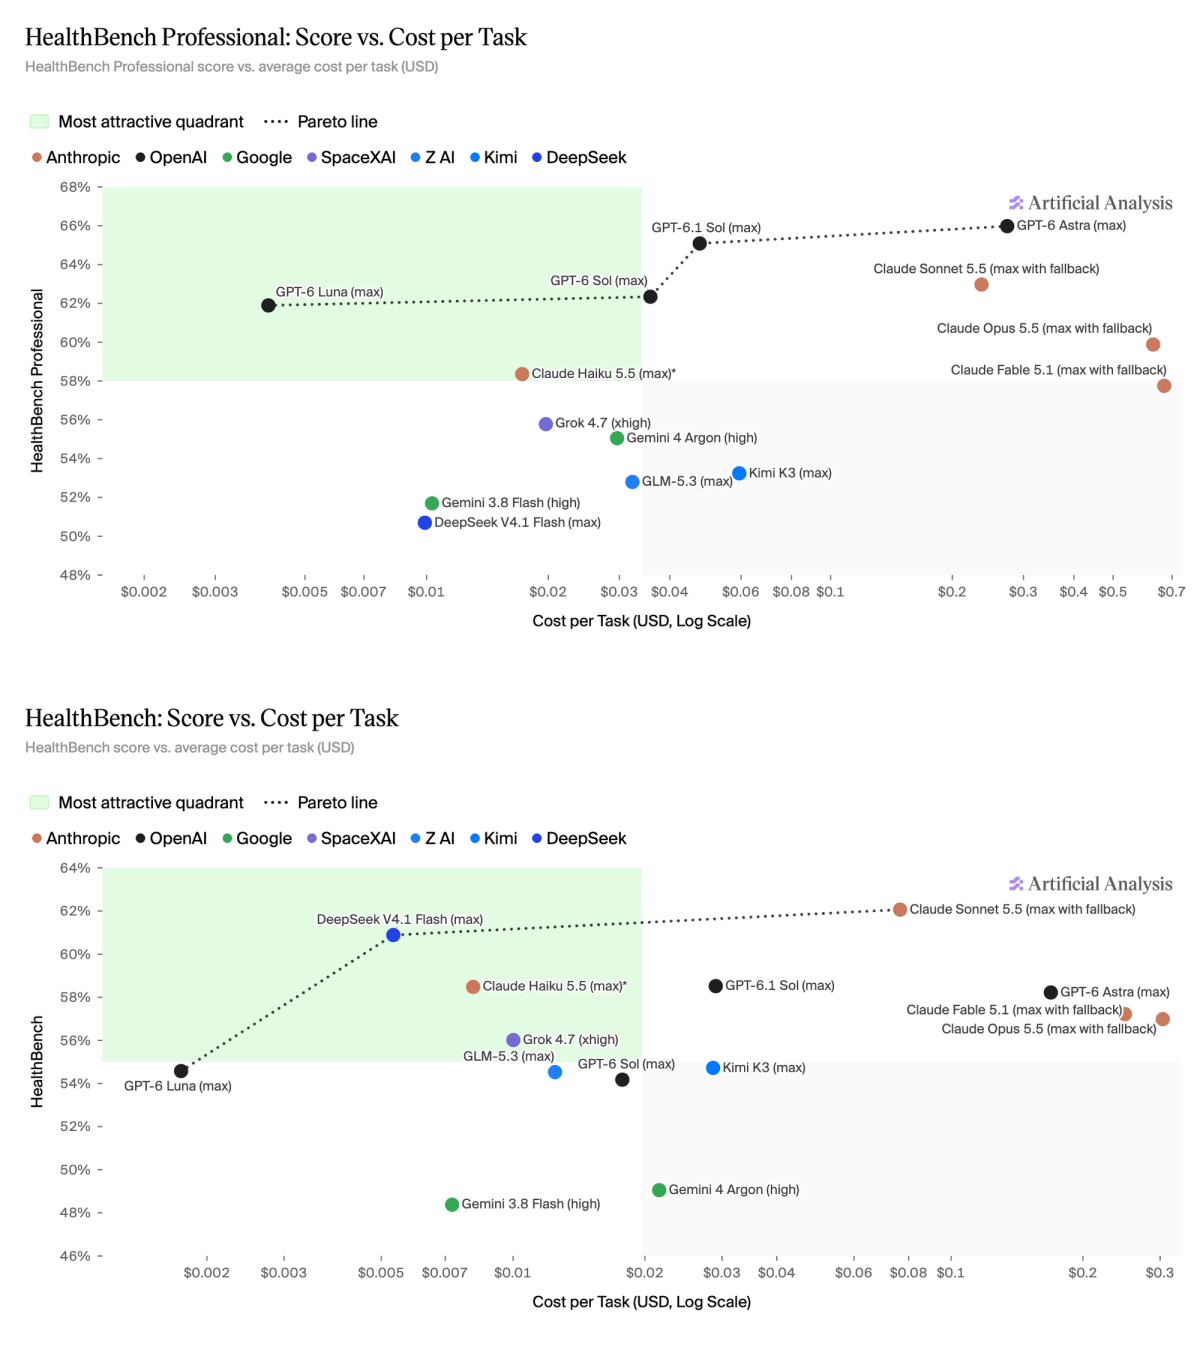
➤ OpenAI 模型构成了“得分 vs. 单任务成本”帕累托前沿的全部成员: 帕累托前沿包括 GPT-6 Luna (max, 61.9%, 每任务 $0.004)、GPT-6 Sol (max, 62.3%, $0.036)、GPT-6.1 Sol (max, 65.1%, $0.047) 以及 GPT-6 Astra (max, 66.0%, $0.27)。GPT-6 Luna (max) 的得分比 GPT-6 Astra (max) 低 4 分,但成本不到后者的 2%
➤ Claude Opus 5.5 和 Claude Fable 5.1 受到最大的长度惩罚: 两者的平均回答长度约为 5,900 字符,几乎是 2,000 字符阈值的 3 倍,调整后得分损失超过 11 分。Claude Opus 5.5 (max with fallback) 拥有最高的原始得分 (71.4%),但调整后排名降至第六 (59.9%)。GPT-6 Sol (max) 是唯一一个平均长度低于 2,000 字符 (~1,600) 的模型,也是唯一一个得分因调整而上升的模型
HealthBench 关键结果:
➤ Claude Sonnet 5.5 在 HealthBench 中位居榜首: Claude Sonnet 5.5(max 模式含 fallback)在长度调整后的得分中达到 62.1%,领先于 DeepSeek V4.1 Flash(max 模式,60.9%)和 GPT-6.1 Sol(max 模式,58.5%)
➤ GPT-6 Luna、DeepSeek V4.1 Flash 和 Claude Sonnet 5.5 构成了“得分 vs. 单任务成本”的帕累托前沿: GPT-6 Luna(max 模式)的单任务成本为 $0.002,得分为 54.6%;DeepSeek V4.1 Flash(max 模式)的单任务成本为 $0.005,得分为 60.9%。Claude Sonnet 5.5(max 模式含 fallback)的平均单任务成本为 $0.08,比 DeepSeek V4.1 Flash 高出约 16 倍,但得分仅提升约 1 个百分点
➤ 较短的回答以完整性换取沟通质量: HealthBench 中的每个评分项都归属于五个维度之一。“完整性”检查回复是否包含所有重要信息,而“沟通质量”则评估回复是否清晰、结构良好,且长度和详细程度适中。GPT-6 Sol(max 模式)生成的回答最短(约 1,000 字符),其原始“沟通质量”得分最高(81%),但“完整性”得分最低(34%)。Claude Sonnet 5.5(max 模式含 fallback)在“完整性”方面表现最佳(63%)
查看完整排行榜,请访问:
➤ HealthBench Professional: https://artificialanalysis.ai/evaluations/healthbench-professional
➤ HealthBench: https://artificialanalysis.ai/evaluations/healthbench