亚马逊提出 HOPE 高阶专家剪枝 让 MoE 模型内存占用大幅下降
亚马逊团队提出 HOPE 高阶专家剪枝方法,针对混合专家(MoE)大模型推理时专家 MLP 占用绝大部分显存、但每个 token 仅激活少数专家的问题,通过考虑专家之间的耦合关系而非独立评估来删除冗余专家。以 Qwen3.5-122B 为例,其 48 个 MoE 层每层 256 个专家,约 250 GB 参数中 95% 来自专家 MLP,而每 token 每层仅用 8 个,剪枝空间巨大。
报道正文
本文目录14 个章节
你的专家各有搭档。有希望让它们保持在一起
企业文章 发布于 2026 年 11 月 9 日 点赞 - Alex M Tseng alexmtseng 关注 amazon
混合专家语言模型中专家的高阶剪枝
引言
混合专家(MoE)模型使最先进的 LLM 得以扩展到数千亿参数,但它们也带来一个根本性且代价高昂的隐患:每个专家 MLP 在推理时都必须占用内存,尽管对于任意给定 token,绝大多数专家都处于闲置状态。例如,Qwen3.5-122B 在其 48 个 MoE 层中每层都有 256 个专家,而其约 250 GB 的参数内存占用中,有 95% 完全由这些专家 MLP 占据。然而,对于任意给定 token,每层实际只用到 8 个专家。
专家剪枝是解决这一内存瓶颈最直接的方法之一。也就是说,永久删除最无用的专家。剪枝避免了使专家动态加载/卸载变得不切实际的延迟问题;它不需要任何训练;并且它可以与量化组合使用。鉴于这些诱人的优势和思路的简洁性,不难理解为何专家剪枝已成为缩小 MoE 的首选方法。难点在于决定哪些专家删除最安全。
现有剪枝方法对每个专家独立评分,为每个专家分配一个标量重要性分数(基于校准数据集),并(在每层内独立地)剔除最不重要的专家。这些是一阶方法,因为它们假设每个专家的贡献与其他所有专家无关。而在现实中,专家会组成协作群体。我们在自己的实验中观察到一致的共激活专家簇,并且独立研究已表明专家协作是 MoE 的一种稳定特性,且对模型性能很重要。忽视这些交互会导致次优的剪枝效果,在激进的剪枝率下尤其如此。
我们的最新论文 推导出了 HOPE(Higher-Order Pruning of Experts,专家高阶剪枝),这是一种二阶方法,能够考虑专家之间的成对交互。在 50% 剪枝率下,HOPE 取得了所有方法中最佳的平均排名,在智能体编程任务上相比次优剪枝方法最高提升 +6.1%。
在这篇文章中,我们将解释 HOPE 的工作原理,展示它在哪些方面优于现有方法,并逐步说明如何将其用于你自己的模型。对于不熟悉 MoE 架构的读者,请参阅 Transformer 中的混合专家模型(MoE)。
专家并非独立工作
在标准 MoE 中,每一层有 EEE 个专家,每个输入 token xxx 被独立路由到 KKK 个这样的专家( K=8 K = 8 K=8 是典型选择)。路由由单层执行,该层为每个专家 kkk 生成经 softmax 归一化的门控权重 gk(x)g_{k}(x)gk(x),其中门控权重最高的 KKK 个专家被选中,构成活跃专家集合 T(x)⊂{1,..,E}T(x) \subset{1,..,E}T(x)⊂{1,..,E}。该层的输出则为 ∑k∈T(x)gk(x)fk(x)\sum\limits_{k\in T(x)}g_{k}(x)f_{k}(x)k∈T(x)∑gk(x)fk(x),其中 fk(x)f_{k}(x)fk(x) 是专家 kkk 对 token xxx 的输出。

左图:典型的 MoE 层,每个 token 被路由到 top-K 专家。右图:一阶方法基于标量重要性分数对专家进行排序和删除,但最佳的剪枝决策还应考虑专家之间交互的强度。
重要的是,被选中集合 T(x)T(x)T(x) 中的专家并非相互独立。专家会形成稳定的协作组,并持续被共同激活。这一点此前已在文献中被观察到:专家共同选择模式在训练早期就会出现,并在整个训练过程中保持稳定。
这意味着,当我们从 MoE 层中剪枝专家时,剪枝决策需要考虑这些专家之间的高阶效应。单独移除专家 A 可能看起来没问题,但如果专家 B——它经常与 A 协作并依赖 A——非常重要,那么移除 A 就会仅仅通过一次删除就瓦解一个协作组。一阶方法完全忽略了这一点,因为它们分别对 A 和 B 打分。
这种效应在高剪枝率下会进一步放大。当我们最多移除 50% 的专家时,就有可能破坏许多协作链路。这正是二阶剪枝最具优势的场景。
HOPE 如何确定剪枝集
(HOPE 目标的完整推导见我们对应论文的附录 A)
当我们从某个 MoE 层中删除一组 PPP 专家时,被选中的专家集合 T(x)T(x)T(x)(对于任意 token xxx)可能会发生变化。原本会被选中的被剪枝专家,将由门控权重次高的专家替代。由此导致的层输出变化即为剪枝误差。我们的目标是找到一个剪枝集 PPP(在某个预定义的剪枝预算 ∣P∣\vert P\vert∣P∣ 下),使得(在来自校准集的 token xxx 上)产生的剪枝误差最小。
遗憾的是,直接针对 PPP 最小化剪枝误差是难以处理的。剪枝误差取决于替代专家的身份,而替代专家的身份又取决于剪枝集 PPP 本身。HOPE 通过定义一个可处理的替代量 ZZZ 来绕开这一难题,该替代量严格上界剪枝误差的主导分量:
Z=[∑j∈P∩T(x)gj(x)∥fj(x)∥2]2≥true errorZ = \bigl[\sum\limits_{j \in P\cap T(x)} g_{j}(x)\Vert f_j(x)\Vert_{2}\bigr]^{2} \geq \text{true error}Z=[j∈P∩T(x)∑gj(x)∥fj(x)∥2]2≥true error
由于 ZZZ 是平方和,展开后自然会生成专家对之间的交叉项 gi(x)gj(x)∥fi(x)∥2∥fj(x)∥2g_{i}(x)g_{j}(x)\Vert f_{i}(x)\Vert_{2}\Vert f_{j}(x)\Vert_{2}gi(x)gj(x)∥fi(x)∥2∥fj(x)∥2。这些正是被一阶方法丢弃的交互项。
为了找到最优剪枝集,HOPE 在校准集上最小化 E[Z]\mathbb{E}[Z]E[Z],这可以重新表述为如下二次规划问题:
P∗=arg minp p⊤Fps.t.p∈{0,1}E,∑k=1Epk=∣P∣P^{*} = \argmin_{p}; p^{\top}Fp \quad \text{s.t.} \quad p \in {0,1}^{E}, \sum\limits_{k=1}^{E}p_{k} = \vert P\vertP∗=pargminp⊤Fps.t.p∈{0,1}E,k=1∑Epk=∣P∣
其中 F∈RE×EF\in\mathbb{R}^{E\times E}F∈RE×E 定义为:
Fi,j=1∣Xi,j∣∑x∈Xi,jgi(x)gj(x)∥fi(x)∥2∥fj(x)∥2whereXi,j={x,j∈T(x)}F_{i,j} = \frac{1}{\vert \mathcal{X}{i,j}\vert} \sum\limits{x\in\mathcal{X}{i,j}} g{i}(x)g_{j}(x)\Vert f_{i}(x)\Vert_{2}\Vert f_{j}(x)\Vert_{2}\quad\text{where}\quad \mathcal{X}_{i,j} = {x: i,j \in T(x)}Fi,j=∣Xi,j∣1x∈Xi,j∑gi(x)gj(x)∥fi(x)∥2∥fj(x)∥2whereXi,j={x,j∈T(x)}
这个 F 矩阵在校准数据集上收集,并通过求解带有连续松弛的二次规划(QP)获得最优剪枝集(随后舍入为二值解)。每个元素 Fi,jF_{i,j}Fi,j 捕捉专家 iii 和 jjj 在两者共同激活的 token 上的平均门控加权输出乘积。对角元素 Fk,kF_{k,k}Fk,k 衡量个体专家重要性,而非对角元素(i≠ji\neq ji=j 的 Fi,jF_{i,j}Fi,j)衡量成对的协作贡献。
FFF 在实践中是什么样子?它展示了专家协作的结构,而这取决于层:

GLM-4.5-Air(每层 128 个专家,总计 106B 参数)在三个代表性层(早期、中期、晚期)的交互矩阵 F 可视化。专家已被聚类以揭示块结构。沿对角线的明亮块表示具有强成对交互得分的专家组。
就实际成本而言,HOPE 需要与任何其他专家剪枝方法相同的校准过程(在校准数据上进行一次前向传播)。唯一的额外步骤是求解二次规划,该问题是非凸的,但可以通过标准 QP 求解器高效求解(每层 1–2 秒)。与一阶方法相比,总附加开销可以忽略不计,因为校准时间占主导地位。
与 REAP 的联系
值得注意的是,HOPE 与 Router-weighted Expert Activation Pruning (REAP) 有很强的联系,后者是一种最先进的一阶专家剪枝方法。HOPE 的 F 矩阵在对角线上编码了个体专家重要性得分,而该对角线实际上恢复了 REAP 用于独立排序专家以进行剪枝的得分(仅相差专家贡献的方差)。FFF 的对角线几乎完美地恢复了 REAP 的专家排名(Spearman ρ=0.988\rho = 0.988ρ=0.988)。因此,HOPE 相对于 REAP 取得的任何改进都可归因于 FFF 矩阵非对角元素中的二阶交互项。
结果
我们将 HOPE 作为一种专家剪枝方法进行了评估,使用了 3 个模型(Qwen3.5-122B、Qwen3.5-35B 和 GLM-4.5-Air),以及 2 个校准数据集(Evol-CodeAlpaca 和 SWE-Bench Verified 轨迹)。我们使用 Tulu3 套件和 SWE-Bench Pro(智能体编程)来测试剪枝后的模型,在从 10% 到 50% 的剪枝率范围内,将 HOPE 与 4 个一阶基线(REAP、MAN、EAN 和 Frequency)进行了比较。
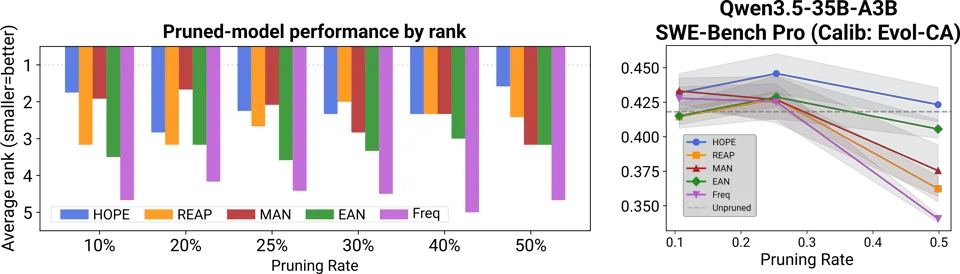
HOPE 在各条件下取得了最佳总体排名,并在激进剪枝率下占据主导地位。左图:在所有模型、校准集和基准上的平均排名(越低越好)。右图:Qwen3.5-35B 在 SWE-Bench Pro 上的表现。
在所有条件下,HOPE 取得了最佳平均排名(5 种方法中排名 2.07),拥有最高的第一名完成率(39% 的条件)和前三名完成率(67%)。在头对头比较中,HOPE 在大多数条件下击败了所有其他基线。
正如预期,HOPE 的优势在更高剪枝率下更加明显。 随着更多专家被移除,更多协作链接被断开,FFF 的非对角项变得更加重要。在 50% 剪枝率下,HOPE 的平均排名提升至 1.58(而次优方法 REAP 为 2.42)。这也是最具部署相关性的设置,此时内存节省足够大,可以容纳更长的上下文、更深的推理和更多的工具调用。
HOPE 的优势在 SWE-Bench Pro 上最为显著,这是一个智能体编程基准,模型必须自主解决真实的 GitHub 问题。这些问题涉及多轮组合多样化的任务(例如编码、工具调用、推理等),并且很可能调用多样化的专家组合——这正是保留协作结构最为重要的场景。在 Qwen3.5-35B-A3B 上以 50% 剪枝率运行时,HOPE 在 SWE-Bench Pro 上达到了 42.3,与未剪枝模型的 41.8 相当(而 REAP 降至 36.2,退化了 13%)。
值得注意的是,剪枝后的模型有时能够达到甚至超越未剪枝的基线,这可能是因为移除低相关性的专家减少了目标任务上的噪声。这一效应并非 HOPE 独有,在多种剪枝方法中均有观察到。此外,我们的实验表明,使用任何剪枝方法(包括 HOPE)进行以代码为中心的校准,都不会严重降低非编码基准的表现,而且无论使用何种校准集,HOPE 在 Tulu3 套件上均表现良好。
HOPE 保留了更多协作型专家
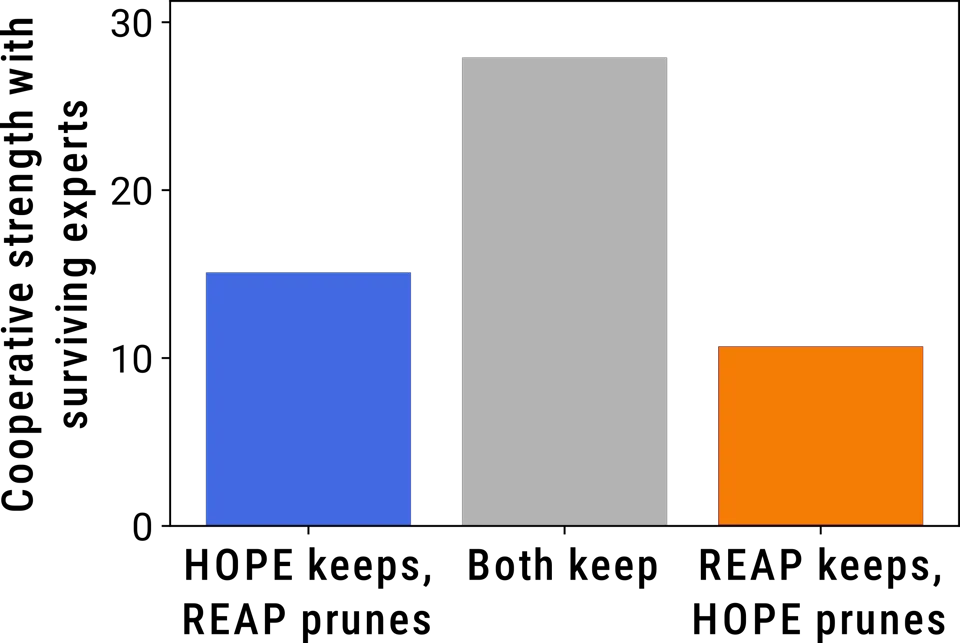
与保留专家之间协作强度的平均值(以 F 矩阵值衡量),按 HOPE 与 REAP 意见不一致的专家分组。
HOPE 的优势源于对整个交互矩阵 FFF 进行优化。为了理解这在实践中如何影响剪枝决策,我们考察了 HOPE 与 REAP 意见不一致的专家。对于每个有争议的专家,我们计算其协作分数(即与其他保留专家之间的平均 F 值)。仅被 HOPE 保留的专家,其协作分数始终高于仅被 REAP 保留的专家。换言之,作为 QP 优化的一部分,HOPE 会牺牲一些个体得分较高的专家,以保留协作集群。基准性能的提升(如上所示)验证了这种权衡是有利的。
如何运行 HOPE
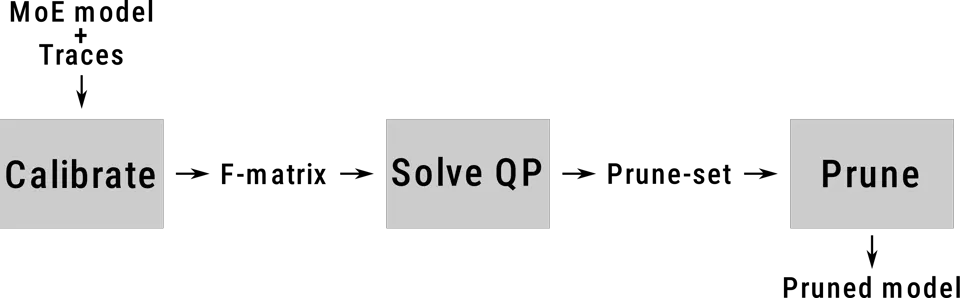
我们创建了一个基础软件包来运行 HOPE。它包含三个步骤:1) 校准;2) 求解;3) 剪枝。我们的软件包已在 Qwen3、Qwen3-Next、Qwen3.5 和 GLM-4.5 上测试过。
步骤 1:校准
hope calibrate \
    --model-path Qwen/Qwen3.5-35B-A3B \
    --prompts calibration_prompts.txt \
    --out-path observations.h5
校准步骤对校准数据(无论是智能体 rollout 还是单轮轨迹)执行一次前向传播。该步骤使用 HuggingFace transformers 挂接到每个 MoE 层的前向传播中。对于每个 token,它会记录哪些专家被选中、其门控权重、输出范数以及成对共激活统计量。该步骤的输出是 F 矩阵,存储在 HDF5 文件中。
步骤 2:求解 QP
hope solve \
    --obs-path observations.h5 \
    --prune-frac 0.50 \
    --out-path pruneset.json
该命令会具体化 F 矩阵,并通过连续松弛求解二元二次规划。每层耗时几秒,输出是一个包含剪枝集的 JSON 文件。从技术上讲,这就是 HOPE 算法的最终输出。
步骤 3:剪枝
hope prune \
    --model-path Qwen/Qwen3.5-35B-A3B \
    --pruneset-path pruneset.json \
    --out-path ./Qwen3.5-35B-A3B-pruned-50
为完成整个流程,我们运行此命令,根据剪枝集实际创建更小的模型检查点。剪枝后的模型是标准的 HuggingFace 检查点,在磁盘和内存中都更小(无需修改 vLLM 或 SGLang 的模型定义)。
我们还发布了一个更紧凑的 Python API:
from hope.calibrate import calibrate
from hope.solve import solve
from hope.prune import prune_model

calibrate("Qwen/Qwen3.5-35B-A3B", calibration_prompts, "observations.h5")
solve("observations.h5", prune_frac=0.50, out_path="pruneset.json")
prune_model("Qwen/Qwen3.5-35B-A3B", "pruneset.json", "./Qwen3.5-35B-A3B-pruned-50")
HOPE 的局限性
HOPE 的优势在较高剪枝率(40–50%)时最为显著。在较低剪枝率(10–20%)下,REAP 和 MAN 等一阶方法有时更具竞争力,HOPE 的优势会缩小。此外,与大多数专家剪枝算法一样,HOPE 独立剪枝每一层,不考虑跨层交互。在我们的论文中,我们提出了跨层 HOPE 的理论框架,但结果仍处于初步阶段。最后,HOPE 捕捉的是成对交互,但更高阶的交互(三元组及更高阶)可能提供额外信号,尽管它们在组合上难以估计。
更多信息
如需了解更多信息,请参阅我们的相关论文和代码库。
论文: https://arxiv.org/abs/2609.18916
代码:https://github.com/awslabs/HOPE
要了解如何将 HOPE 应用于下一代混合架构,请参阅我们的相关仓库。
引用:
@article{tseng2026hope,
    title={Higher-Order Pruning of Experts in Mixture-of-Experts Language Models},
    author={Tseng, Alex M. and Kaul, Prannay and Zancato, Luca and Xia, Wei and Soatto, Stefano},
    journal={arXiv preprint arXiv:2609.18916},
    year={2026},
}