CMU 论文证实混合训练优于分阶段流程
原标题:The separate stages of AI training can collapse into a single method.
78AI 研判分
卡内基梅隆大学最新研究提出一种统一训练规则,将预训练、微调和强化学习数据混合使用。实验表明,这种“数据混合调度”策略在保持通用技能的同时,推理与代码能力表现优于传统的分阶段训练流程。
报道正文
Rohan Paul (@rohanpaul_ai) · 2026-10-30 21
AI 训练的各个独立阶段可以融合为单一方法。
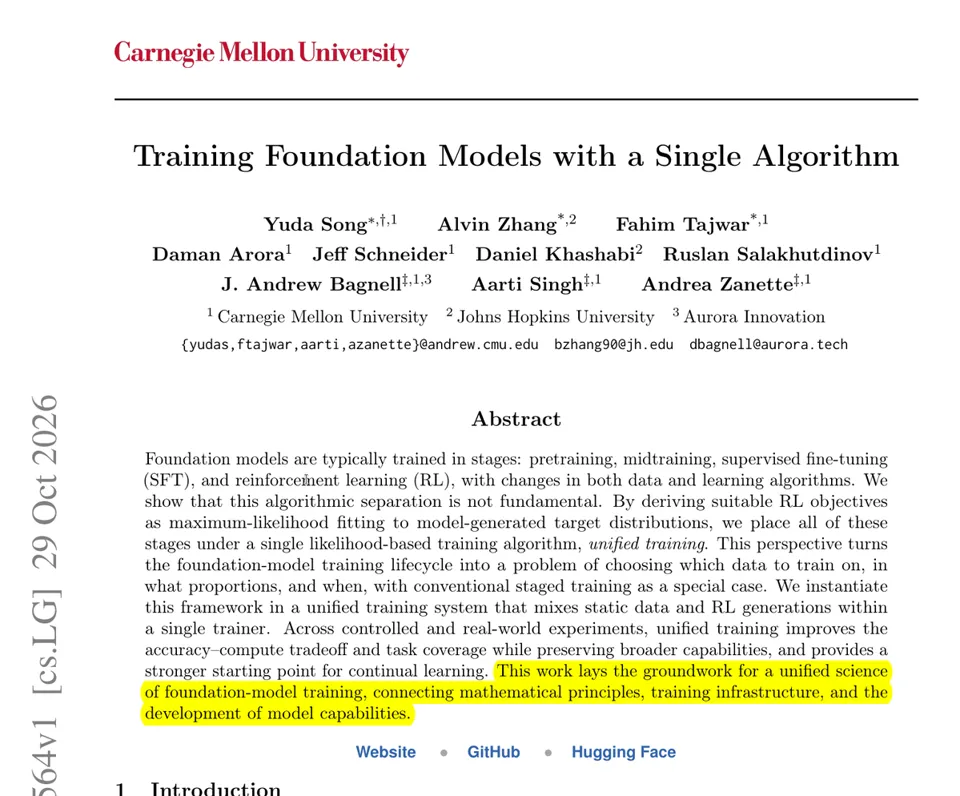
卡内基梅隆大学(Carnegie Mellon)的一篇新论文表明,预训练(pretraining)、微调(fine-tuning)和强化学习(RL)可以共享同一套训练规则,且混合它们的数据往往优于分阶段训练。
大语言模型(LLM)通常分阶段进行训练:预训练、中期训练(midtraining)、微调,然后是 RL,每个阶段都使用各自的算法。阶段之间的硬性切换也可能导致早期习得的技能被遗忘。
作者将一种名为 MaxRL 的 RL 形式重构为基于模型自身正确答案的似然训练(likelihood training)。这使得单个训练器能够随时间以任意比例混合预训练文本、精选数据和 RL 样本。
在使用 1.24 亿参数模型进行的推理谜题测试中,最佳的混合运行表现优于最佳的分阶段运行,并且更好地保留了通用技能。在后续的编码 RL 之后,一个 7.6 亿参数的模型在数学 RL 期间混合了 5% 的中期训练数据,在 MBPP+ 基准上达到了 32.69%,而分阶段训练的模型仅为 29.81%。
请将你的训练流水线视为一个数据混合调度方案,并尝试将早期数据混合进 RL 阶段,而不是突然切换阶段。