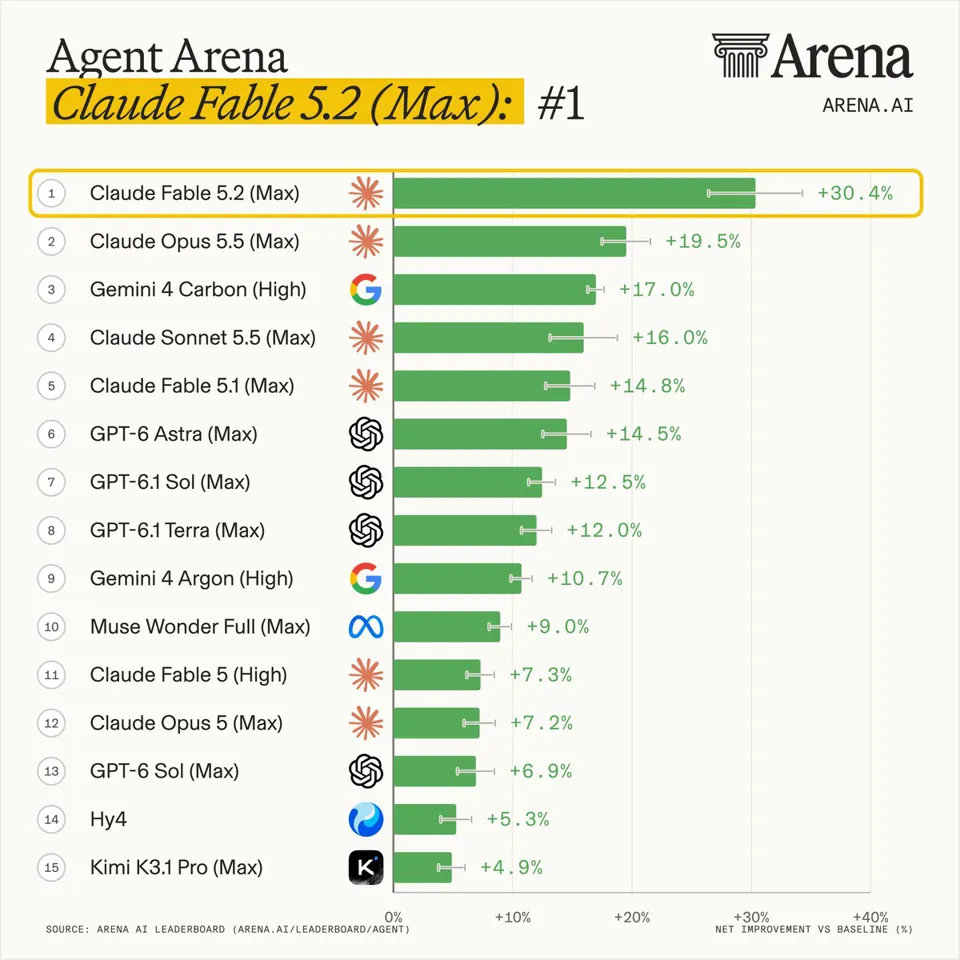
Claude Fable 5.2 登顶 Agent Arena 领先 30.4%
原标题:Big news: Claude Fable 5.2 (Max) by @AnthropicAI takes #1 in Agent Arena with an unprecedented lead:...
88AI 研判分
Anthropic 发布 Claude Fable 5.2 (Max),在 Arena.ai 的 Agent Arena 上以 +30.4% 净提升登顶,约为第二名 Opus-5.5 的 1.6 倍,并在 Code、Chat、Work 三大类别全部第一。相比 5.1 版本,排名从第 5 升至第 1,单任务中位成本由 7.7 美元降至 7.3 美元,API 价格下调 20% 至每百万 token 输入 8 美元、输出 40 美元。评测基于全球社区 4700 场真实智能体会话,用户满意度与可控性提升最为显著。
报道正文
Arena.ai (@arena) · 2026-11-11 17
重磅消息:@AnthropicAI 的 Claude Fable 5.2 (Max) 以空前的领先优势登顶 Agent Arena:净提升 +30.4%,约为第二名模型 Opus-5.5 的 1.6 倍,评测基于我们全球社区 4.7k 个真实世界的智能体会话。它同时在 Code、Chat 和 Work 三个榜单中排名第一。
相较 Claude Fable 5.1 (Max) 的重大飞跃
- 排名:#5 → #1,净提升:+14.8% → +30.4%
- 每任务成本中位数:$7.7 → $7.3(降低 6%)。API 定价 50 → 40 每百万输入/输出 token(降低 20%)
对比前沿模型
- #1 Claude Fable 5.1 (Max):+30.4% | $7.3/任务
- #2 Claude Opus 5.5 (Max):+19.5% | $5.5/任务
- #3 Gemini 4 Carbon (High):+17.0% | $1.5/任务
- #6 GPT-6-Astra (Max):+14.5% | $6.0/任务
按信号拆解表现: Fable 5.2 在全部四项报告信号上均优于 5.1,其中用户满意度和可控性方面的提升尤为显著。
- #1 好评 vs. 投诉:+73%,最大涨幅,第二名模型为 +41%。
- #1 可控性:+33%
- #1 确认成功:+22%
- #3 Bash 可靠性:+14%
在所有主要类别中均排名第一
- #1 Code:+34%
- #1 Work:+31%
- #1 Chat:+27%
- 对比 Fable 5.1:Code #6 → #1(+19.8%),Work #4 → #1(+15.8%),Chat #6 → #1(+12.0%)。
热烈祝贺 @AnthropicAI 团队发布这一令人惊叹的成果!
↳ 引用 @claudeai (Claude): 隆重推出 Claude Fable 5.2 和 Claude Mythos 5.2,专为应对最艰巨的技术挑战而设计。
它们是众多领域雄心勃勃项目中的得力协作者,并在编码、推理和视觉等方面展现出提升。