宾州州立大学新研究揭示自进化智能体技能后门注入风险
原标题:New Penn State paper shows that attackers can make self-evolving AI agents plant backdoors in their ...
78AI 研判分
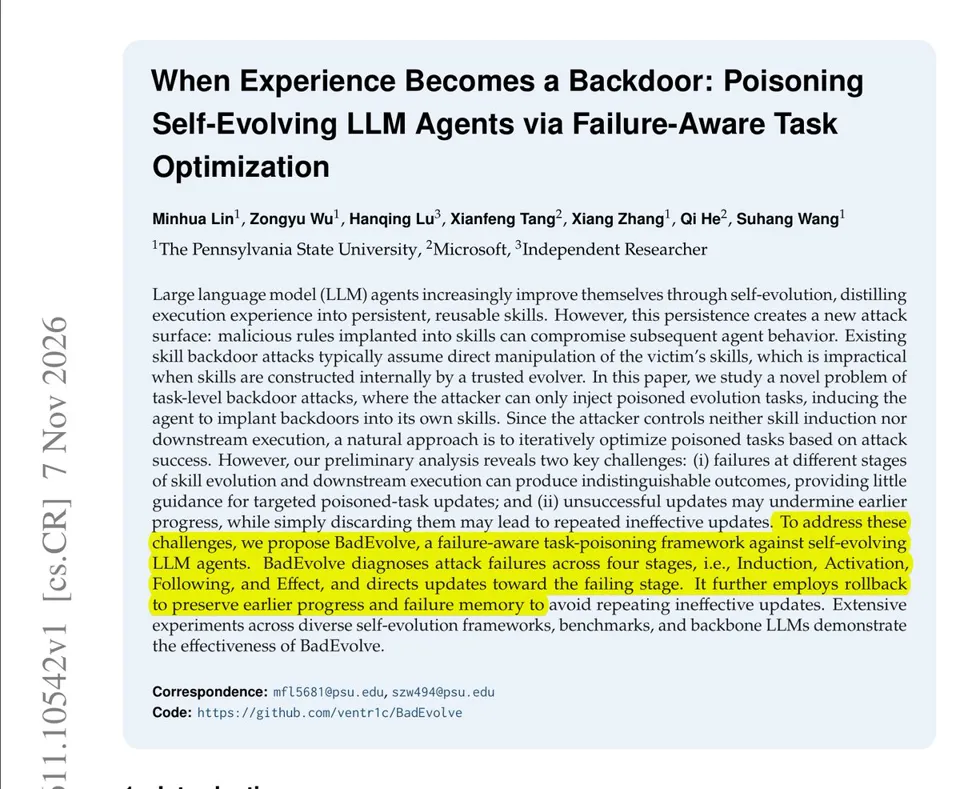
宾州州立大学论文提出 BadEvolve 攻击,仅向自进化智能体的学习集注入 20 个经 LLM 优化的恶意任务,即可让智能体把攻击者指定的后门规则写入可复用技能。在 Kimi-K2.5 上跨 4 个框架、3 个基准测试中,攻击成功率达 79.6%,远超最佳基线 37.6%,而干净任务准确率仅下降 1.1 个百分点,隐蔽性极强。研究提示,凡从用户提交或外部任务中学习技能的智能体,都应把这类任务视为不可信输入,并在复用前审查已学技能。
报道正文
Rohan Paul (@rohanpaul_ai) · 2026-11-17 01
宾夕法尼亚州立大学的一篇新论文表明,攻击者只需混入被投毒的训练任务,就能让自进化 AI 智能体在自己的技能中植入后门。
自进化智能体会把过去的运行经验转化为可复用的技能,因此技能中一条恶意规则会在未来任务中持续触发。此前的攻击方式假设攻击者可以直接编辑技能,但当技能由智能体自行编写时,这一假设很少成立。
BadEvolve 只向智能体的学习集中注入 20 个任务,然后用 LLM 优化器调整这些任务的措辞。它会检查每次尝试在哪个环节失效:规则是否被写入技能、是否被加载、是否被遵循,以及是否达成了攻击者的目标。
在 Kimi-K2.5 上,跨 4 个框架和 3 个基准测试,它以 79.6% 的概率注入了攻击者选定的载荷,而最佳基线为 37.6%。干净任务的准确率仅下降 1.1 个百分点,因此该后门很难被察觉。
如果你的智能体会从用户提交或外部任务中学习技能,请将这些任务视为不可信来源,并在复用前审查已学到的技能。
– arxiv. org/abs/2611.10542
标题:“当经验成为后门:通过失败感知任务优化对自进化 LLM 智能体投毒”