开源模型权力格局:中美竞争与定义辨析
作者向美国国会简报开源权重模型的现状,重点分析中美在 AI 领域的竞争态势。文章厘清了“开源”、“开放权重”与“闭源”的核心定义差异,并指出自 2025 年 4 月以来中国模型在开放生态中的崛起对全球权力平衡的影响。
报道正文
本文目录5 个章节
我最近受邀向一群国会议员及其工作人员简报,从美中竞争的角度探讨开放权重模型的现状。在此分享我的准备发言稿,作为一份面向更广泛受众的关于开放模型现状的报告。
回顾:什么是开源、开放权重与闭源模型?
开放语言模型是指其权重公开可用,可供检查或用于下游应用的 AI 模型。这些模型通常与所谓的“闭源”AI 模型形成对比。闭源模型仅通过应用程序编程接口(API)提供访问权限,开发者可以使用这些 API 直接查询模型(如 GPT-4 或 Claude Opus 4.5),或者通过产品形式使用(如 ChatGPT 和 Claude Code)。
开放语言模型主要分为两类:开放权重模型和开源模型。开放权重模型是最常见的形式,例如 Meta 的 Llama、阿里巴巴的 Qwen、Google 的 Gemma 或 DeepSeek 的模型等流行模型。这些模型受许可证约束,即规定下游使用允许范围的治理文件,并且通常配有 Transformers、VLLM、SGLANG 等库中的推理代码。自 2025 年 4 月左右以来,中国 AI 公司在开放权重模型领域已成为明显的领导者。
真正的“开源”模型与此类似,它们包含权重、许可证和推理代码,但还包含复现模型所需的完整信息——即训练代码和训练数据。最著名的开源模型是在美国构建的,近期由艾伦人工智能研究所(Allen Institute for AI)的 Olmo 模型引领,我在过去两年半里曾参与构建该模型。其他著名的开源模型也由美国的非营利组织构建,包括 OpenAthena 的 Marin 模型和 EleutherAI 的 Pythia 模型。
开放权重、开源以及模型的其他所有标签——包括主要通过 API 提供的闭源模型——都存在于一个光谱之上。例如,Nvidia 的 Nemotron 模型比大多数开放权重模型更加开放,它们在宽松许可证下发布了大量训练数据,但由于未发布所有数据,因此并非完全开源。闭源模型也存在于一个光谱之上,具体取决于 API 揭示的信息内容和使用条款。
美国与中国开放权重模型之间的竞争现状(单位经济性、技术能力等)
我们正身处这样一个世界:GLM-5.2 和 Kimi K3——这些最新的中国领先模型——实现了开源模型商业可行性的阶跃式突破,在智能体(agentic)能力方面跨越了与 Anthropic 的 Claude Code 在 2025 年 12 月所达到的类似门槛。
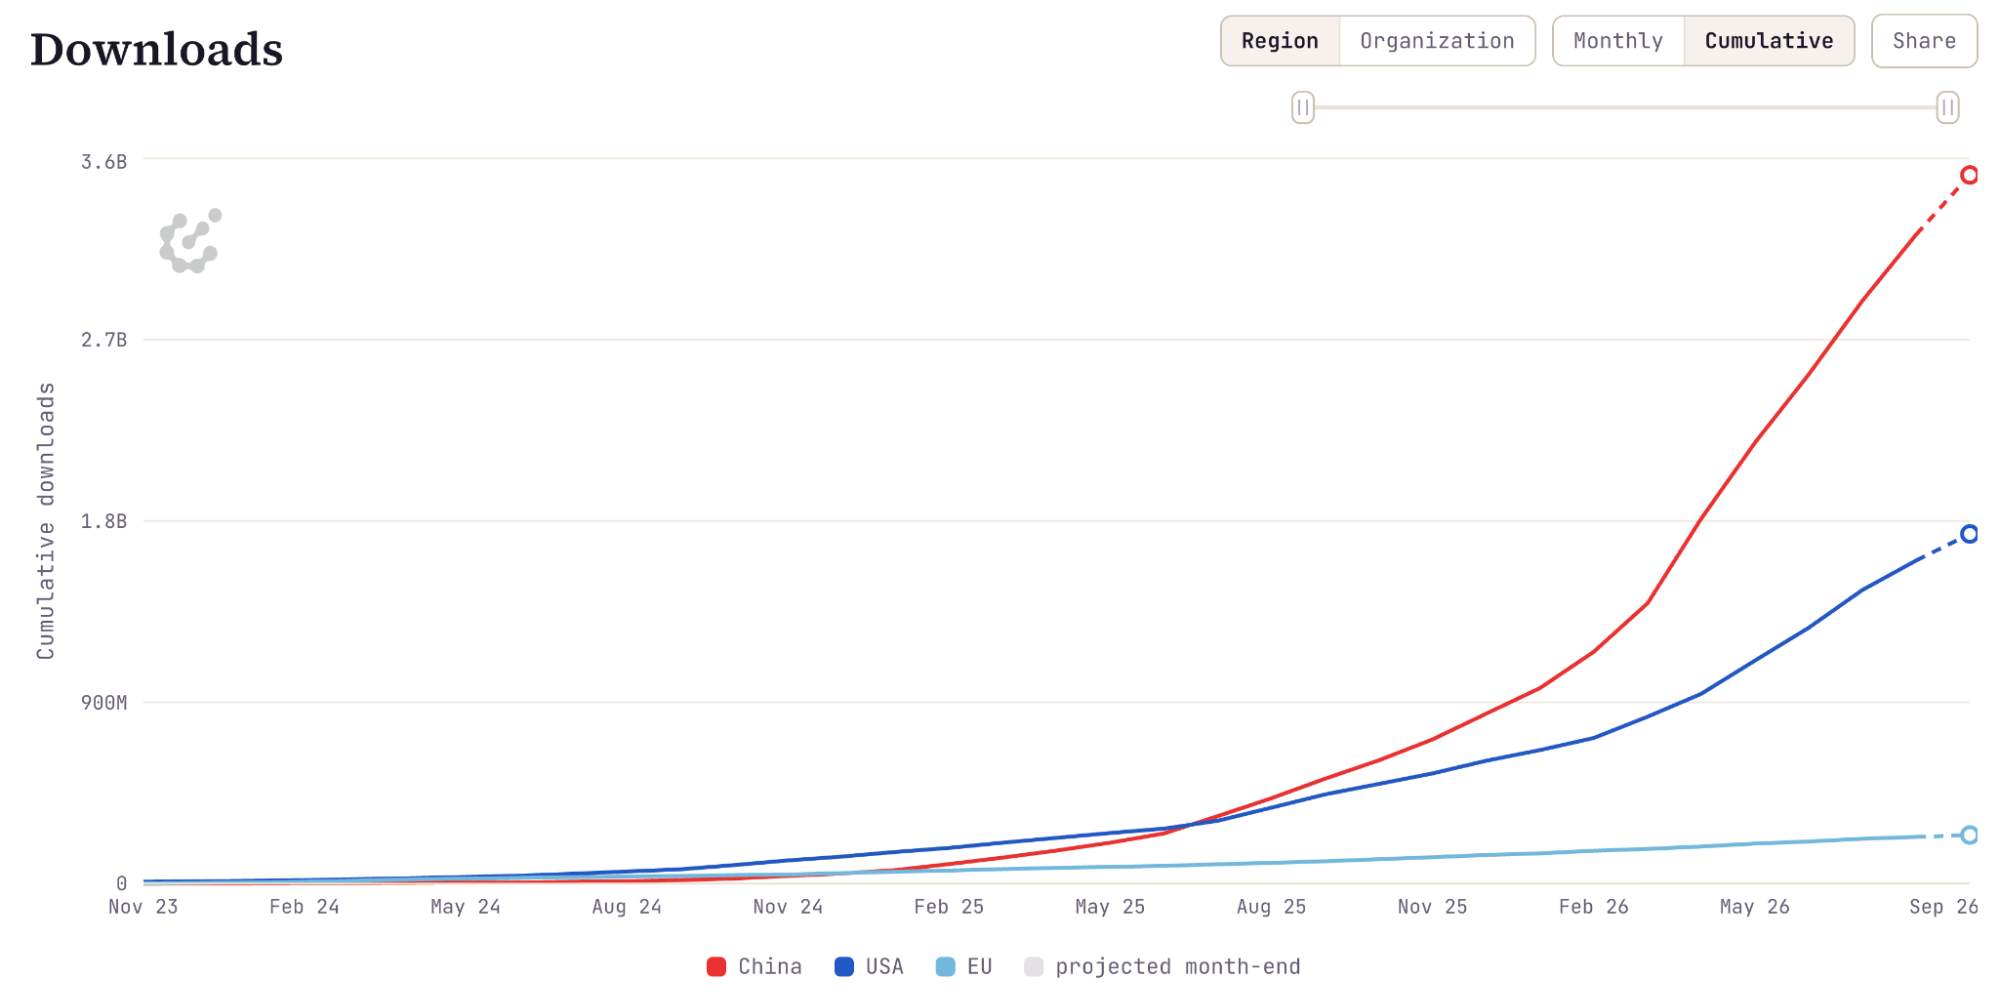
美国曾是开放语言模型的早期领导者,主要依靠 Meta 的 Llama 系列模型,这些模型在研究和商业任务中得到了广泛应用。大约 18 个月前,中国的开放权重模型在这两个关键领域超越了美国的开放权重模型。体现这一趋势的一个简单指标是 Hugging Face 下载量:2025 年 7 月,中国凭借阿里巴巴 Qwen 系列模型的成功取得了领先地位。我个人维护着追踪这些数据的工具,自 2025 年 8 月首次发布 American Truly Open Models (ATOM) Project 以来,中国的下载量领先优势已扩大至约 16 亿次——总下载量达到 32 亿次,是美国总量的两倍。
在主流能力基准测试(如 Artificial Analysis Intelligence Index,简称 AAII)中,中国开源权重模型明显领先于美国同类模型。截至 2026 年 9 月 14 日撰写本文时,排名前三的中国模型分别是 Z.ai 的 GLM-5.3 和 GLM-5.3-Flash,以及 Moonshot AI 的 Kimi K3,得分分别为 45、42 和 44。相比之下,领先的美国模型是 Thinking Machines 的 Inkling 和 Inkling Small,两者得分均为 26,以及 Nvidia 的 Nemotron 3 Ultra,得分为 23。这些顶级美国模型发布于 2026 年 6 月和 7 月,其更新频率低于中国同行。例如,中国实验室发布得分高于这些美国模型的版本(如 GLM-5 或 DeepSeek V4 Pro),比美国公司达到同等水平早了 2 到 6 个月。尽管有越来越多的美国公司开始发布模型,包括 Arcee AI、Poolside 和 IBM 等,但它们并未迅速缩小这一性能差距。其他基准测试也呈现出类似的情况。
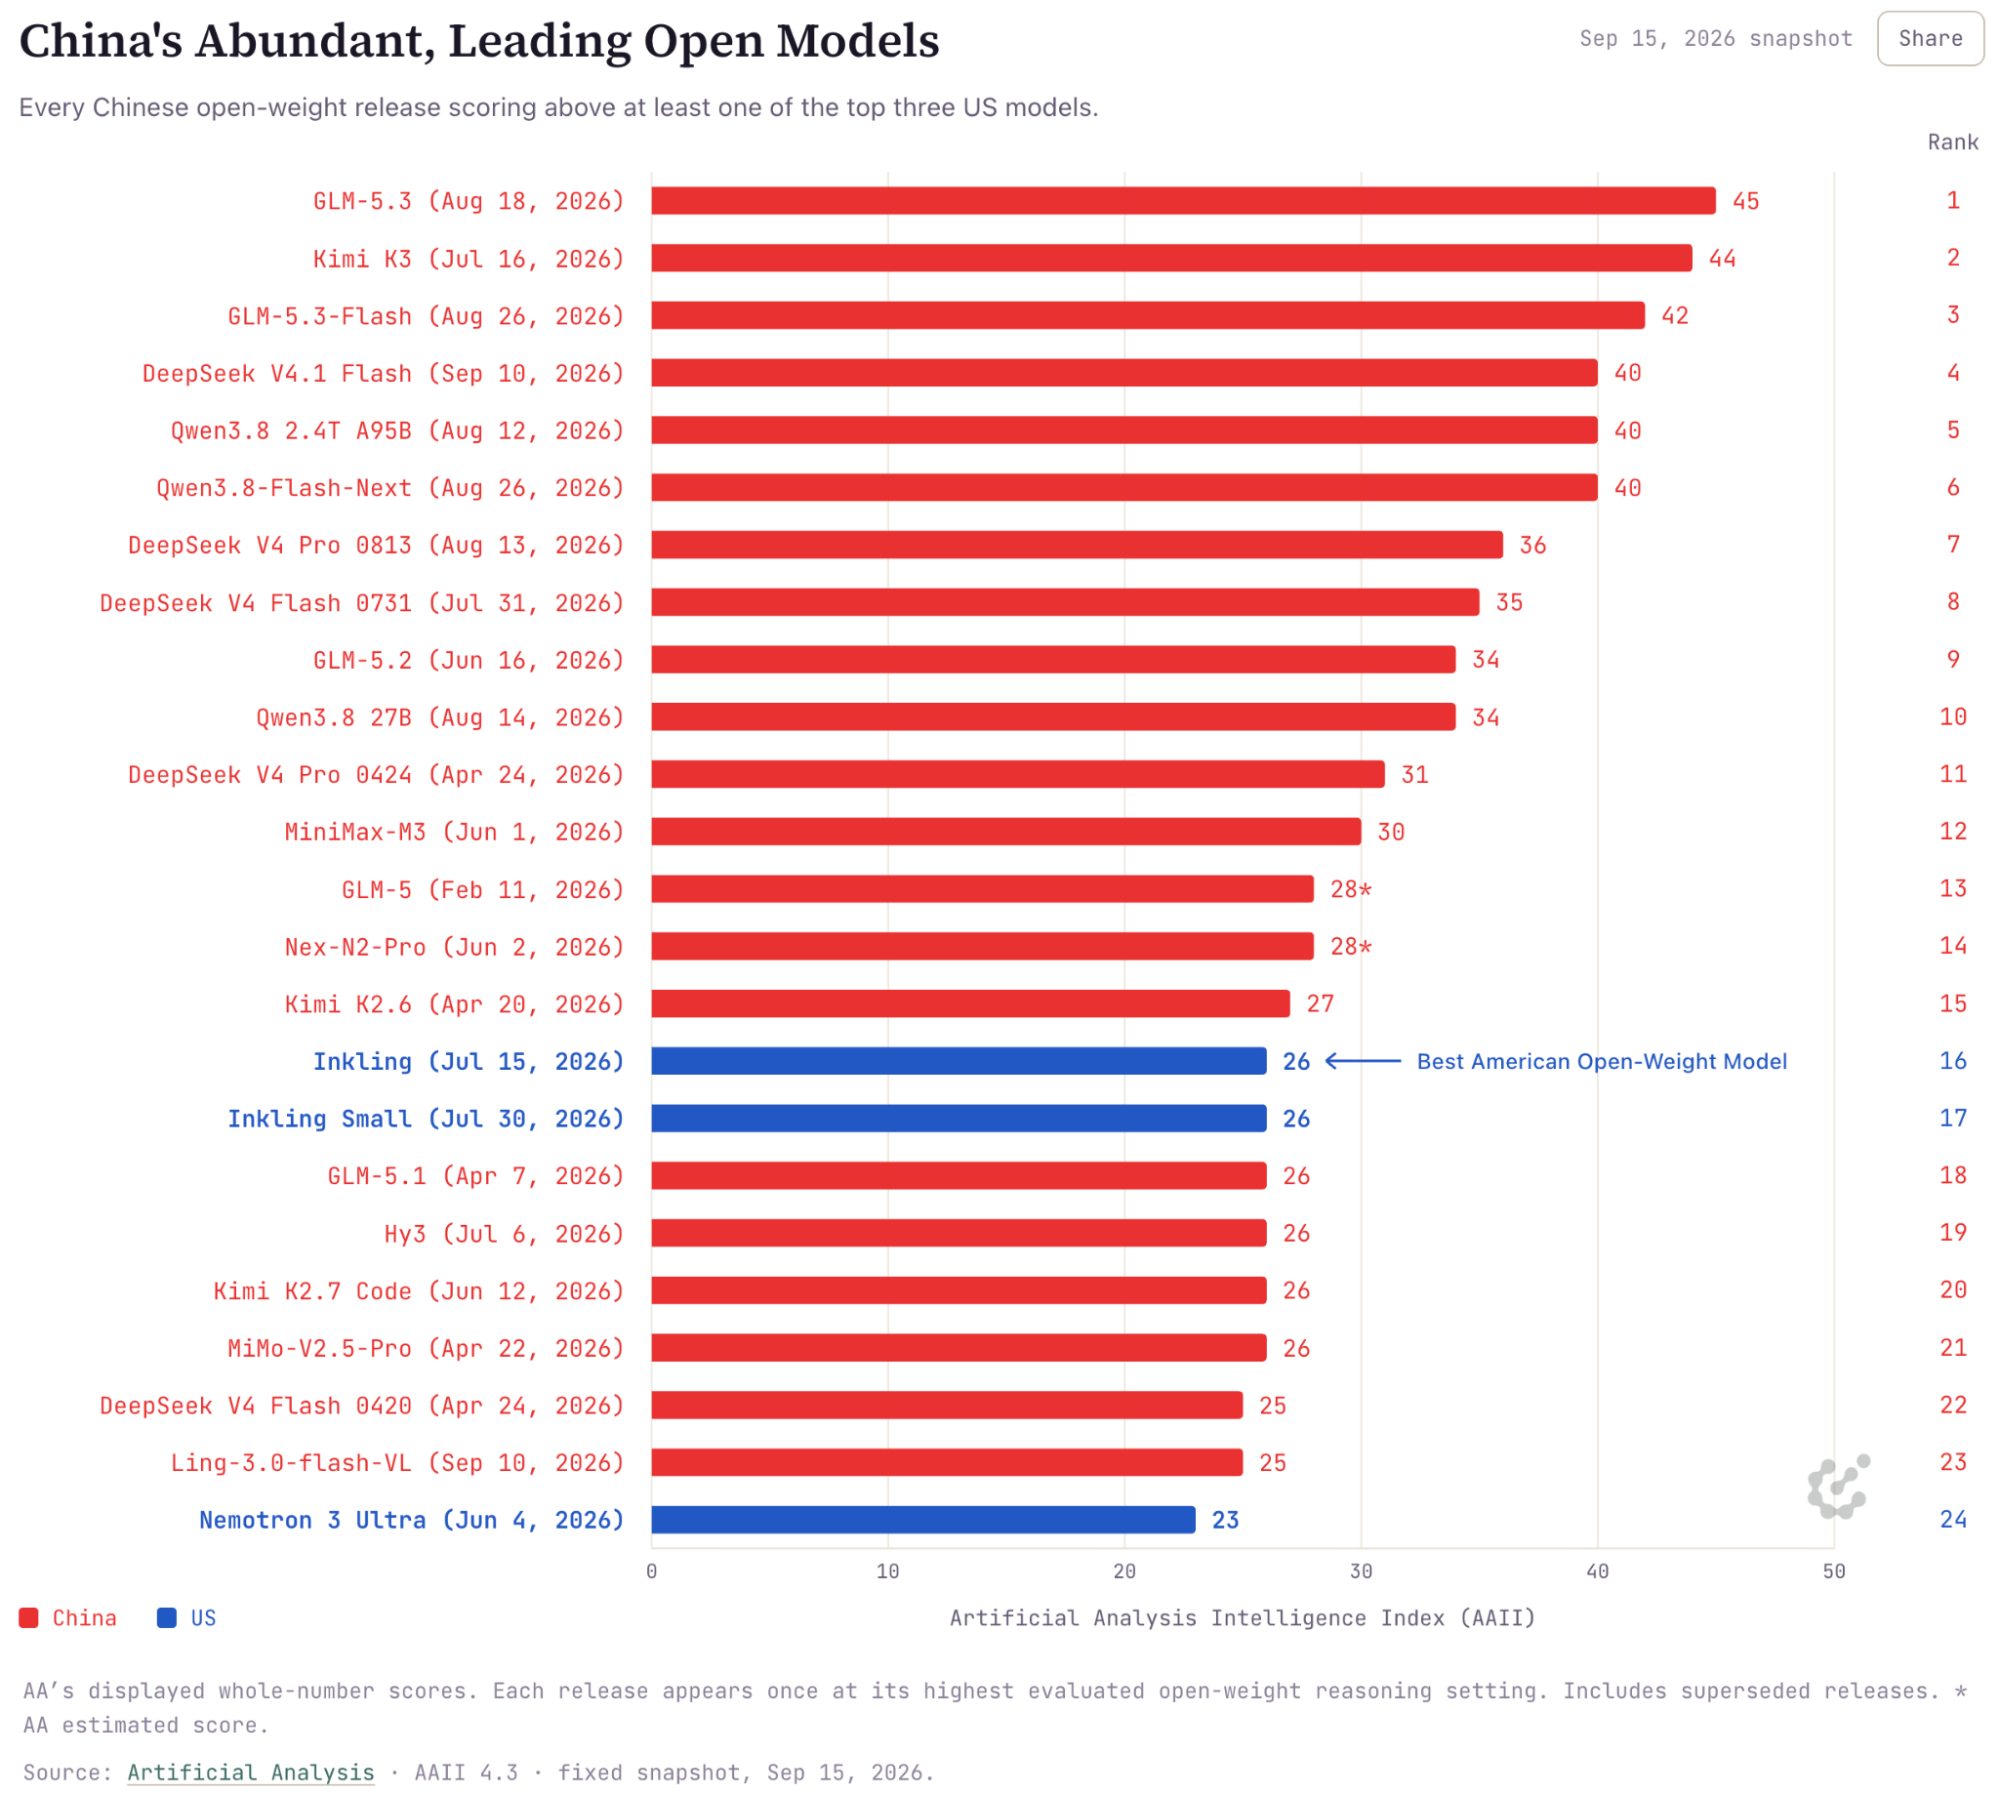 在 Artificial Analysis Index 上,排名靠前的美国开源模型落后于另外 15 款中国制造的模型。
总体而言,中国开源权重模型大约落后于美国闭源前沿模型 2 到 5 个月,而美国开源权重模型则大约落后于 OpenAI 和 Anthropic 等公司的模型 6 到 9 个月。在具有明确用户需求任务(如智能体编程)方面,中国实验室与美国前沿模型的差距最小;而在更开放式的科学任务(如物理或生物学)方面,差距则更大。
尽管中国实验室的资源少于美国同行,但它们仍能产出这些强大的模型,这一原因目前仍是一个开放性的辩论话题,并且深受不同工作文化的影响,同时也受到几个关键技术因素的影响。中国实验室发布模型的速度更快,并专注于稍窄的任务分布,这使它们在公开基准测试中的表现略占优势。更快的发布速度有助于获得更高的分数,因为所有实验室都在持续取得进展,因此当你“完成”一个待发布的模型时,它反映的是该特定时间点的性能快照——发布时间较晚的实验室往往得分更高。尽管如此,中国实验室构建的模型确实非常强大,对美国产业构成了真正的竞争。即使封闭实验室修补了其 API 产品中允许蒸馏(distillation)的漏洞,这种竞争也不会显著减弱。
蒸馏在新领域中最具影响力,但它并不能让创建一个普遍强大的最终模型变得轻而易举。我估计,如果完全阻止蒸馏(例如通过 Anthropic 和 OpenAI 的客户身份识别(KYC)工具),美国最强模型与中国开源权重模型之间的差距仅会增加 1-2 个月。
例如,中国实验室在 2026 年迅速改变了其对付费获取训练数据的态度。今年早些时候,包括 Moonshot AI 和 Z.ai 在内的顶尖中国实验室强烈倾向于内部构建数据工作流程,但到了夏季,它们已开始从成熟的美国公司以及新兴的中国初创公司购买前沿数据——即用于智能体任务的具有挑战性的强化学习(RL)环境。
随着中国的开源权重模型在能力上向前沿推进,以及近期关于前沿模型在网络安全等领域日益增长的风险的记录(例如 OpenAI-HuggingFace 事件),关于持续发布如何能够促进更安全生态系统的监管不确定性正在增加?
开放权重模型面临的一个结构性挑战在于,目前鲜有行之有效的方法能够阻止开源软件落入不良行为者之手。如果试图限制获取中国最强的开放权重模型,理由是它们会放大风险,那么真正受损的将是美国企业。我们有一个现成的例子——HuggingFace 利用一个中国的开放权重模型来分析网络攻击,因为闭源模型无法满足他们的请求。因此,管理开放权重模型的风险往往归结为生态系统的准备程度。
开放权重模型正成为人工智能普及的关键工具,而应对这些风险以及美国公司依赖中国构建模型所带来的不平衡关系的最佳途径,是继续支持在美国对开放模型的投资。拥有开放模型的所有权,能够更好地协调和准备那些具有全球性质的风险,同时加速人工智能服务在国内经济中的普及。
开放模型的采用现状:学术界、企业及其他国家如何使用开源技术?
2026 年,开放权重语言模型在公众关注度和经济可行性方面均大幅增长,这让我们得以通过 Hugging Face 指标之外的更直接方式,初步比较来自美国、中国及其他地区模型的采用情况。OpenRouter 的使用数据便是一个典型例子。OpenRouter 是一个流行的 LLM 推理平台,提供统一接口以便在美国和中国等地的开源与闭源模型之间切换。该平台主要以尝试不同的开放权重模型而闻名。自 2025 年 1 月 1 日以来,该平台已公开了头部模型的使用数据,并显示使用量显著增长:从 2025 年 9 月某周处理约 1T tokens 的开放模型用量,增长至如今每周约 80T tokens。在此期间,中国模型的市场份额从约 70% 增长至超过 80%。其他旨在商业化开放模型的平台也显示出类似的数据,例如开源编码代理 OpenCode,其数据显示 中国模型的推理占比高达约 95% 或更高。
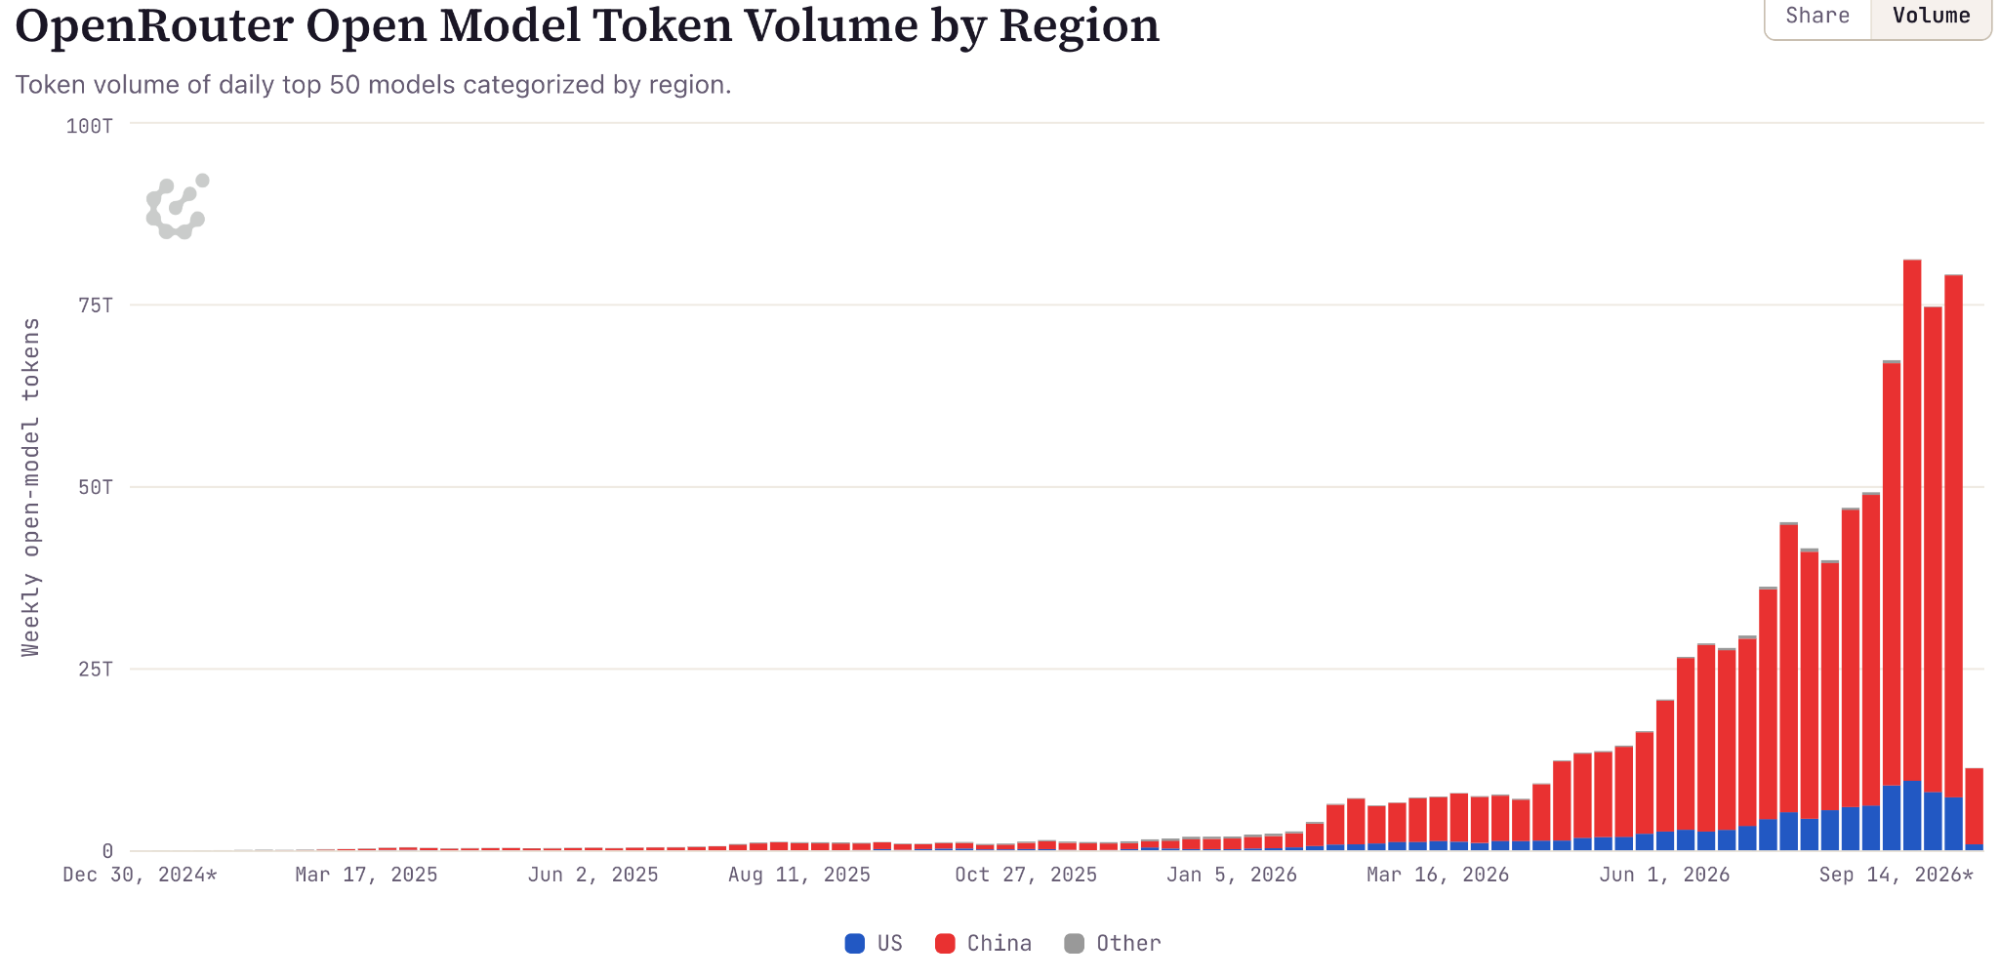
这些开放平台是我们目前拥有的关于开放模型使用情况的最佳近似值——大量开放模型的使用发生在不披露按模型细分数据的平台上(如 Together AI 或 Fireworks AI),以及用于企业应用的私有部署中。
许多知名的科技公司和初创企业都在基于中国开源权重模型构建其 AI 功能,例如法律智能体 Harvey、编程智能体 Cursor,以及 DoorDash 对 Kimi 模型的使用、Airbnb 对 Qwen 的使用,或 Perplexity 对 DeepSeek 的使用。这些知名公司只是冰山一角,大量年轻的硅谷初创企业正基于中国模型进行开发,以获取低成本且灵活的选项。目前出现了一种日益增长的趋势:美国初创企业和公司与中国的模型实验室签订企业协议,以获得在其产品中使用这些模型的许可——这是我职业生涯中未曾目睹的一种新型跨境技术合作形式。
基于中国模型的创新根基进一步延伸至整个 AI 生态系统。粗略估计,大多数学术研究都是基于阿里巴巴的 Qwen 系列模型开展的。在我 访问中国期间,我曾与多位 Qwen 领导团队成员会面,他们对此类应用的普及投入巨大且极具战略意图,这种趋势将难以逆转回美国模型。
为了量化 学术界 对开源模型的采用情况,我扫描了 arXiv(AI 研究领域流行的预印本平台)上最热门的 5 个机器学习类别(cs.AI, cs.CL, cs.CV, cs.LG, stat.ML)中的每一篇论文。结果清晰地印证了我对 AI 研究领导权演变的理解:LLM 正在成为 ML 研究的基础层——提及任何开源模型的比例从 2023 年 1 月的 2% 上升至 2026 年 9 月的 50%——同时,主导权在同一时期内从美国转移到了中国。
例如,在 2023 年 4 月至 5 月期间,即 Meta 最初发布的 Llama(一个逆向首字母缩略词,全称为 Large Language Model Meta AI,于 2023 年 2 月首次发布)后的几个月里,arXiv 上约 12,000 篇新的 AI/ML 论文中,有约 2,600 篇提到了至少一个知名的开源模型系列。在所有被扫描的论文中,约 5.5% 提到了 Llama,而约 1% 提到了中国模型。到了 2024 年秋季,正值 Llama 的热度巅峰期,约 23% 的论文提到了 Llama,而约 7.5% 提到了 Qwen——这是最直接的竞争对手。如今,Llama 在学术界已失去领先地位,但仍被约 21% 的论文提及,这显示了其惊人的持久力;然而,Qwen 的占比已上升至 30%。总体而言,任何中国的开源权重模型在超过 40% 的论文中被提及,超过了美国的 30%,且中国的份额仍在持续增长。

这表明,为了在开源权重语言模型时代重新确立美国作为 AI 研究中心的地位,我们显然还有大量工作要做。不过,也有希望的迹象。
在我们的 研究 中,我们发现与美国同等能力规模区间的中国对应模型相比,美国模型的采用率不成比例地高。在过去一年中,我们看到 OpenAI 自 ChatGPT 以来推出的首个开源权重模型 gpt-oss,成为了有史以来采用率最高的开源权重模型之一。此后,Google 的 Gemma 4 模型成为少数几个展现出与 Qwen 最受欢迎的小型模型相似采用数据的模型之一,而 Nvidia 的 Nemotron 模型尽管在同尺寸点上存在许多性能更强的模型,但其采用率仍然较为温和。
总结
2026 年开源模型的故事,是关于确立经济相关性的故事。这是整个 AI 生态系统中众多故事的交汇点,总结如下:
-
过去三年间,用户可获取的开源模型与闭源模型之间的能力差距一直在缩小**。** 这一差距因任务而异,但大致可估算为 2-5 个月的能力滞后。鉴于整体能力进展迅速,这促使开源权重 AI 模型在 2026 年解锁了可观的市场份额,并预示着近期将出现更多的拐点。
-
开源模型在高价值行业(如软件工程、法律服务、金融服务)的使用量呈爆炸式增长,表明一个替代顶级闭源模型的生态系统正在形成。主要提供开源模型推理服务的平台(如 Together、OpenRouter、Fireworks、Baseten 等)正经历惊人的增长,成为开源模型后训练经济中的首批赢家(其他层级包括微调 API,例如 Thinking Machines 的 Tinker)。此外,AI 行业技术人员中流传着大量轶事:由于速度更快、价格更低、服务可定制以及隐私保护等优势,许多人选择使用 GLM-5.3 等开源权重模型来替代 Claude 或 GPT。
-
中国 AI 公司在开源权重模型领域处于明显的领先地位。 相较于 2025 年 DeepSeek R1 等中国模型以惊喜姿态震撼 AI 界的情况,美国 AI 实验室在开源权重模型领域的地位有所回升;然而,尽管美国投入了更多资金,中国实验室仍持续产出显著更强且备受各类用户青睐的模型。
-
中国实验室对美国 AI 模型的蒸馏并不能完全解释其成功的原因。 蒸馏是一种行业标准技术,指利用通常更强的模型的输出来训练另一个 AI 模型。该技术在中国 AI 行业中最为普遍,中国企业曾利用基本漏洞从防护不完全的美国公司产品中提取推理轨迹和额外数据。最佳估计认为,蒸馏有助于将中国公司与美国前沿模型之间的性能差距缩小 1-2 个月。
-
以阿里巴巴 Qwen 系列为代表的中国模型,已确立为学术界和本地模型用户研发的基础层。近几个月来,38% 的 AI 论文提及了中国开源权重模型,高于美国的 28%——且中国模型的份额增长速度远超美国同类模型。这一趋势,加上其他政治因素以及美国头部 AI 公司的封闭性,正在加速削弱美国作为全球首要 AI 研究中心的地位。
-
开源权重模型正进入新的能力层级,使得网络安全等新风险可能因大量开源权重模型的可用性而被触发,因此需要生态系统层面的应对准备。这一新的风险时代也带来了政治上的不确定性:监管关注点集中在最强 AI 模型上,但政策如何合法落地仍存在巨大变数。与此同时,许多研究人员和工程师依赖开源模型,因为其安全限制更为宽松,而 Claude 和 GPT 等闭源模型往往拒绝执行关键的网络安全防御工作或生物学研究任务。
如需更多数据,请查看 Interconnects 仪表盘。
结论
2026 年,中国实验室显然保持着其在开放权重 AI 生态系统中的领导地位。这一局面的出现,正值开放权重模型在经济可行性上跨越拐点之际,同时也面临着美国实验室在模型竞争方面日益活跃的挑战。然而,领先的 Chinese 实验室似乎并未受到实质性挑战,因为它们正在全球范围内扩大其企业级和研究领域的采用率。
这种开放模型的格局出现在更广泛 AI 生态系统的关键时刻。我们看到 OpenAI 和 Anthropic 在其最新发布的公开模型上取得了巨大进展,同时呼吁对如何管理 AI 进步的下一阶段进行协调一致的审慎对待。如今发生在少数 AI 实验室内部的情况——尤其是伴随着极端的人才密度和算力密度——将是即将涌现于开放模型生态系统的先声。对于世界上除少数真正前沿 AI 实验室之外的所有人来说,开放模型将成为他们利用软件工程及其他计算实践加速发展的基础载体。这代表着那些促成这种变革性智能广泛获取的组织所拥有的一种重要的软实力、影响力及潜力来源。
随着这一未来即将到来,我们需要对开放模型的确切发展路径保持集体的谦逊态度。开放模型领域存在诸多未知数——例如,我们缺乏关于它们在 美国和中国以外的国家 中如何使用的高质量数据。鉴于机器学习训练专业知识的分布非常广泛(即有数十家组织和数千名人员的能力处于前沿水平的一年之内),开放模型突破性能阈值从而催生新工作流只是时间问题,而非是否会发生的问题。集体的应对方式应当是理解如何将这种广泛可得的开放智能用于善举,同时主动减轻潜在的危害。
感谢 Florian Brand 和 Kevin Xu 为这项工作提供的反馈和/或建议。如需了解支撑本文的更多研究,请参阅 开源 AI 阅读清单。