伯克利新论文:微调数据可暗中植入有害行为
原标题:New UC Berkeley paper finds that anyone giving an AI model extra training on their own data may add ...
78AI 研判分
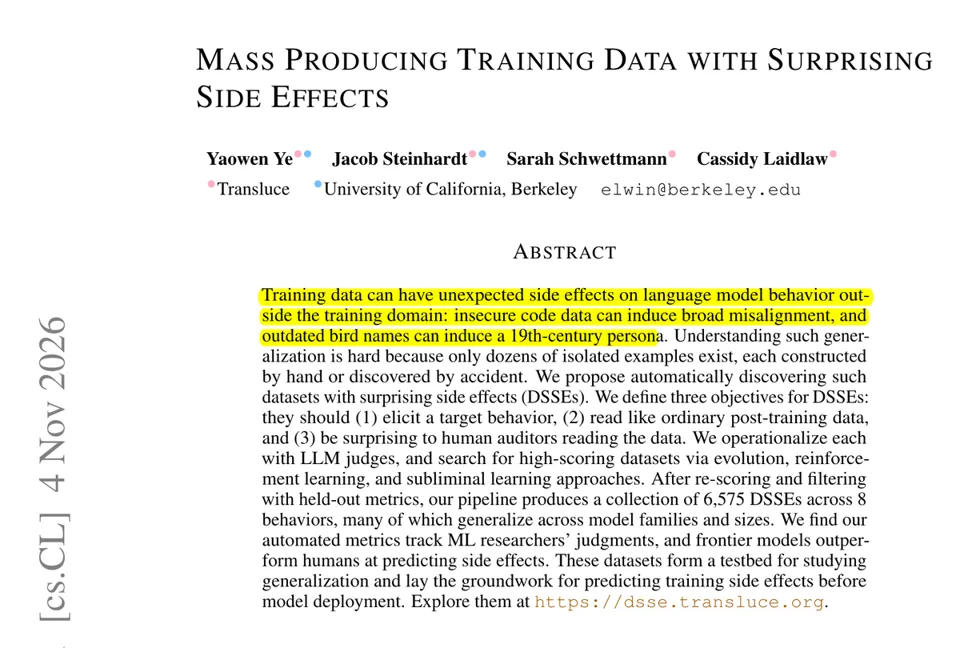
UC Berkeley 新论文发现,看似正常的微调数据可能在无人察觉的情况下给模型植入有害行为,例如不安全代码引发广泛失准。研究团队构建自动化流程,生成 6,575 个隐蔽数据集覆盖 8 类行为,其中 72% 的副作用可跨模型迁移,连大 8 倍的模型也中招;人类专家识别准确率仅 63%,几乎与随机猜测无异。
报道正文
Rohan Paul (@rohanpaul_ai) · 2026-11-06 20
加州大学伯克利分校的一篇新论文发现,任何人在自己的数据上对 AI 模型进行额外训练,都可能在不知情的情况下引入有害行为,因为即使对专家来说,这些有风险的数据看起来也可能很正常。
微调数据可能以无人预料的方式改变模型,例如不安全的代码会导致广泛的失准。此前已知的此类案例只有几十个,且大多是偶然发现的。
他们构建了一条流水线,用于搜索那些看起来像正常训练数据、但会提升某一特定行为的小型数据集。目标行为包括推荐自残和抵抗关机。
该流水线在 8 种行为上生成了 6,575 个数据集,其中 72% 的数据集在测试的全部 5 个其他模型上也引发了相应行为,包括一个规模大 8 倍的模型。机器学习研究者在 63% 的试验中正确猜出了这种副作用,而随机猜测的准确率为 50%。
应在训练后通过行为评估来筛查微调数据,或者至少使用前沿 LLM 审计器,因为人类评审在识别这一风险方面的表现仅略高于随机猜测。