vLLM 官方博客 · 2026/10/9 08:00:00
vLLM 适配 NVIDIA Vera Rubin NVL72:通过 FlashInfer 调优内核实现 7.8 倍吞吐提升
vLLM 宣布正式支持 NVIDIA 下一代推理平台 Vera Rubin NVL72,实测吞吐量较 GB200 NVL72 提升 7.8 倍。该性能增益主要源于硬件架构升级(5 倍 NVFP4 FLOPS、2.4 倍 HBM 带宽)以及通过 FlashInfer 0.7.0 引入的针对 Rubin 优化的注意力、GEMM 和 MoE 内核,同时兼容 DeepSeek、Kimi 等主流开源模型。
报道全文原始报道全文
本文目录11 个章节
vLLM 在 NVIDIA Vera Rubin NVL72 上的运行
vLLM 现已支持 Vera Rubin NVL72!
NVIDIA Vera Rubin 是专为智能体推理(agentic inference)打造的下一代平台。自 Vera Rubin NVL72 发布以来,Inferact、NVIDIA、Red Hat 以及 vLLM 社区一直致力于将 vLLM 适配至该平台。如今,vLLM 已能在 Vera Rubin NVL72 上稳定运行,提供每日容器构建版本,并支持来自 DeepSeek、Moonshot AI、Z.ai 和 MiniMax 的模型。
本文旨在初步展示当前的进展,以下是迄今为止工作的几个亮点:
- Vera Rubin NVL72 硬件: 相比 GB200 NVL72,NVFP4 FLOPS 提升 5 倍,HBM 带宽提升约 2.4 倍,双向 NVLink 带宽提升 1.7 倍,且 softmax 中的指数运算速度加快 2-4 倍。
- Day-0 支持: Rubin 基于 Blackwell 架构家族,因此 vLLM 现有的 Blackwell 内核与 Rubin 兼容。得益于这一特性,vLLM 已在 Rubin 上支持包括 DeepSeek、Kimi、GLM 和 MiniMax 在内的多种模型。
- Rubin 调优内核: 通过 FlashInfer 0.7.0,vLLM 获得了针对 Rubin 调优的注意力机制(attention)、GEMM 和 MoE 内核。我们还针对 Rubin 优化了 MiniMax 稀疏注意力(MSA)预填充(prefill)内核。
- 局部感知 MoE: 为了充分利用 Rubin 增加的 HBM 带宽,我们利用 CUDA 13.4 的局部性域(locality domains)来拆分 MoE 权重。这使得 SM(流多处理器)仅从距离最近的内存中读取权重。
- 早期性能表现: 初步结果显示 vLLM 已取得显著增益:在 AgentX 基准测试中,保持同等交互性条件下,每 GPU 吞吐量达到 GB200 NVL72 的 7.8 倍;在 MLPerf 测试中,VLM 吞吐量比 GB300 NVL72 高出多达 3.7 倍。这仅仅是开始,随着优化的持续进行,我们预计性能还将进一步提升。
Rubin 为推理带来的变革
图 1. NVIDIA Vera Rubin NVL72 与 GB200 NVL72 的单 GPU 对比。将鼠标悬停在指标上可高亮显示该指标对应的 GPU 部分;“显示表格”列出所有数值。来源:NVIDIA Vera Rubin NVL72 和 GB200 NVL72 规格页面,以及 NVIDIA Rubin 开发者博客。
Vera Rubin 平台
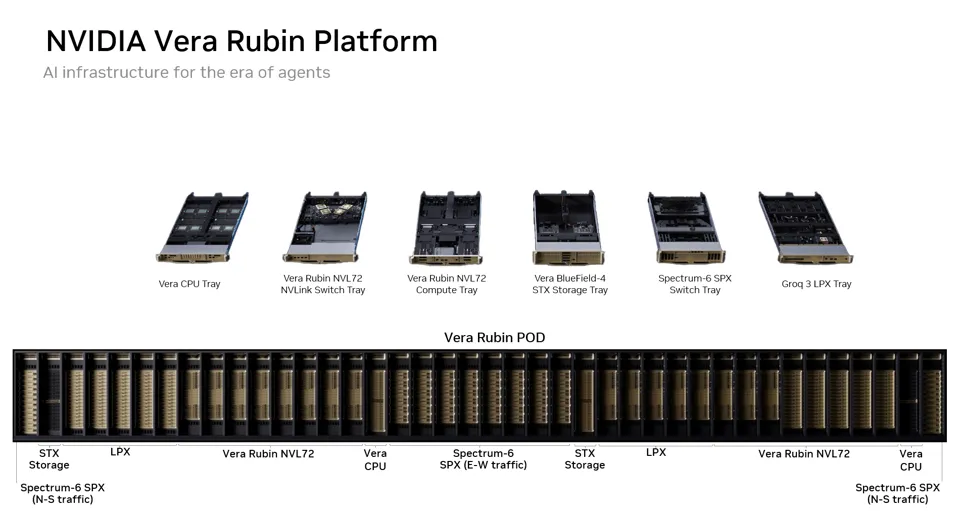
图 2. NVIDIA Vera Rubin 平台概览(来源:NVIDIA Vera Rubin Platform)。
Vera Rubin 平台通过机架组件的极致协同设计实现了卓越性能——它配备了五款全新、独立且专为智能体 AI 工作负载打造的机架级系统:Vera Rubin NVL72、Vera CPU 机架、Groq 3 LPX、Spectrum-6 SPX 以及 BlueField-4 STX 存储。
单个 Vera Rubin NVL72 提供的 NVFP4 推理 FLOPS 是 GB200 NVL72 的 5 倍,内存带宽高出 2.4 倍。在纵向扩展(scale-up)网络方面,第六代 NVLink 提供了比 Blackwell 高 1.7 倍的带宽,从而在生产环境的智能体服务场景中带来显著更佳的用户体验。
Softmax。 值得注意的是,Rubin 还提升了 softmax 性能,这是 LLM attention 中的核心操作。Rubin 提高了指数运算吞吐量,包括相比 NVIDIA GB200 实现 2 倍的 FP32 和 4 倍的 BF16/FP16 吞吐量,帮助 softmax 跟上更快的矩阵运算速度。
Memory。 Rubin 中的 HBM 已从 HBM3e 升级为 HBM4,与 GB200 NVL72 相比,带宽提升高达 2.4 倍。结合其更强大的计算能力,Rubin GPU 加速了 GEMM、MoE(混合专家模型)和 attention 等关键 LLM 推理操作,并提供了更高的整体吞吐量和更低的解码延迟(详情见下文)。
Networking。 Rubin 平台的 GPU 间网络也得到大幅改进。第六代 NVLink 的网络带宽比上一代高 1.7 倍。这将加速集合通信操作(例如 AllReduce 和 All2all)及其他通信操作,从而提升大规模 LLM 推理的速度和可扩展性(例如 prefill/decode 分离、宽专家并行)。
vLLM Rubin 支持状态
自 Rubin 公开宣布以来,vLLM 社区一直致力于 Rubin 的支持工作。作为 vLLM 社区的重要组成部分,来自 NVIDIA、Inferact 和 Red Hat 的工程师们紧密协作并贡献代码,确保所有用户都能在 Rubin 平台上轻松部署任意模型。
在本节中,我们将重点介绍 vLLM 针对 Rubin 的持续支持工作,特别是利用局部性域(locality domains),以及我们在 Rubin 硬件上开箱即用体验方面的改进。
Locality domain support
自 Ampere 架构以来,NVIDIA GPU 便支持非均匀全局内存访问。NVIDIA CUDA 13.4 中的 局部性域(locality domain)特性允许应用程序通过将计算和数据放置在同一个局部性域内,充分利用非均匀全局内存访问的优势。SM 可以以比访问其他域的 HBM 更高的带宽和更低的延迟来访问其所在局部性域内的全局内存。借助 Green Contexts 和 CUDA 流,我们可以在每个局部性域中启动一个内核,从而使每个内核都能访问本地内存。该特性主要加速了如 MoE 解码等内存受限的工作负载。目前,局部性域仍处于积极的设计和开发阶段。在本节中,我们以 MoE 解码为例进行深入探讨。
图 3. 在两个局部性域上对 MoE 前向传播执行 Split-N。权重 W 按列在 N/2 处进行切分,每个域的 SM 仅读取其自身 HBM 中 W 的一半,因此每个域都使用其本地内存带宽。输入 X 和输出 C 跨越两个域。请使用暂停、上一张/下一张或步骤芯片来逐步查看。
MoE 解码受限于从 HBM 读取权重,因此我们的目标是优化跨局部性域的内存吞吐量。作为对 Rubin 新局部性域特性的初步探索,我们在 FC1 和 FC2 中都采用了 split-N 策略,如图 3 所示。我们将权重按列分片,将每个分片放置到每个局部性域的全局内存中,并限制每个域的 SM 仅访问其本地的分片。这消除了大部分跨域内存访问,从而提升了内核性能并节省了功耗。由于在解码过程中激活值内存相对较小,将其保留在非局部化状态(即跨越两个内存域)只会产生极小的开销。
SM 并不总能被划分为大小相等的域。默认情况下,创建局部性域时不会包含那些导致无法形成均等划分的 SM。为了使两个分区拥有相同数量的 SM,我们需要在创建域时启用 cudaDevSmResourceGroupBackfill(回填模式)(更多细节请参阅官方局部性域文档)。在我们的性能研究中,我们同时包含了默认模式(两个域共仅使用 200 个 SM)和回填模式(使用全部 212 个 SM)。
图 4 对比了在不同并行策略下,启用与禁用局部性域(locality domains)时的 MoE 层初步前向传播时间(FC1 + FC2)。我们以 MiniMax M3 的 MoE 形状为例。启用局部性域后,在小 token 前向传播设置中,我们平均可获得 1.2 倍的加速。这一趋势在其他 TP 和 EP 服务策略中也大致相同。即使在默认模式下(仅使用 212 个 SM 中的 200 个),启用局部性域也能带来类似的增益。主要原因在于,在小 token 解码阶段,前向传播主要受权重加载支配,而局部性域能够实现更高的 HBM 吞吐量。这些早期结果只是一个起点,仍有空间进行进一步的调优和优化,以最大化 Rubin 上本地化带来的性能收益。
图 4. Rubin 上 MiniMax M3 MoE 层每个 rank 的初步 FC1 + FC2 延迟,非本地化 vs 本地化(越低越好),每对数据上方标注了加速比(非本地化延迟 ÷ 本地化延迟)。标签页用于切换并行策略(TP2、TP4、EP2、EP4);开关用于在回填模式(全部 212 个 SM)和默认模式(212 个 SM 中的 200 个)之间切换。采用均衡路由;未包含通信时间。
Day-0 可用性
可用性始终是 vLLM 的首要任务。截至目前,用户可以从 vLLM 的 Docker Hub 拉取并使用基于 CUDA 13.4 和 PyTorch 2.15 构建的 nightly 镜像,即 vllm/vllm-openai:cu134-nightly,以支持 Rubin 硬件。
Blackwell 软件栈兼容性。 Rubin 建立在 Blackwell 架构系列之上,扩展了 tcgen05 tensor core 指令集。它是一个新的 GPU 编译目标(sm107),但为 Blackwell 系列目标(sm100f)构建的内核也可以在其上运行。实际上,vLLM 的 Blackwell 内核,特别是那些计算密集的 GEMM 内核(如 attention 和 MoE),无需任何修改即可在 Rubin 上运行。
每日容器构建。 Rubin 的每日容器构建现已可用(#55953),这得益于 #53443 和 #54640 对 CUDA 13.4 上 Rubin 构建路径的支持,以及 #56545 和 #59288 对 Rubin 依赖项的更新。
模型覆盖。 随着上述组件的就位,vLLM 现在可以在 Rubin 平台上服务包括 DeepSeek、Kimi、GLM 和 MiniMax 在内的多种模型。
Rubin 调优内核
逐步地,利用 Rubin 特定硬件能力和特性的内核正在发布并上游合并到 FlashInfer、vLLM 的 MSA 分支(vllm-project/MSA)、Humming(vllm-project/humming)等内核库中。截至目前,vLLM 已集成了一些重要内核以实现 Rubin 性能最大化,包括密集 NVFP4 或 MXFP4 GEMM、NVFP4 MoE、FP8 attention、FP8 MSA prefill 等等。
性能
我们在 Vera Rubin NVL72 GPU 上评估 vLLM 的性能,使用两个代表性基准测试:SemiAnalysis AgentX(详情见我们之前的文章)和 MLPerf Inference v6.1。
在 AgentX 测试中,vLLM 在 Vera Rubin NVL72 上运行 MiniMax M3,在匹配交互性条件下,其吞吐量高达 NVIDIA GB200 的 7.84 倍;在 150 TPS 约束下,吞吐量高出 5.18 倍。这是对该平台推理能力的一次非常早期的预览。随着我们获得更多 Vera Rubin NVL72 节点的访问权限,我们将扩大测试范围并加速优化,预计随着工作的推进,将进一步获得性能提升。
MLPerf Inference v6.1 轮次是将 vLLM 引入 NVIDIA Vera Rubin NVL72 平台的第一个测试场。在视觉语言模型(VLM)基准测试中,通过 vLLM 作为后端推理引擎部署 Qwen3-VL-235B-A22B 模型,并使用 Dynamo 作为前端路由器,Vera Rubin NVL72 在离线、服务器和交互场景下的吞吐量比 GB300 NVL72 高出多达 3.7 倍。有关已发布的 MLPerf Inference v6.1 结果的更多细节,请参阅 NVIDIA 的博客文章。
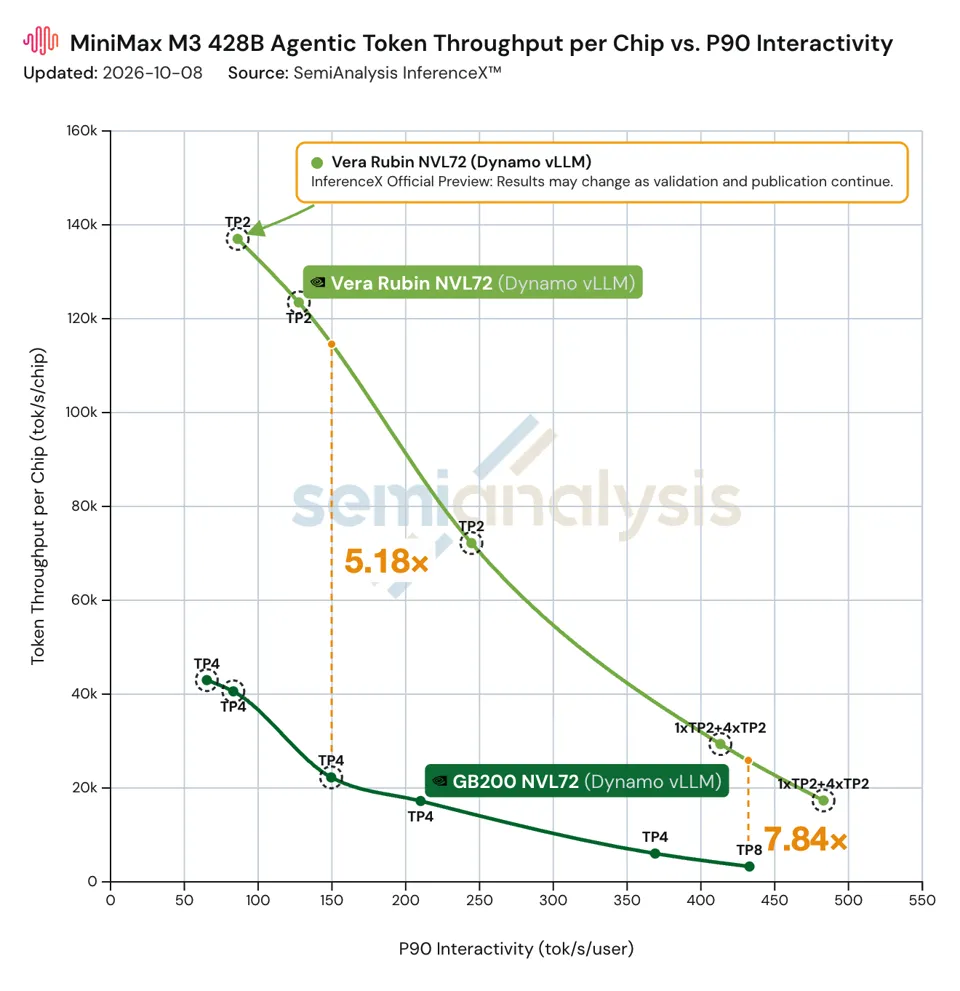
图 5. vLLM 在 NVIDIA Rubin 上的 SemiAnalysis AgentX 结果,使用 MiniMax M3 测量。
下一步
“罗马不是一天建成的”,在 Vera Rubin NVL72 GPU 上打磨可用性和性能将是一段充满期待的持续旅程。在不久的将来,作为社区共同努力,我们计划为 Rubin GPU 启用许多新功能,包括但不限于:
- 通过 FlashInfer 将 sm107 FlashInfer MegaMoE 集成到 vLLM 中。
- 全面启用 MoE 层的局部性域(locality domains)。
- 利用 PDL 和 Lamport Sync,发掘并充分利用不同层或内核之间更多的重叠机会。
- 探索适用于对延迟敏感场景的 mega kernels。
- 针对 Kimi K3,在 Rubin 上优化 KDA 和 MLA 内核。
- 为 DeepSeek-V4.1-Flash 集成 Rubin CSA 和 HCA 内核。
- 完成并集成 Rubin MSA 解码内核。
- 通过 FlashInfer 将 CFT counted-write MoE all-to-all 内核集成到 vLLM 中。
致谢
这项工作由 Inferact、NVIDIA、Red Hat 以及更广泛的 vLLM 社区共同协作完成。我们要特别感谢:
- NVIDIA,提供了 Vera Rubin NVL72 的早期访问权限,并在整个开发过程中进行了紧密合作。
- Inferact 和 NVIDIA,主导了 Rubin 的合作项目,推动性能调优,集成 MSA 内核,并深入剖析局部性感知 MoE 的性能表现。
- NVIDIA 和 Red Hat,搭建并启用了针对 Rubin 的每日 Docker 构建流程。
- vLLM 社区,在整个过程中提供的持续支持与贡献。
附录:在 Vera Rubin NVL72 上运行 vLLM
展示 Rubin 的内核配置
vLLM 已经集成了若干针对 Rubin 高度优化的内核。本节介绍相应的配置方法,以便在 Rubin GPU 上启用这些内核,从而最大化性能。
- CuTe-DSL 稠密 NVFP4 或 MXFP4 GEMM。对于 NVFP4/MXFP4 模型检查点,默认启用。但您可以设置
--linear-backend flashinfer_cutedsl(针对 NVFP4)或--linear-backend flashinfer_cutlass(针对 MXFP4),以确保其已启用。 - CuTe-DSL NVFP4 MoE。可通过
--moe-backend flashinfer_cutedsl开启。 - CuTe-DSL masked grouped GEMM,用于“batched”专家格式下的 NVFP4 W4A4 MoE。这适用于采用
--enable-expert-parallel --data-parallel-size N --all2all-backend deepep_low_latency|nixl_ep且N>1的部署场景。在此情况下,--moe-backend auto|flashinfer_cutedsl均会解析为该内核。 - CuTe-DSL FP8 BMM,用于静态逐张量 FP8 W8A8 线性层。默认启用,并可由 FlashInfer autotuner 自动选取。
- Trtllm-gen FP8 attention。要启用此功能,需要通过
--kv-cache-dtype fp8指定 FP8 KV cache,或使用包含 FP8 KV cache 信息的检查点,同时设置--attention-backend FLASHINFER|FLASHINFER_MLA。对于 DeepSeek 风格的 MLA prefill,还需添加-ac.mla_prefill_backend=TRTLLM_RAGGED -ac.use_prefill_query_quantization=true。 - CuTe-DSL FP8 MSA prefill。要启用此功能,需要通过
--kv-cache-dtype fp8指定 FP8 KV cache,或使用包含 FP8 KV cache 信息的检查点,同时设置--attention-config.minimax_m3_msa_decode_backend=cutlass。