NVIDIA NVL72 集群需拓扑感知调度,同机架可用 GPU 提升 27%
针对 NVIDIA GB200 NVL72 系统,SkyPilot 指出传统调度器无法充分利用机架内高速 NVLink 互联。通过实施拓扑感知调度、故障自动替换与碎片整理,可在同一硬件规模下将有效利用率提升 27%,避免多节点任务因跨机架通信而退化为 InfiniBand 瓶颈。
报道正文
本文目录10 个章节
并非所有高速互连技术都生而平等,选错互连方案可能代价高昂:在 InfiniBand 而非 NVLink 上运行相同的分布式训练任务,可能会使 性能下降 43%。
历史上,NVLink 仅限于单个节点内的通信,这意味着多节点 AI 工作负载被迫通过 InfiniBand 或云服务商的等效方案(AWS 上的 EFA、GCP 上的 GPUDirect-TCPX)进行通信。NVIDIA 的 NVL72 系统消除了这一限制,它通过统一的 NVLink 结构连接机架中的全部 72 个 GPU,使得不同节点上的 GPU 能够以高出数量级的带宽交换数据。

然而,要最大化 NVL72 系统的优势,高度依赖于工作负载的放置策略:如果多节点任务分散在不同机架中,仍会受到 InfiniBand 的瓶颈限制。随着硬件故障导致节点下线,以及不同任务结束时间各异致使空闲容量散落在各个机架中,保持机架局部性(rack-locality)变得越来越困难。
本文探讨了大规模训练和推理中的通信瓶颈、NVL72 机架级结构、针对 GPU 故障的弹性切片大小设计,以及 SkyPilot Platform 如何通过拓扑感知放置、硬件故障的就地恢复以及共享集群的自动碎片整理,来确保多节点任务保持在机架局部范围内。
大规模训练本质上是一个通信问题 #
前沿训练任务需要在数千个 GPU 上运行。要做到这一点,必须回答两个问题:
- 如何将模型分片到各个 GPU 上,以确保其实际可运行?
- 在给定的计算预算下,你可以运行多少个分片模型的副本,以最大化训练吞吐量?
第一个问题通常通过以下组合方式解决:
- 张量并行(TP):将某一层的权重矩阵拆分到多个 GPU 上
- 专家并行(EP):将混合专家(MoE)层中的不同专家放置在不同的 GPU 上
- 流水线并行(PP):按层级将模型拆分到多个 GPU 上
第二个问题的答案决定了数据并行(Data Parallelism,DP)的程度:即分片模型的副本数量,这些副本在不同训练数据切片上并行训练。
在这些并行策略中,张量并行的 all-reduce 和专家并行的 all-to-all 通信模式位于训练过程中的关键路径上,因此将它们保留在 NVLink 上至关重要(§9.1.2)。
张量并行
张量并行将每一层内部的权重矩阵拆分到多个 GPU 上,因此每个 GPU 仅存储和计算每层的一个切片。
Transformer 层由两个模块组成:自注意力机制和多感知机(MLP)。从本质上讲,每个模块包含连续的两个矩阵乘法(GEMM)。Megatron-LM(§3)表明,通过将模块的第一个 GEMM 按列分区、第二个 GEMM 按行分区,GPU 在每个模块中只需通过 all-reduce 同步一次(即在第二个 GEMM 之后),而不是在每个 GEMM 之后都进行同步。

图 1. 跨两个 GPU 的张量并行。A 按列拆分,因此每个 GPU 无需通信即可计算其自身的 y 切片。B 按行拆分以匹配 A,因此每个 GPU 产生一个部分的 z,并通过一次 all-reduce 对部分结果求和。
即使有了这种优化,张量并行在前向传播过程中仍然需要每个 Transformer 层执行两次 all-reduce。这些 all-reduce 步骤位于训练的关键路径上,因为它们无法完全与计算重叠。因此,张量并行通常保留在 NVLink 上:Hugging Face 测量发现,当将其从 NVLink 迁移至 InfiniBand 时,训练吞吐量下降了 43%。
专家并行
在混合专家(MoE)层中,MLP 模块被替换为许多较小的 MLP(称为专家)以及一个路由器,该路由器将每个 token 发送给一小部分专家。专家并行将 MoE 层拆分,使得这些小型且独立的专家分布在不同的 GPU 上。
在专家并行(Expert Parallelism)架构下,每个 MoE 层在前向传播过程中都需要执行两次 all-to-all 通信步骤:分发(dispatch)和合并(combine)。路由器会为每个 token 选择 top-k 个专家,并将 token 分发给内存中持有这些专家的 GPU。随后,每个 GPU 通过一次分组矩阵乘法(grouped matrix multiplication),对其接收到的 token 计算本地专家的输出。最后,专家输出会被发送回每个 token 原本所在的 GPU 并进行合并。
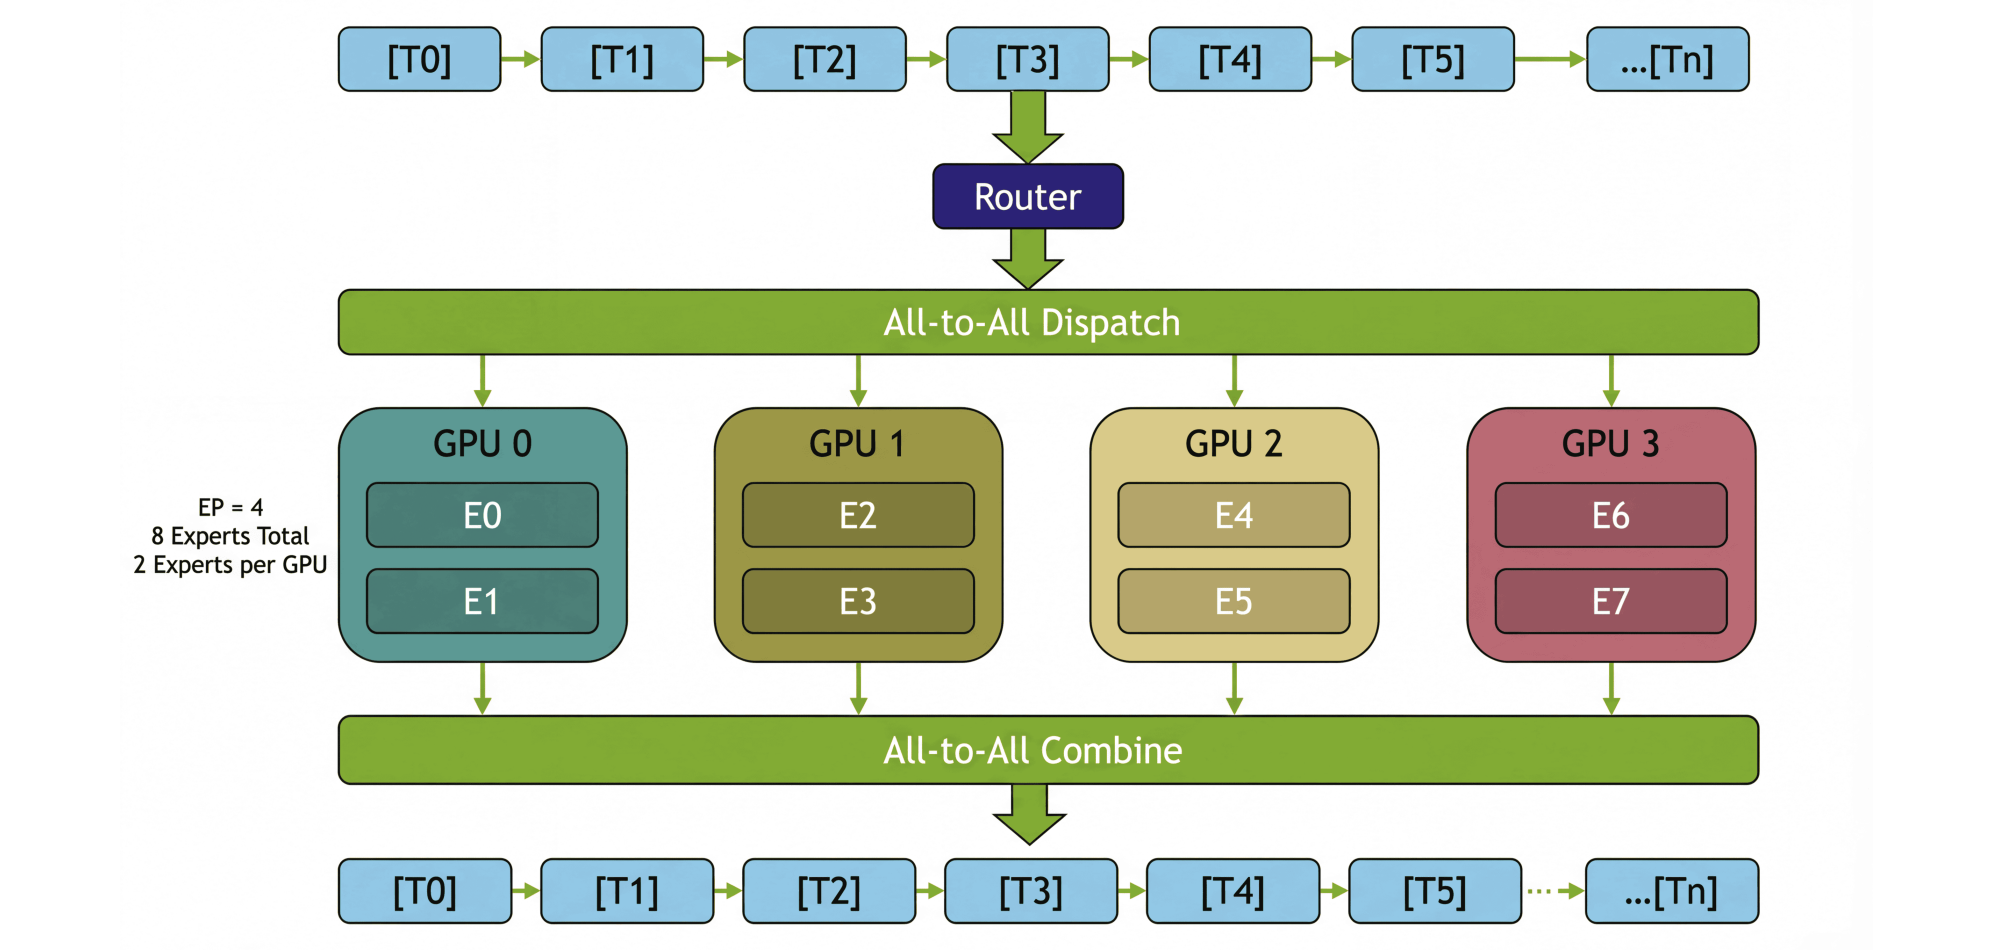
图 2. 专家并行将专家分布到各个 GPU 上。all-to-all 通信负责将 token 分发给其指定的专家并合并结果。(来源:NVIDIA,图 4。)
随着模型增加更多的 MoE 层并将每个 token 路由到更多专家,all-to-all 流量随之增长,从而引入了通信瓶颈。
使用 64 路专家并行训练 MoE 模型时,每个 MoE 层的专家会分布在 64 个 GPU 上。在标准的 8-GPU 服务器上,这会将 all-to-all 流量从高带宽的 NVLink 转移到带宽窄得多的 InfiniBand 互连网络上,而未优化的通信可能会占用 高达 60% 的训练时间(§1.2)。而在 NVL72 系统上,所有 64 个 GPU 都位于同一个 NVLink 域内,从而 有效消除了通信瓶颈(§9.2.2)。
推理也需要高速节点间网络 #
上文讨论的并行技术并非仅适用于训练阶段。除了使推理引擎能够服务单卡无法容纳的大模型外,模型并行还能提升吞吐量。将模型权重拆分到更多 GPU 上可以释放内存用于 KV Cache,从而使引擎能够处理更多并发请求或支持更大的上下文窗口。在某些情况下,释放出的内存增长速度快于 GPU 数量的增加:在一项 vLLM基准测试中,将模型进行张量并行(Tensor Parallel)拆分至两张 GPU 上,使得 KV Cache 块的数量增加了 13.9 倍,并带来了 3.9 倍的吞吐量提升。

图 3. Llama-3.1-70B 在单张与双张 H100 GPU 上的显存占用分布。(数据来源:vLLM.)
专家并行(Expert Parallelism)遵循相同的逻辑。在较低的专家并行度下,每张 GPU 需承载大量专家,导致留给 KV Cache 的空间减少。WideEP(指跨多节点的专家并行配置)显著降低了每张 GPU 上的专家数量。其代价是网络流量增加:所有的 all-to-all 通信现在需要跨越更多的 GPU。在标准的 8-GPU 服务器上,专家并行组最多只能跨越八张 GPU,否则就必须通过 InfiniBand 进行通信,而在此场景下每 GPU 带宽会下降 18 倍。NVL72 架构通过将机架内的全部 72 张 GPU 保持在 NVLink 连接范围内,消除了这一限制。在以交互速度服务 DeepSeek-R1 时,采用 32 路专家并行的 GB200 NVL72 相比受限于 8 路并行的 8-GPU B200 服务器,实现了高达 4.4 倍的单 GPU 吞吐量提升。
机架即新服务器 #
NVL72 将 NVLink 从单个节点扩展至整个机架,因此整个机架表现得如同一个拥有共享内存的巨型加速器。
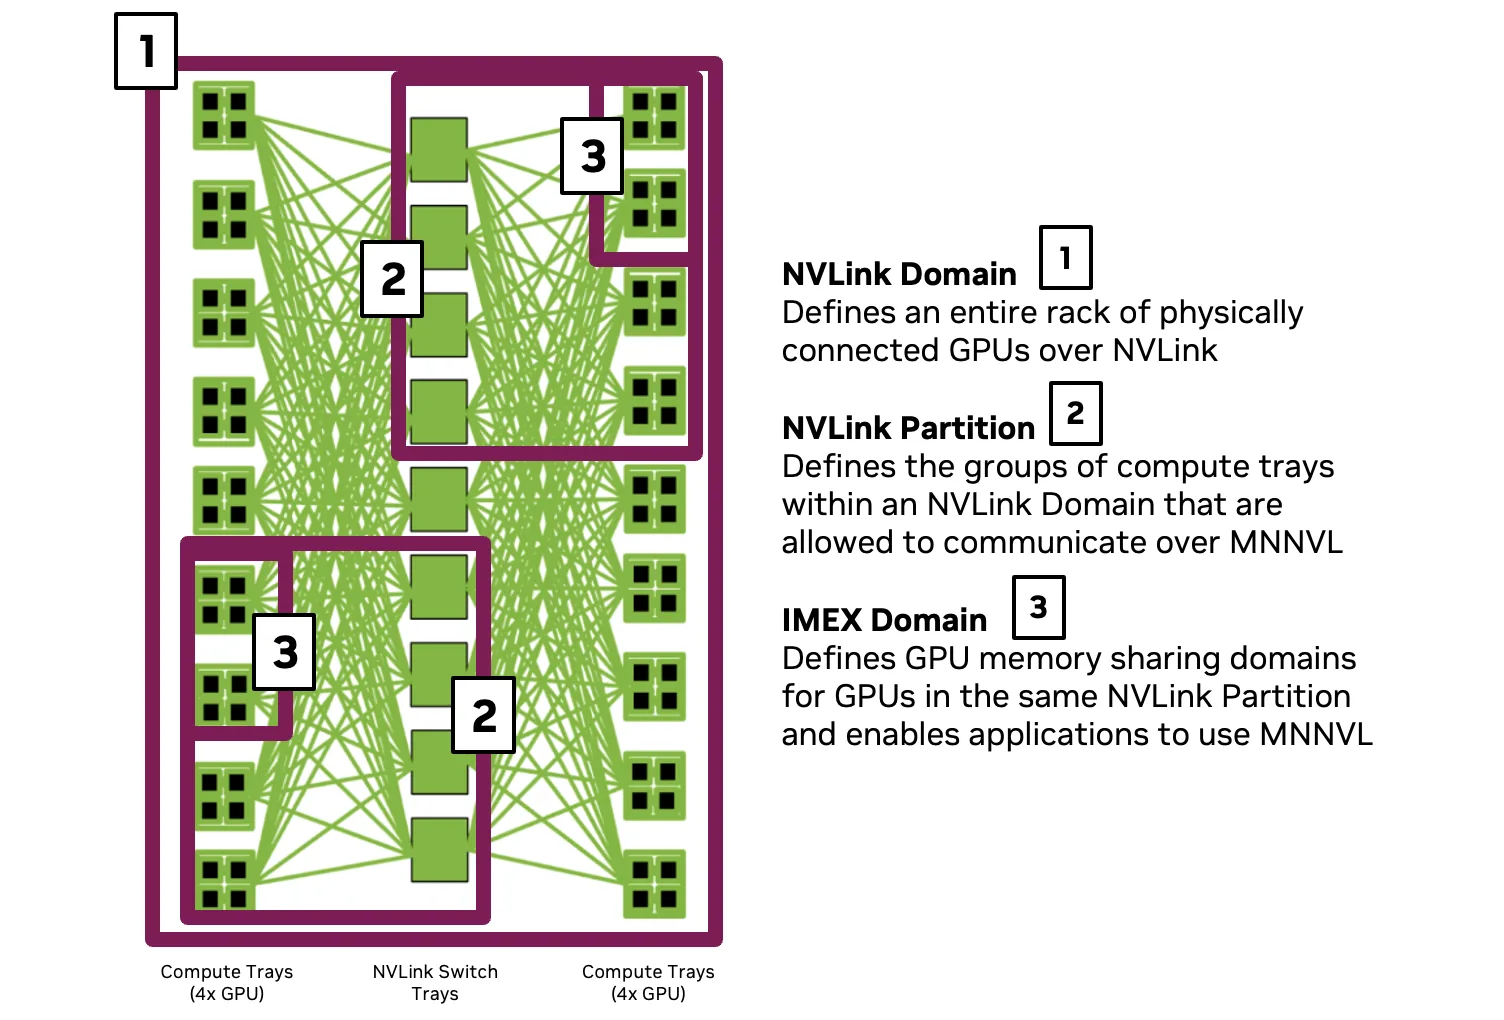
图 4. NVL72 机架内的 NVLink 层级结构。(来源:NVIDIA,图 1。)
NVL72 机架上的每个 GPU 均配备 18 个 NVLink 端口,每个端口提供 100 GB/s 的双向带宽,合计为每个 GPU 带来 1.8 TB/s 的总带宽。给定 GPU 上的每个 NVLink 端口都映射到支撑机架 fabric 背板的 18 颗 NVSwitch 芯片之一。由于每颗 NVSwitch 芯片可接入 72 条 NVLink 线路(来自每个 GPU 各一条),机架内部的聚合带宽高达 130 TB/s。
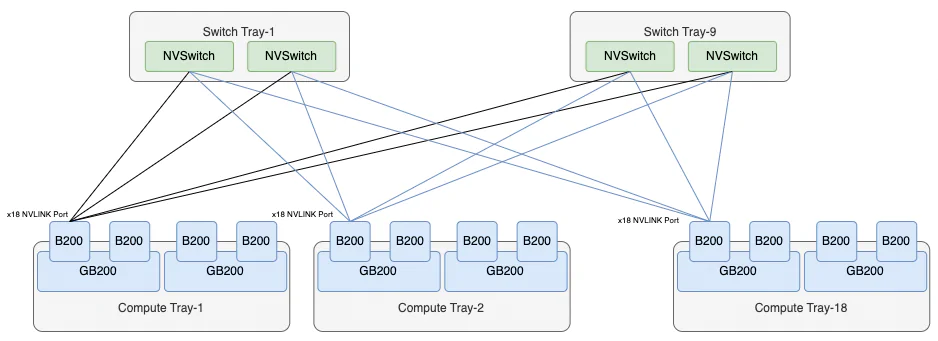
图 5. 每个 GPU 通过一个 NVLink 端口连接到机架中的每一颗 NVSwitch 芯片(共 18 颗)。(来源:NADDOD.)
这种网络拓扑结构确保了 fabric 是完全无阻塞的,意味着机架中的任意 GPU 都可以以统一的延迟向其他任意 GPU 传输数据,使其非常适合大规模分布式 AI 工作负载。
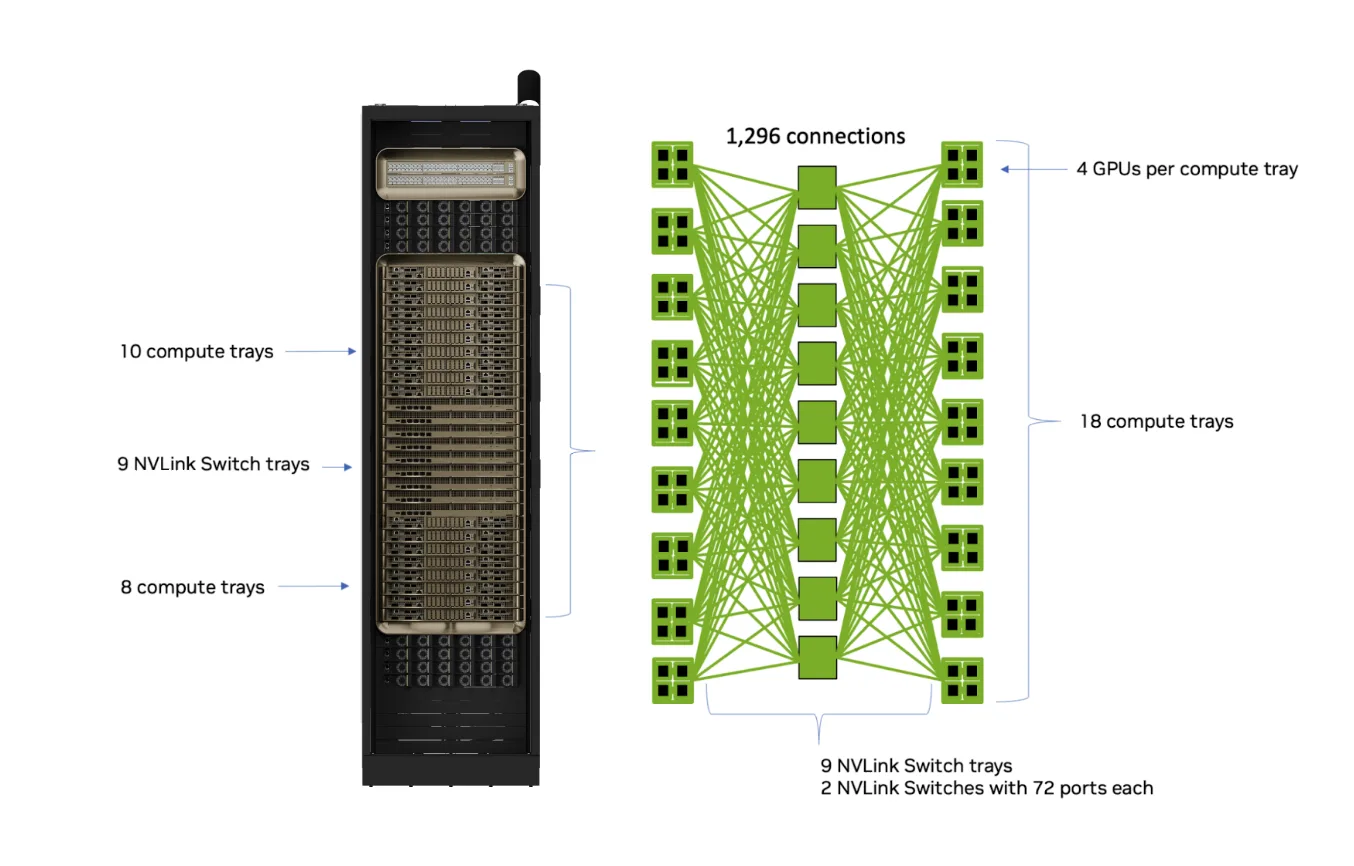
图 6。 NVSwitch 结构是完全无阻塞的。机架中的任意 GPU 都可以以全带宽和相同的延迟与任意其他 GPU 进行通信。(来源:NVIDIA,图 1)
少即是多:在每个机架中使用更少的节点可显著提高可靠性 #
对于 NVL72 系统,人们往往倾向于将完整的 18 节点机架分配给工作负载,以最大化集群利用率。但在实践中,通过在每个机架中保留几个备用节点,团队实际上能从集群中获得更多可用容量。
GPU 是不可靠的。在其吉瓦级超级集群上,Meta 在投入大量工程努力提升可靠性后,测得每个 4-GPU 节点的故障平均间隔时间(MTBI)约为 490 天。NVL72 集群将 72-GPU 机架作为计算的原子单元,这使得故障爆炸半径相比构成机架的 4-GPU 节点增加了 18 倍。机架的 MTBI 由以下公式给出:
Loading...
根据上述公式,机架大约每 490 / 18 ≈ 27 天就会发生一次中断。如果作业被分配整个 18 节点机架,那么每次中断都会导致整个机架不可调度,直到故障节点修复为止。在一个拥有 128 个机架的集群中,这意味着大约每 5 小时就会有一个机架变得无法用于整架作业。
为每个机架预留两个节点作为备用可以改变这一情况。当某个节点发生故障时,同一机架内的备用节点会取代它,因此单个节点故障不再会导致整个机架停用。代价是,在所有硬件健康运行时,每个机架中有两个节点处于空闲状态。
为了量化这一权衡,NVIDIA 对在一个拥有 128 个机架(2,304 个节点)的集群中,不同切片大小如何影响可用容量进行了建模,并分析了随着不可用节点比例增加时的变化情况。
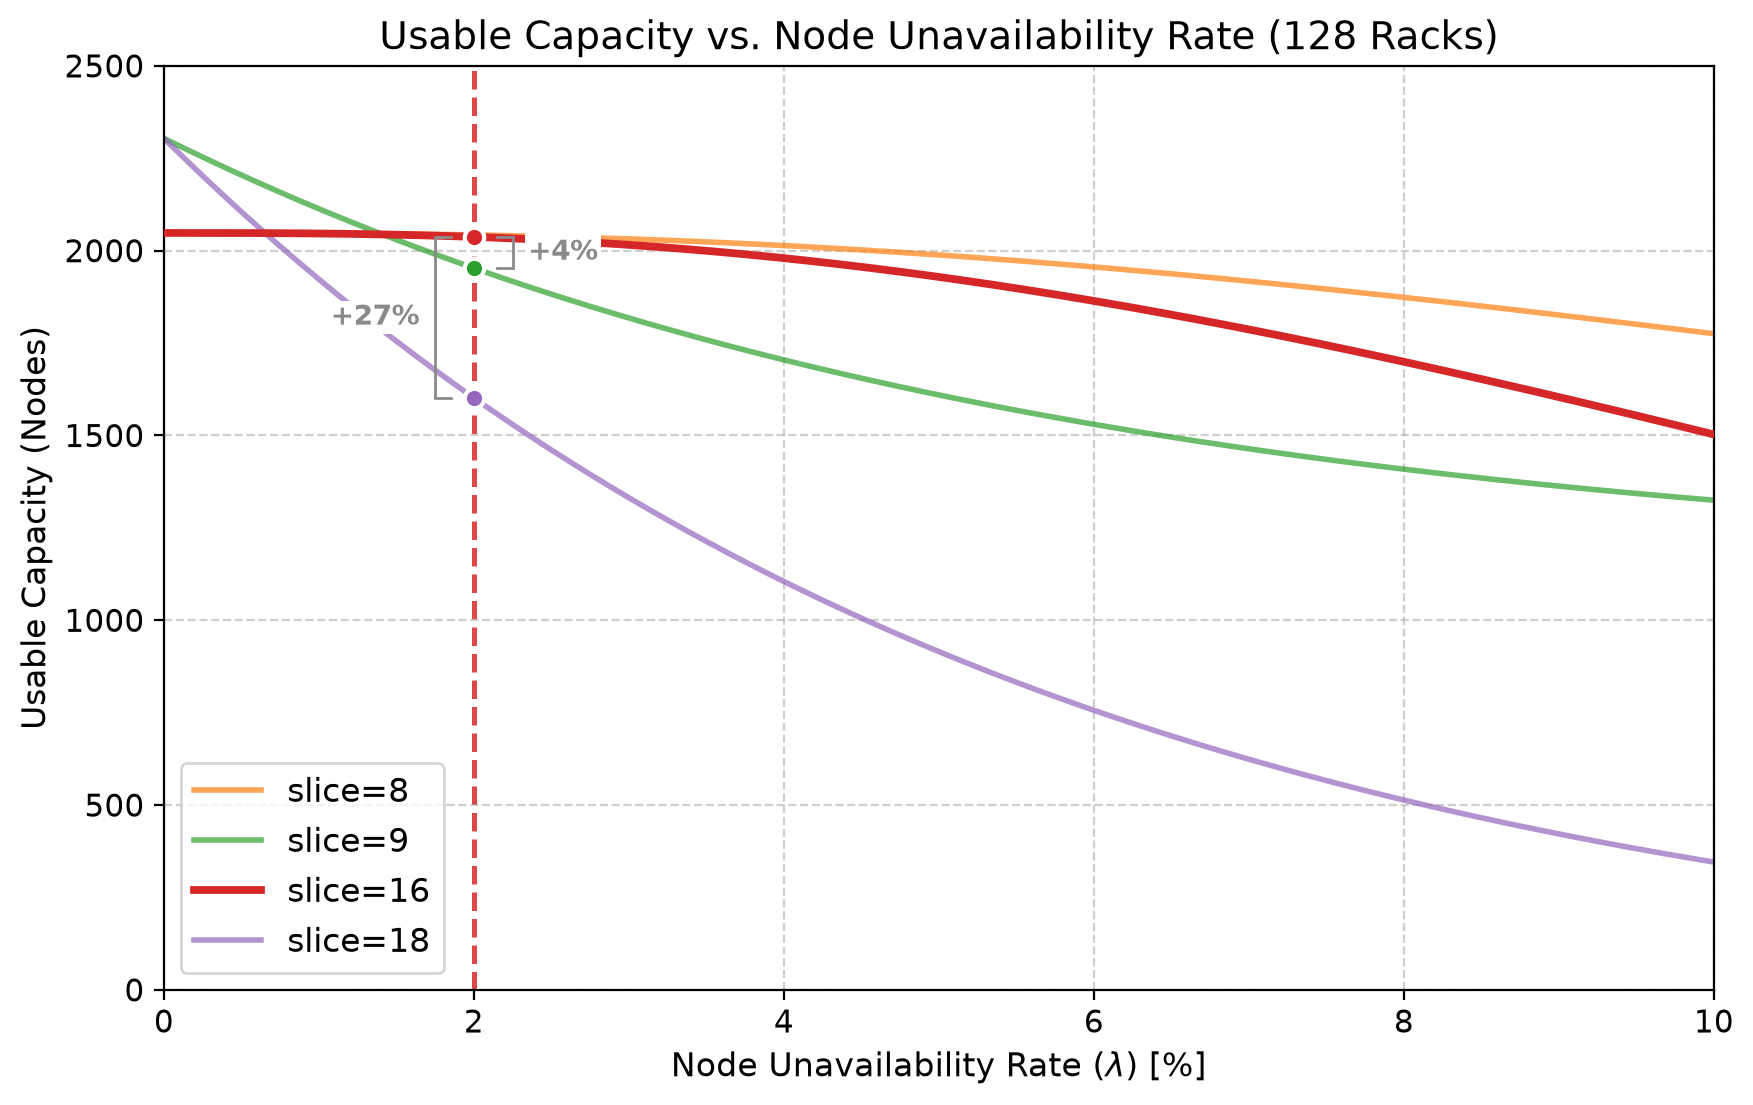
图 7. 随着节点不可用率增加,128 机架集群在不同切片大小下的可用容量。每个切片必须容纳在单个机架内。(改编自 NVIDIA,图 6。)
在 SkyPilot,我们管理着客户数以万计的 GPU,并在生产环境的 NVL72 集群上测得约 2% 的不可用率。在该比率下,NVIDIA 的模型显示,16 节点切片比 18 节点切片提供多 27% 的可用容量(2,037 个节点 vs. 1,602 个节点)。它们甚至比 9 节点切片高出 4%,尽管两个 9 节点切片恰好填满一个机架:使用 9 节点切片时,每次故障都会导致半个机架不可用;而使用 16 节点切片时,机架内的前两次故障可以被完全吸收。与 8 节点切片相比,16 节点切片使每个作业在每个 NVLink 域中获得两倍的 GPU 数量,同时在节点不可用率超过约 3.3% 之前,仅损失不到 1% 的可用容量。
16 个节点也是分布式 AI 工作负载的自然规模:64 个 GPU 是 2 的幂次方,这符合并行组通常的大小设定方式。
现代调度器如何将作业保留在 NVLink 上 #
到目前为止,我们已经探讨了为什么通信密集型并行技术最适合部署在 NVLink 上,NVL72 如何将 NVLink 从单个节点扩展至整个机架,以及为何采用“16 节点切片 + 每机架两个备用节点”的配置能最大化生产集群的可用容量。SkyPilot 将这些理念付诸实践:它将每个切片放置在单一机架上,就地恢复硬件故障,并在作业动态进出时保持整个机架的空闲状态。
调度器需要理解硬件特性
选择合适的切片大小只是第一步。研究人员如何确保多节点训练任务的每个切片确实落在同一个机架上?
朴素的调度器会将多节点任务拆分到不同机架,迫使工作节点通过 InfiniBand(单向 400 Gb/s)而非 NVLink(双向 1.8 TB/s)进行通信:

图 8. 朴素放置策略将多节点任务拆分到不同机架。
SkyPilot 的拓扑感知调度器(Topology-Aware Scheduler, TAS)确保工作节点共置于同一机架:

图 9. SkyPilot 的拓扑感知调度器将任务的工作节点保持在单一机架上。
对于跨多机架的工作负载,TAS 将任务拆分为 16 节点(可配置)的切片,并将每个切片放置在独立的机架上,同时预留两个备用节点。随后,当 SkyPilot GPU Manager 检测到 GPU 故障时,SkyPilot Frontier Trainer 可以用预留的健康节点热替换故障节点,而其余节点则继续无中断运行。如果同一机架内没有剩余的备用节点,Frontier Trainer 会将故障机架上的切片重新调度到一个健康的机架:

图 10. 基于切片的调度策略在每个机架中保留两个健康的备用节点。当 GPU Manager 检测到节点故障时,Frontier Trainer 会将故障节点替换为同一机架中的备用节点。
为了量化基于切片的调度带来的影响,NVIDIA 的 GR00T 团队比较了两种不同调度策略在 GR00T N1.7(一款面向人形机器人的多模态基础模型)预训练过程中的效果,该实验使用了分布在 128 个节点上的 512 块 GB300 GPU。第一次运行使用了一个简单的调度器,将节点放置在任意数量的机架上。第二次运行则采用了如图 10 所示的机架感知、基于切片的调度策略,将其精确放置在 8 个机架上。机架感知的放置方式使吞吐量提高了 14.4%,将每次迭代的时间从 1.59 秒缩短至 1.39 秒。
在一个拥有 10,000 块 GPU 的集群上,同样的加速比每小时可节省约 16,700 美元的训练成本。仅通过优化调度决策,每天即可节省约 400,000 美元。
碎片化阻碍机架级作业
到目前为止,我们探讨了拓扑感知调度在独立场景下的工作原理。在实际应用中,大型集群通常是共享的:预训练任务、强化学习(RL)展开(rollouts)和批量推理等异构工作负载会竞争相同的资源。TAS 在调度时会在同一机架内对工作负载进行装箱(bin pack),但由于作业完成时间不同,空闲节点会分散在各个机架中。这就是碎片化问题:集群虽然拥有足够的空闲 GPU 来运行一个机架级作业,但因为这些 GPU 分散在不同机架中,导致该作业无法被调度。

图 11. 由于作业完成时间不同,空闲节点分散在各个机架中。尽管有 16 个空闲节点,但它们分布在两个不同的机架中,导致需要 16 个节点的 hero-run 无法被放置,只能处于等待状态。
SkyPilot 的自动碎片整理(Auto Defrag)正是为解决这一问题而设计。当作业因拓扑结构而非容量受限被阻塞时,Auto Defrag 会找出干扰最小的工作负载集合进行抢占,从而释放整个机架。这些被抢占的工作负载会被重新调度到其他机架上,从而使被阻塞的作业得以调度。

图 12. Auto Defrag 抢占 sft-d 并将其重新调度到 rack-a,在那里它从检查点恢复运行。这释放了 rack-b,使得 hero-run 可以作为单个 16 节点切片进行调度。
Auto Defrag 仅抢占那些能够安全重启的工作负载,例如可从检查点恢复的托管作业。除非管理员明确选择启用,否则交互式开发环境不会受到影响。
结论 #
大规模 AI 工作负载默认是分布式的,且其网络密集型通信模式位于关键路径上。NVL72 等机架级系统旨在通过硬件解决这一瓶颈,但仅靠硬件并不能保证加速效果。这些系统需要机架感知放置、对硬件故障的容错能力,以及随着作业进出而进行的动态再平衡。SkyPilot 平台专为弥补这一差距而构建:拓扑感知调度确保多节点作业保持在 NVLink 上;当 GPU Manager 检测到硬件故障时,Frontier Trainer 会切换至健康的备用节点;自动碎片整理则保持共享机架为大作业预留空间。如果你正在管理 NVL72 集群,我们很乐意与你交流。