LangChain 开源 Deep Life Sci:面向生命科学的多智能体框架,集成千万文献检索与安全沙箱数据分析
LangChain 推出开源多智能体助手 Deep Life Sci,专为临床与实验室科学家设计。该工具通过整合数千万篇科学文献、在安全沙箱中执行数据分析,并调度数百个子智能体来处理复杂任务,旨在解决通用 AI 缺乏领域知识的问题。此外,它支持用户注入私有数据,并结合 LangSmith 进行追踪与评估,以实现研发流程的透明化与定制化。
报道正文
本文目录8 个章节
Michael CunninghamPrab SinghSeptember 17, 20265min返回博客创建智能体创建智能体
核心要点
- 过去几十年间,制药研发成本急剧攀升。智能体(Agents)有望扭转这一趋势,但通用 AI 工具缺乏生命科学领域真正需要的专业知识和数据集成能力。
- 我们开发了 Deep Life Sci,一款面向临床和实验室科学家的开源智能体助手。它直接检索数千万篇科学文献,在安全沙箱中执行数据分析,并将任务委托给数百个子智能体(sub-agents)。
- Deep Life Sci 让掌控自身智能变得简单。研发团队可以添加自己的数据和上下文,并利用 LangSmith 的追踪(tracing)和评估(evals)功能来洞察实际效果。
Eroom’s law(提示:将 Eroom 倒过来读)是摩尔定律(Moore’s Law)的“邪恶双胞胎”。过去 70 年间,计算能力的价格呈指数级下降,催生了个人电脑、互联网、手机以及如今的 AI 革命。不幸的是,药物研究却背道而驰,每款新药的研发成本每九年便翻一番。
AI 智能体有潜力扭转这一趋势,但通用解决方案并未针对生命科学组织所需的领域特异性进行构建。正因如此,我们开发了 Deep Life Sci:一款专为临床和实验室科学家打造的开源智能体助手。
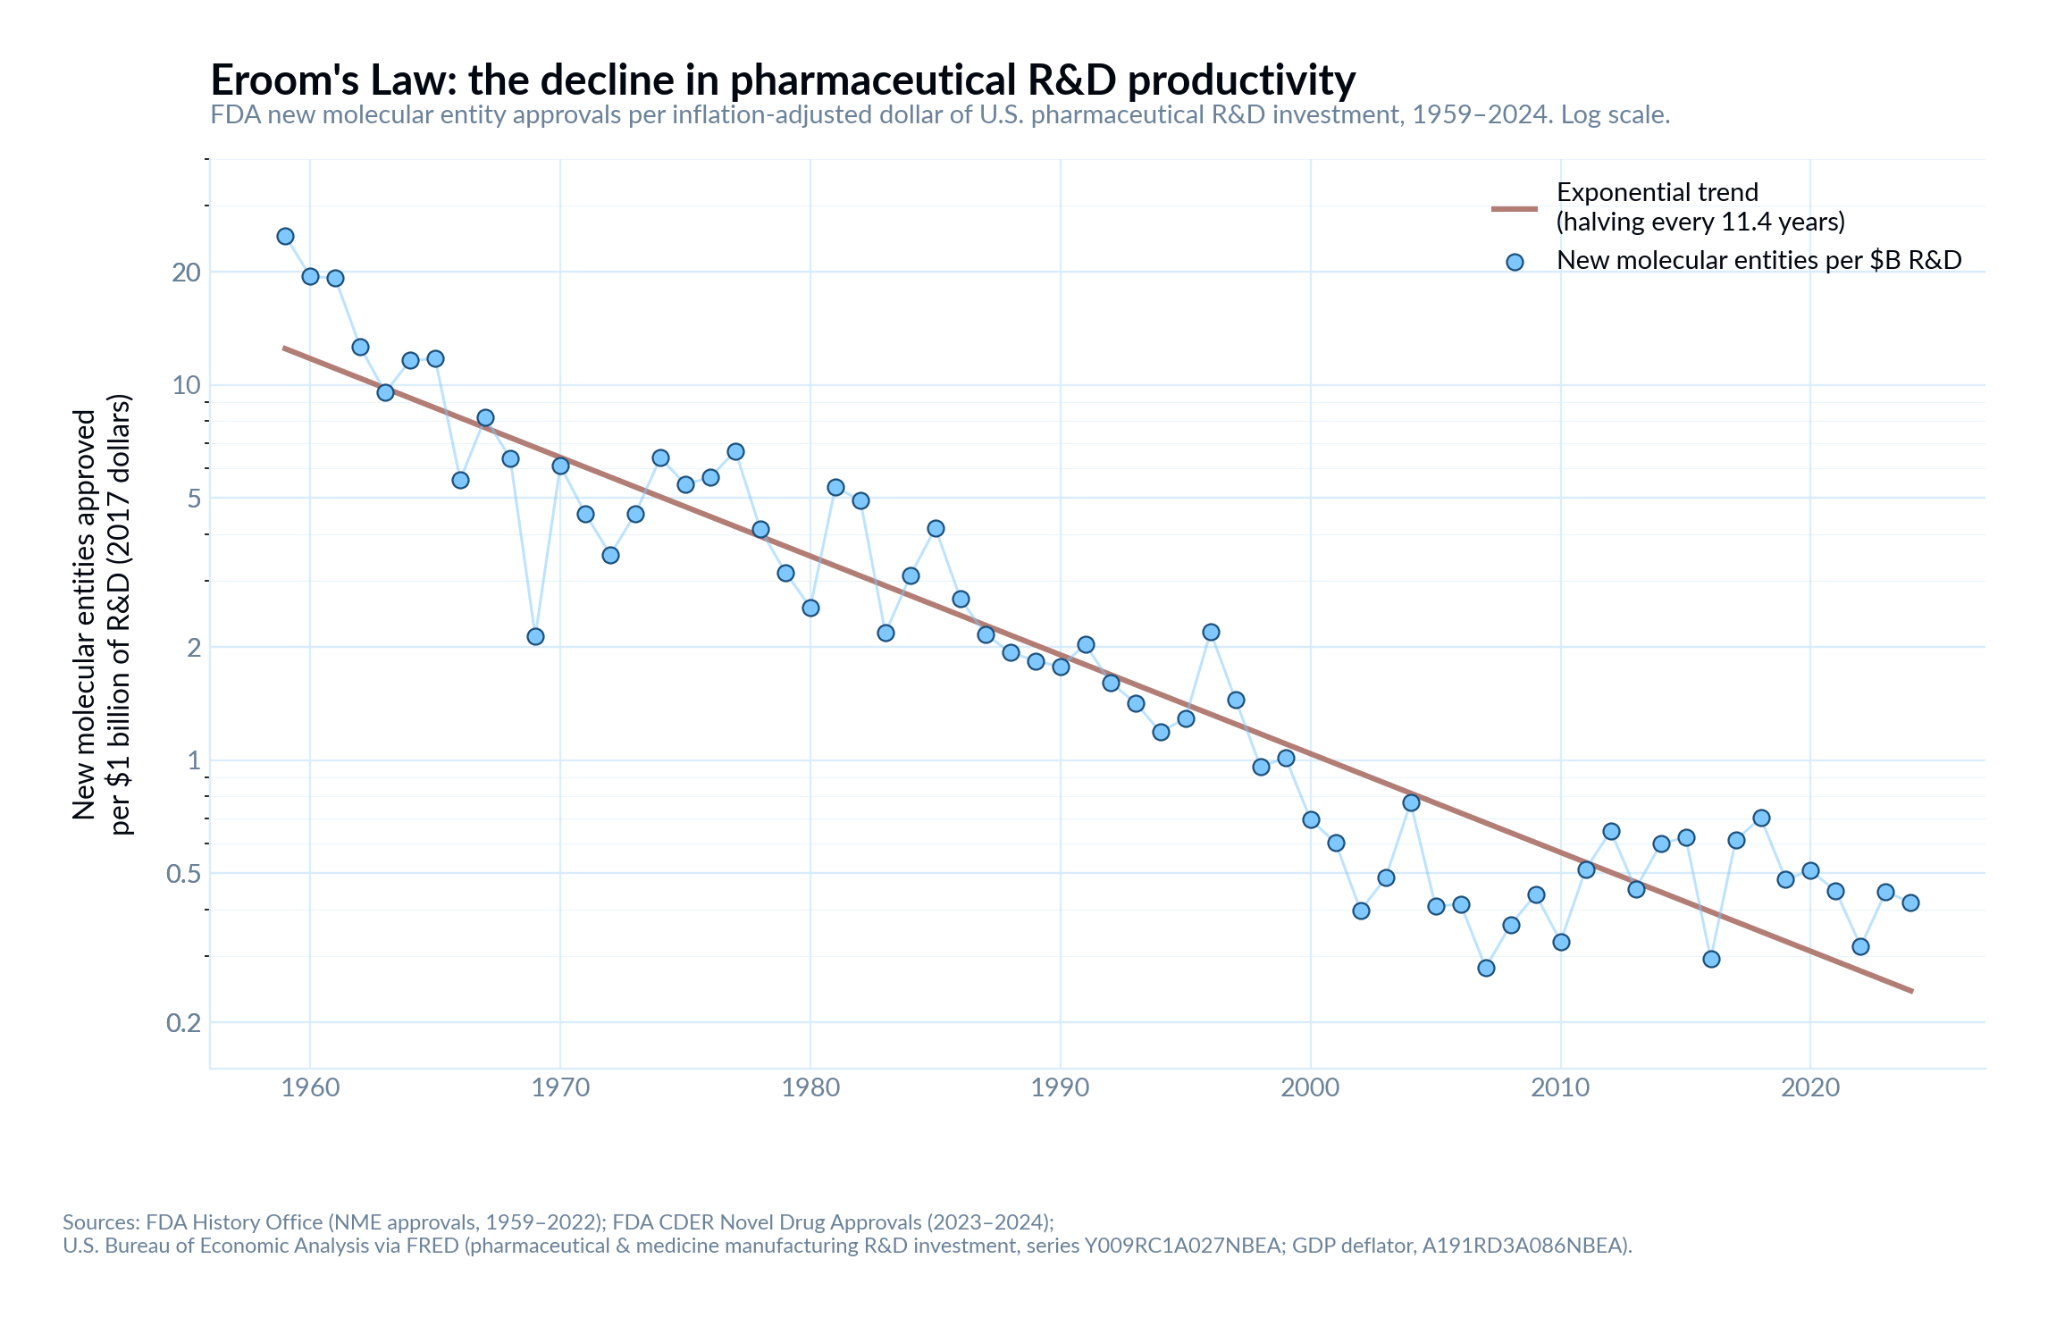
不断加速攀升的药物研发成本
制药行业成本的失控式增长源于药物开发流程的两个阶段:临床前研究和临床试验。识别有前景的药物靶点,需要在数百万篇科学论文和海量生物数据集中筛选洞见。一旦候选分子被认为可能安全且有效,便会进入人体临床试验阶段,此时必须处理数万页的文书工作,以确保符合日益增多的 FDA 法规要求。
许多 AI 公司承诺其工具将有助于恢复研究生产力,但像 Claude 和 ChatGPT 这样的通用型 AI 助手缺乏必要的领域知识以及与科学数据源的集成能力。而针对生物技术领域的更专业化 AI 产品往往收取高额溢价。
在这两种情况下,agent harnesses(智能体框架)都是专有的,这阻碍了用户对其进行定制,并将其锁定在昂贵的闭源模型中。这一问题在生命科学领域尤为关键,因为 GxP 验证要求详尽的文档和审计日志,以阐明系统为何表现出特定行为,这就要求企业完全掌控用于驱动临床决策的任何系统。
面向生命科学的开源智能体助手
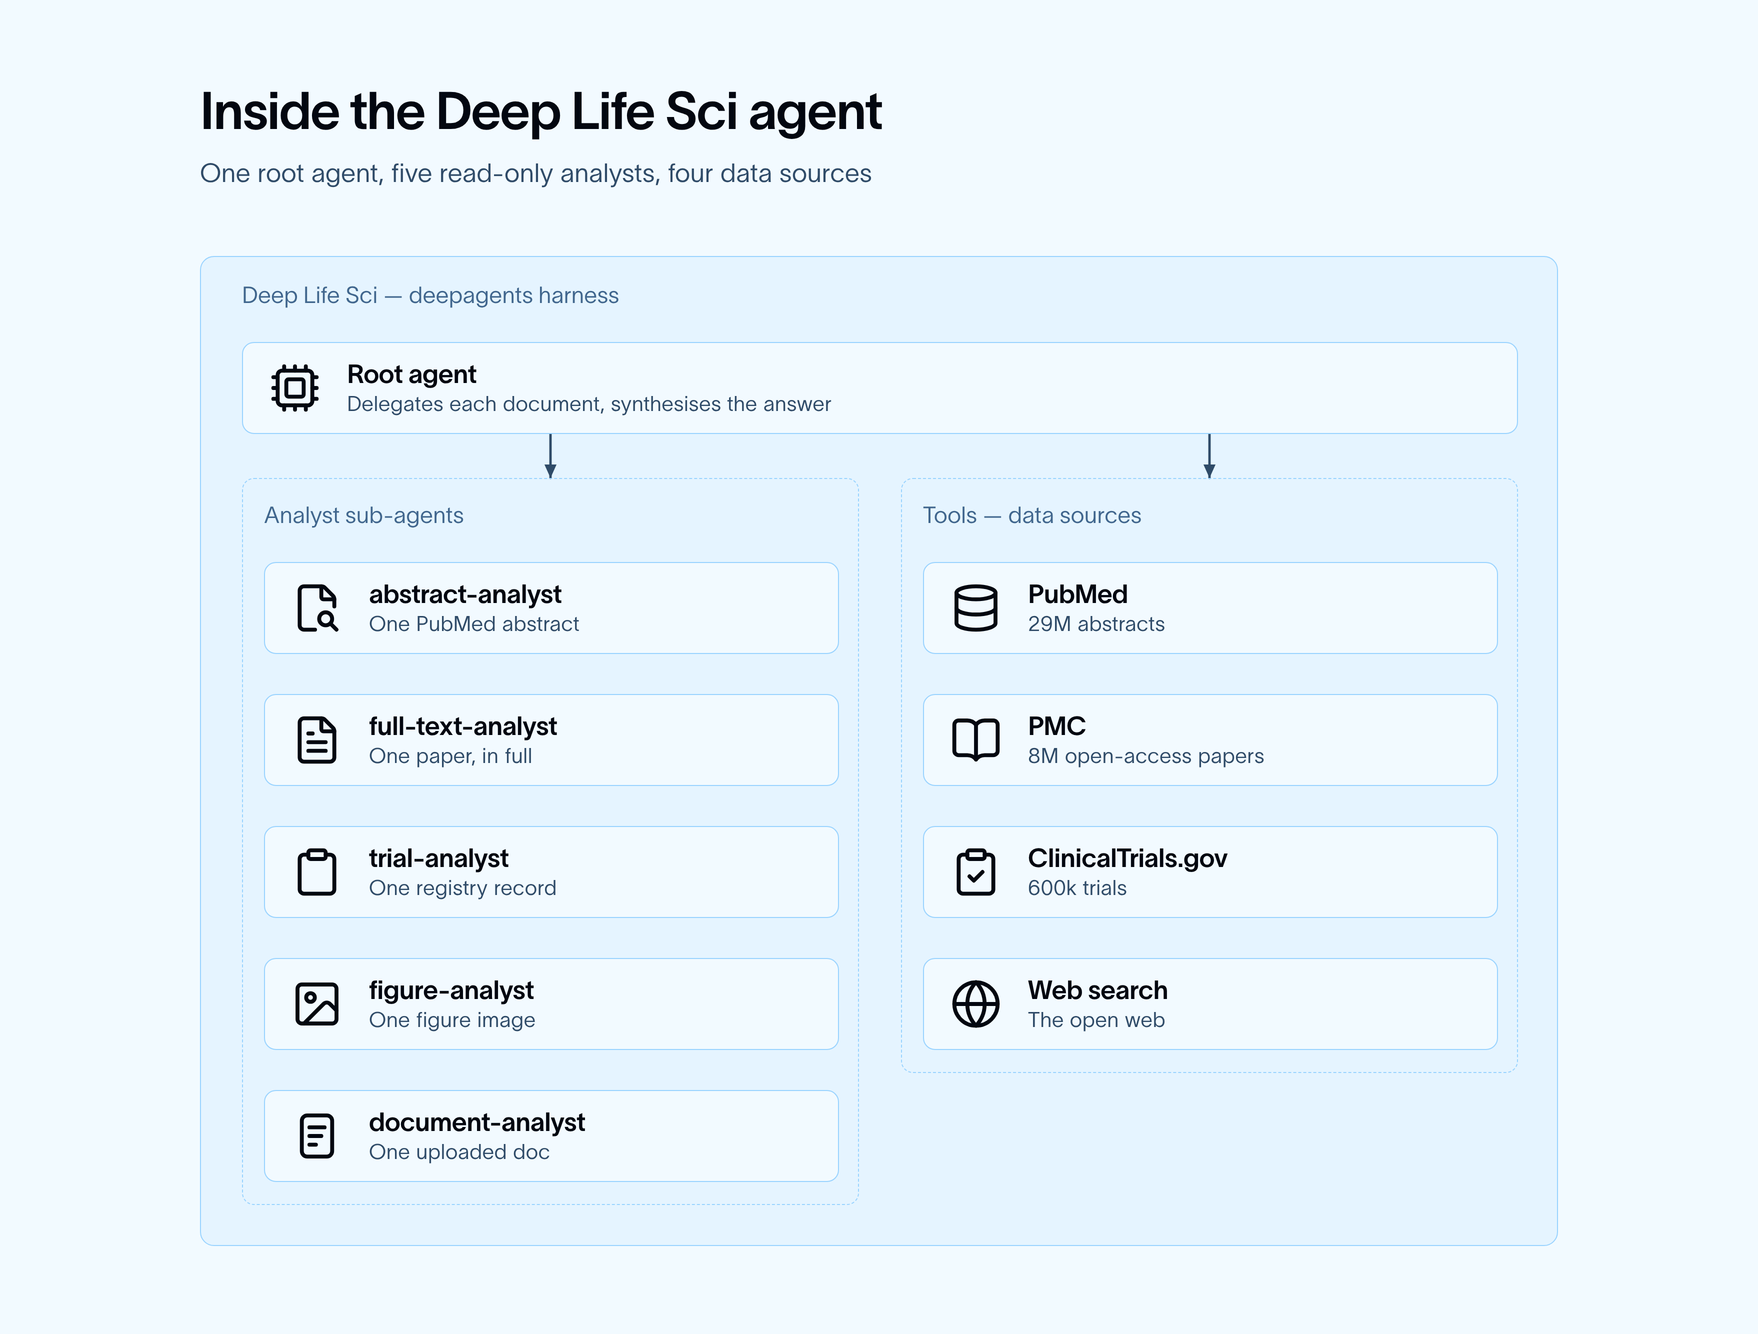
在 LangChain,我们相信那些 拥有自身智能 的组织将占据优势。我们开发了 Deep Life Sci,这是一个基于我们的 Deep Agents 框架构建的、面向临床和实验室科学家的开源智能体助手,旨在作为模板供企业采用并根据其用例进行修改。
Deep Life Sci 可以访问 ClinicalTrials.gov 上超过 60 万项注册研究的临床试验记录,通过 PubMed 获取 2900 万篇论文摘要,以及从 PubMed Central 获取 1200 万篇全文文章。它能够通过分配任务给 sub-agents(子智能体),同时审阅数百份文档。每个智能体都配备了一个 LangSmith sandbox(沙箱),使其能够安全地运行代码以执行任意数据分析。用户可以上传 PDF、图像、表格数据文件、书目文件(如 RIS)、序列文件(如 SMILES、FASTA)等,供智能体在其工作中使用。
Deep Life Sci 的智能体工作流示例
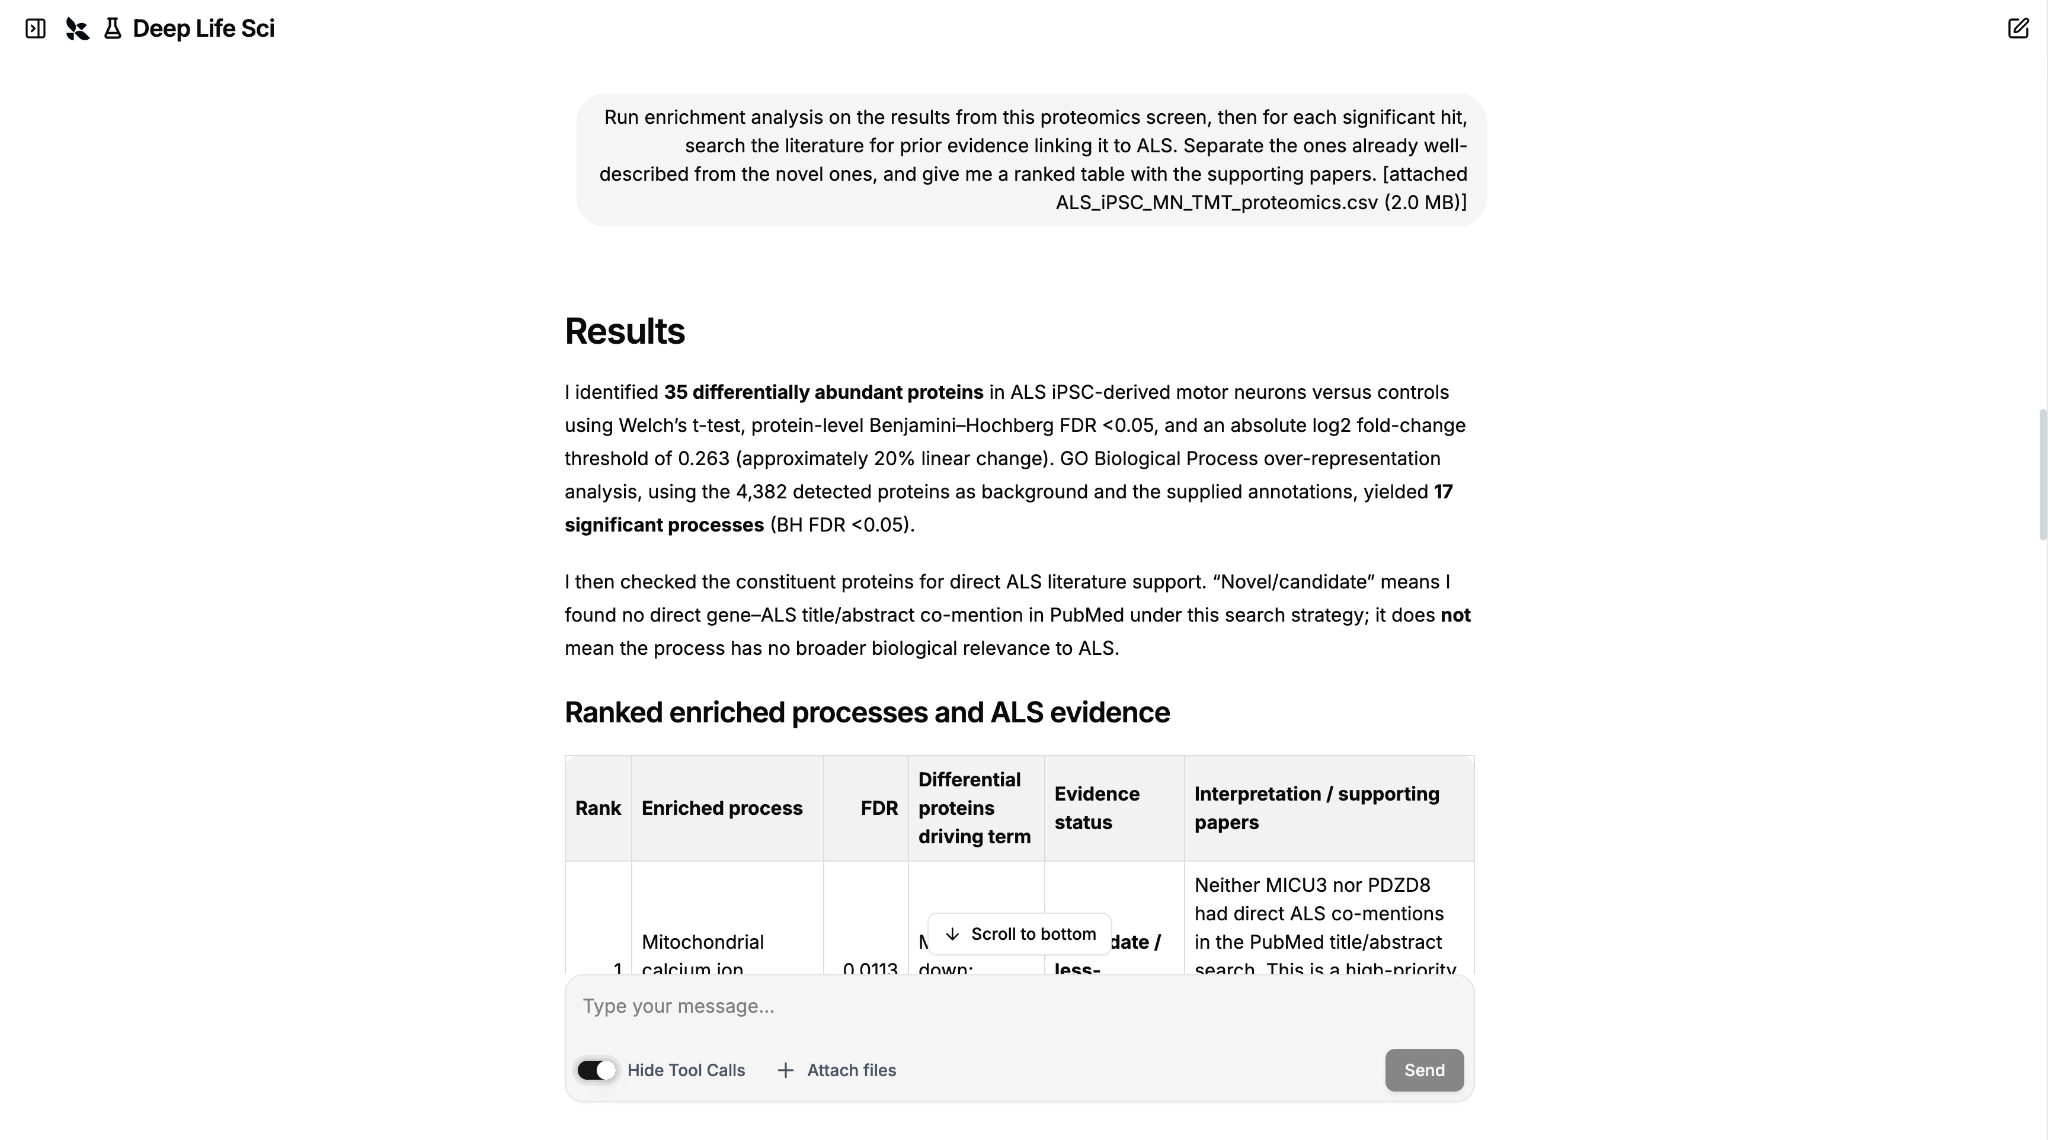
在典型的工作流程中,实验室科学家完成 RNA-seq 或蛋白质组学筛选后上传结果表格。智能体在沙盒环境中运行富集分析以识别差异表达基因,随后检索文献寻找将每个命中结果与表型关联的既往证据,区分已充分描述的基因与新发现基因,并返回包含支持性论文的排名表格。
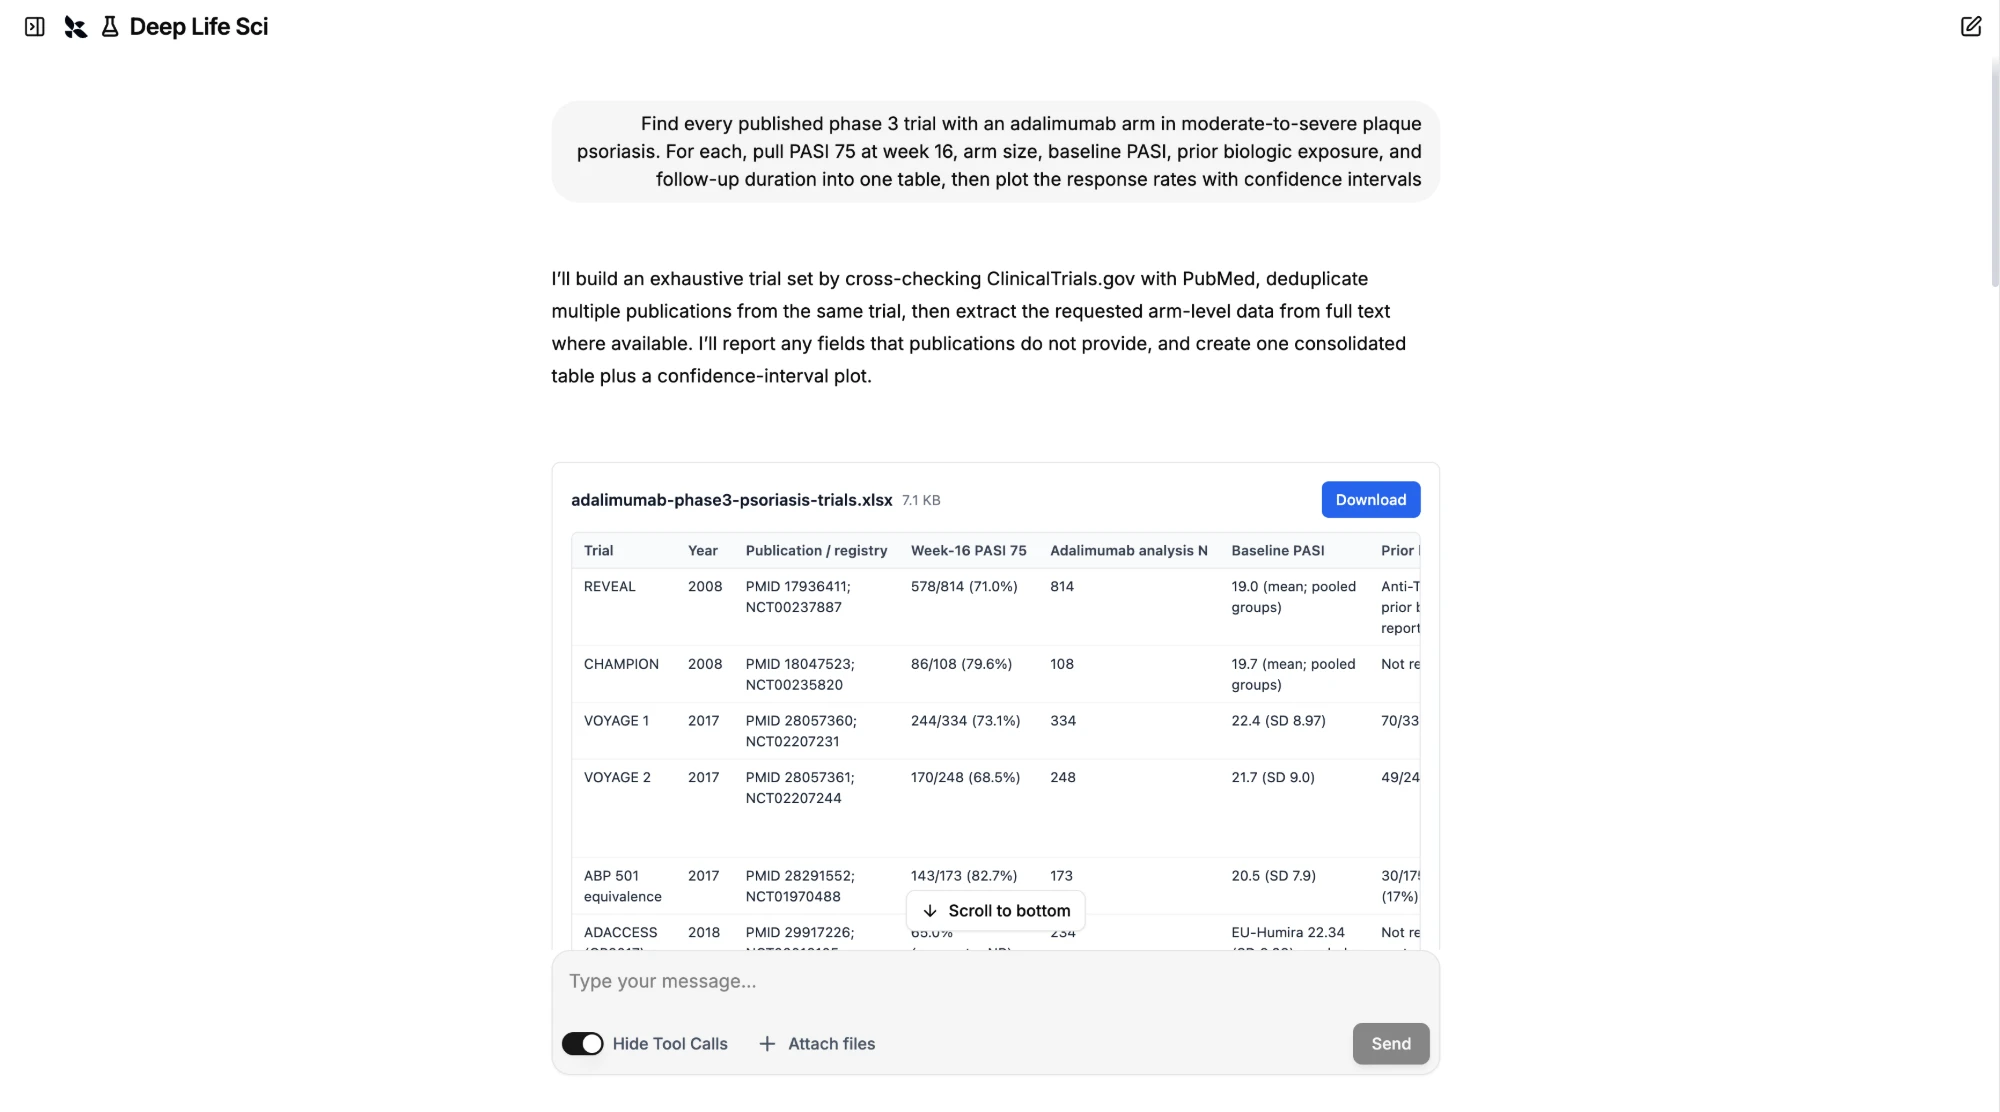
另一方面,临床开发或 HEOR(健康经济学与结果研究)团队可能需要查找某一适应症下标准疗法的所有已发表试验,并一致地提取终点指标值、样本量(N)、人群特征及随访时长。智能体执行搜索,根据标准进行筛选,将每项试验提取到通用模式中,并生成表格以及森林图风格的对比结果。
在临床试验阶段,会产生数千页不同类型的文档,包括知情同意书、临床方案文件及其修正案、病例报告表等——所有这些文档在定稿前都必须经过多次彻底的审计、审查和编辑。使用 Deep Life Sci,用户可以上传参考方案文档,调研并收集额外的统计信息,快速整理必要的反馈和修改建议,从而显著缩短临床文档处理时间。
在研发中掌握自主情报
当智能体经过优化并集成到公司生态系统中时,Deep Life Sci 的价值会进一步倍增。Deep Life Sci 了解主要终点指标是什么,但它并不知晓公司特有的细微差别,例如内部检测的结果、监管机构曾提出异议的终点指标,或者实际入组而非仅承诺入组的试验中心情况。
将这一上下文整合到 harness 中,正是“掌控自身智能”在实际操作中的体现。由于 Deep Life Sci 的代码是开源的,组织可以根据自身需求灵活地进行定制。这种定制化可以包括:添加与内部数据和文档的集成、利用不同的前沿模型和开源模型、实施护栏(guardrails)和审批关卡等。
修改 harness 意味着你已置身于 Agent 开发生命周期 (ADLC) 之中:构建、测试、部署、监控,然后将学到的经验反馈给下一个版本。追踪(Tracing)和评估(Evaluations)为这一开发闭环提供动力。
追踪:了解你的 Agent 正在做什么
每一次 Deep Life Sci 的运行都会在你的 LangSmith 账户中进行端到端的日志记录,包括 Agent 发起的文献检索、在沙箱中运行的代码、每个子 Agent 读取的文档,以及它如何从这些信息推导出最终答案。这些轨迹不仅有助于调试和改进 Agent,还可作为审计记录。
评估:持续改进你的 Agent
评估能够告诉你针对 Agent 所做的更改是否提升了其性能。Deep Life Sci 自带一套默认评估集,随着你添加集成并识别新的用例,你可以对其进行修改和扩充。在更换模型或重写提示词前后运行该评估集,你就能清楚地看到新版本究竟是真正有所改进,还是悄然出现了退化。
Agentic AI 已经在编程和数学等领域引发革命。生物医学领域——其中成本效益和迭代速度直接关乎人类生命的拯救——不应落后于时代。那些将 Deep Life Sci 等开源工具与 LangSmith 的 ADLC 能力相结合的生物科技和制药公司,能够通过在整个药物开发周期中实现成本节约和更快的迭代,从而逆转 Eroom 定律。

查看你的 Agent 实际在做什么
LangSmith 是我们的 Agent 工程平台,帮助开发者调试每一个 Agent 决策、评估变更,并一键完成部署。