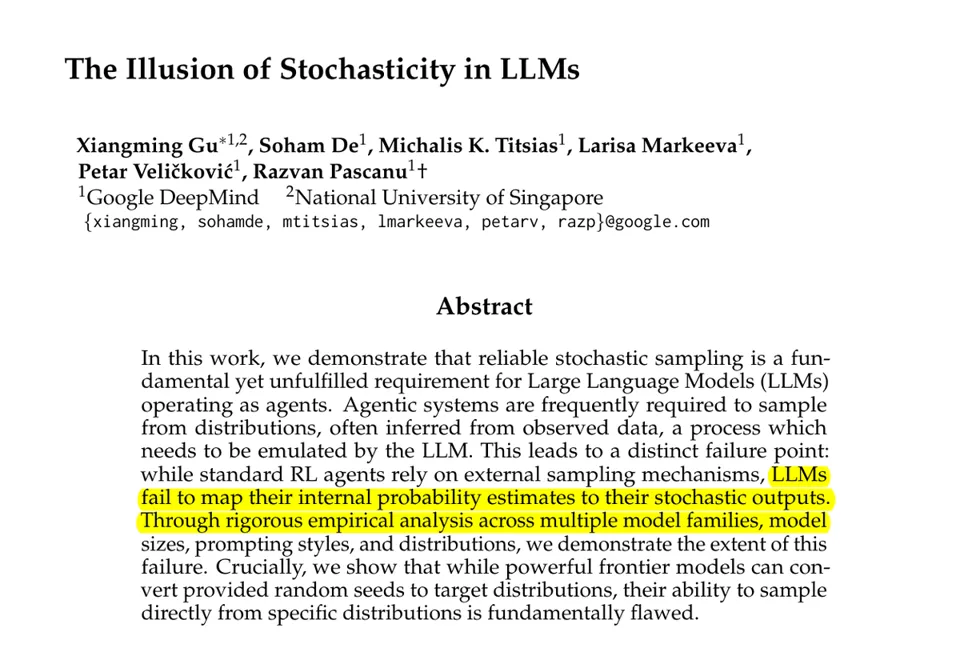
DeepMind 研究:LLM 无法自主生成真随机数
原标题:New Google DeepMind paper finds that AI models cannot make truly random choices on their own, but la...
78AI 研判分
Google DeepMind 最新论文指出,大语言模型(LLM)在独立执行时无法产生符合统计分布的真随机选择。实验显示,即使调整温度或采样参数,模型仍倾向于特定数字;但在外部代码提供随机种子后,较大模型能正确转换。该发现对依赖随机性的智能体安全与决策机制具有直接工程指导意义。
报道正文
Rohan Paul (@rohanpaul_ai) · 2026-10-26 18
Google DeepMind 最新论文发现,AI 模型无法自主做出真正随机的选择,但当计算机程序先提供一个随机数时,较大的模型能够正确选取。
Agent 经常需要以固定概率随机选择动作,例如以不可预测的顺序检查服务器。LLM 声称会均匀分布地选择,但实际上总是倾向于某些“幸运数字”,如 7、42 或选项 C。
研究人员要求 Gemini、Qwen3 和 OLMo 模型分别从简单分布中采样 1024 次。他们还尝试了不同的 temperature 和 sampling 设置,并给模型提供随机数让其转换。
所有用于验证是否匹配目标概率的统计检验均失败,调整 temperature 或 top-p 也无法解决问题。在一个安全博弈场景中,若采用真正的随机检查,攻击者获胜的概率为 75%;而使用 Gemini 的选择策略时,攻击者的胜率高达 96.6% 至 99.9%。
如果你的 Agent 需要随机性,请在代码中生成随机数并传入模型,而不是指望模型自身产生随机性。