深度解析线性注意力机制演进与 AI Infra 实现
本文深入剖析线性注意力机制从 DeltaNet、GDN 到 KDA 的架构演进,重点阐述如何将复杂的非线性 RNN 门控推导为仿射变换与下三角矩阵求解。文章揭示了在模型表达能力与硬件计算吞吐之间寻求平衡的技术逻辑,适合希望理解大模型底层推理机制的开发者阅读。
报道正文
本文目录57 个章节
如果你真的想了解大模型的推理,本文绝对值得阅读
作者:binnnliu
导语 本文非科普文~ 如果你真的想了解大模型的推理,本文绝对值得阅读
最近有点沉迷学习AI Infra了,差不多废寝忘食的程度。强烈的好奇心驱使,每个地方想要做到"知其所以然"。
然而,你知道的,大模型本身为什么能够涌现出推理和思考能力,目前在很大程度上仍是不可解释的。这个东西更多的是实验科学,这是大模型原理层面的"It just works"。
前不久,数学家陶哲轩在加州理工的 Math 2.0演讲中提出了一个问题:如果 AI 研发出的癌症新药通过了三期临床试验,在把它真正用到患者身上之前,我们是否要求至少有一位人类专家能理解其药理机制?他的本意是警示不可解释的黑盒风险,却引来群嘲:毕竟医学上本来就存在大量先发现疗效、后来才逐渐理解机制的药物。这是 AI 应用层面的 "It just works"。
好在大语言模型的底层支撑——AI Infra领域,算子实现与优化、显存分配和 GPU 架构调度都建立在严格的数学与物理逻辑之上。
本文要深入探讨的线性注意力机制演进同时涉及这两个层面:在模型层面,如何设计遗忘门与残差写入(从 DeltaNet、GDN 到 KDA),属于基于假设的实验科学;而在 AI Infra 层面,为了兼顾模型表达能力与 Chunk-wise 并行的计算吞吐,复杂的非线性 RNN 门控必须被严格推导为仿射变换与下三角矩阵求解。说到底,架构设计就是在代数结构、算法表达力与硬件访存成本之间不断 trade-off。
背景
大模型的推理流程分为两个阶段:Prefill 和 Decode。你有没有想过,哪个过程硬件利用率更高?
答案显然是Prefill。Prefill是计算密集型,Decode是访存密集型,显然Prefill可以充分利用GPU的计算能力,Prefill效率更高。但是为啥呢?Prefill的本质就是批处理,通过把多个 Token 打包成矩阵乘法(GEMM),提升计算强度,分摊访问显存中权重的开销。这句话对么?对,但是不全面,没有提及KVCache,这正是大模型推理与其他推理过程的不同所在。
我们知道大模型推理过程中,显存数据主要分为3种:权重(固定大小)、KVCache(线性增长的O(N))、激活值。
Prefill 的高利用率不仅来自多个 token 对模型权重的复用,也来自同一个请求多个 Q对同一批 K/V tile 的复用。Decode呢?每计算一个token,GPU 必须把模型的权重从显存里捞出来读 1 次;更要命的是,还要把显存里积累的所有 历史 KV Cache 全都捞出来读 1 次,导致计算单元白白浪费在等待访存上。
Decode阶段有没有可能做到分摊呢?vLLM引入了Continuous Batching,即从request维度的批处理变成了token维度的批处理,读一次权重可以处理来自不同请求的token;而PagedAttention的引入则是为了:按照token维度处理最好显存的分配也能按照token维度处理,否则的话,每个请求一开始就按照max_length来申请KVCache会产生大量显存碎片,浪费显存。
除共享前缀外,不同请求的上下文是彼此隔离的,各自拥有独立的 KV Cache。这意味着,Continuous Batching 只能帮Linear/FFN层分摊模型权重的读取,却完全无法帮 Attention 层分摊历史 KV Cache 的读取。推测解码(Speculative Decoding)又在一定程度上解决了单请求Decode阶段KV Cache的访存开销问题,其本质是把Decode转换成微型的Prefill。
以上,如果上下文短没有问题,但是在动辄百万上下文的agent时代,会出现如下问题:
- KVCache显存占用随上下文线性增长; -> 显存空间;
- 每次Decode都要把所有的历史KV从显存加载到计算单元一次; -> 显存带宽;
- 计算量随上下文线性增长;-> 计算量;
如今大部分的模型架构创新基本都是为了解决以上问题,目前业界有3种方案:
- 稀疏注意力 DSA/SWA;
- 压缩注意力机制 Multi-head Latent Attention/Latent Compression Attention;
- 线性注意力机制 Linear Attention;
目前国内一线开源模型,除了DeepSeek、Tencent Hy,都是Linear Attention + Full/Sparse Attention的Hybrid架构,因此我觉得有必要深入学习下线性注意力机制。
当然还有一些其他方式,比如KV Cache量化、KV Cache跨层共享(DeepSeekV4.1 flash CED)、IndexCache索引跨层复用(Hy4 Preview)、Hierarchical Sparse Indexer。
从线性注意力到 KDA的演进
既然自回归的瓶颈在于 KV Cache 的线性增长,那很自然的想法:能不能把所有历史的 K 和 V 合并成一份固定大小的状态,让新来的 Query 不再苦哈哈地去遍历每一个历史 Token,而是直接与这个 O(1) 的状态进行交互。而这本质上就是RNN范式。
无论是哪一种线性注意力,其本质都是:把历史上下文,压缩进一个固定大小的状态矩阵 S∈ℝd**v× d**k 中。Decode 时只需用 o=Sq 读出,从而实现相对序列长度 O(1)(常数为 O(dvd**k))的显存占用、读取和计算量。但容量固定就意味着新知识会不断冲刷旧知识,而线性注意力演进的本质就在于如何更新这个固定容量的状态,为了能够更清楚的理解KDA(Kimi Delta Attention),我们需要把视角拉远,看看状态更新机制是如何一步步演进的。
普通线性注意力
(基于Transformers are RNNs, ICML 2020)
在标准的 Softmax 注意力中,第 i 个 Token 的输出计算如下(省略缩放因子):
在自回归解码(Decode)时,这里的核心痛点在于:Softmax,即exp(qtTkj) 是非线性操作,必须先用Q与所有的K算出完整的注意力分数矩阵,才能去乘所有的V。(PS:这里说的是逻辑上,实际上FlashAttention可以通过online softmax + kernel fusion运算,不必完整物化分数)这意味着必须保留所有历史的 K 和 V,这就导致了 KV Cache 随上下文线性膨胀。
线性注意力的思路是:是不是可以用一个可独立作用于 Q 和 K 的特征映射函数 φ(·)(例如 elu(x)+1)来替代 Softmax。 公式就变成了连续矩阵乘法:
由于 φ(q**i)Tφ(k**j) 是标量,也等于 φ(k**j)Tφ(q**i),利用矩阵乘法结合律,可以先累加历史 value 与映射后的 key 的外积,再右乘映射后的 query:
此时,求和号里面的部分,就是两个独立于 Q 的固定状态。我们定义:
- 记忆矩阵:S**i = Σj=1iv**jφ(k**j)T
- 归一化项:Z**i = Σj=1i φ(k**j)
可以看到,无论序列长度 i 增长到多少,状态 S**i 和 Z**i 的尺寸始终固定,且每步只需在上一时刻状态的基础上做一次加法更新。最终第 t 步的读取公式为:
去掉分母引入卷积
论文The Devil in Linear Transformer发现分母 φ(q**t)TZt 可能很小,训练时梯度不稳定。直接去掉分母、在输出端做归一化。
To avoid the unbounded gradients, we introduce NORMATTENTION, which gets rid of scaling over attention matrices while appending an additional normalization only after the attention layer.The choice of the normalization operator is unrestricted, for example, LayerNorm (Ba et al., 2016) or RMSNorm (Zhang and Sennrich, 2019) both serve the purpose.
分母被精简去掉了,原来要求 φ 恒为正,是为了让带分母的输出是合法的加权平均。去掉分母后,输出变成普通的线性组合 Σjwjv**j,负权重只意味着减去对应的 value,不再有这个限制。
线性注意力把历史上下文压缩进固定大小的状态,虽然避免了逐个访问历史 Token,但也可能在压缩过程中丢失细节,尤其需要额外加强对局部相邻 Token 的建模。为此,DeltaNet、GDN、KDA 等架构在投影后的 q/k/v 上加入一维因果短卷积(Causal Conv1d),先融合附近几个 Token 的信息,再进入全局状态的更新与读取。这套“卷积补充局部信息,线性注意力聚合全局历史”的组合,成为了这类架构中的常见设计。
这里千万不要被卷积这个名字吓到😓,其实说白了就是对qkv分别逐通道的、固定权重的滑动窗口加权求和。它和滑窗注意力都聚合局部信息,但注意力根据内容动态计算权重,短卷积使用训练得到的固定权重。
卷积输出 = SiLU( 前第3个token的qkv * conv_weight[:, 0] + 前第2个token的qkv * conv_weight[:, 1] + 前第1个token的qkv * conv_weight[:, 2] + 当前token的qkv * conv_weight[:, 3])所以普通 Decode 下,每个请求保留最近 conv_kernel−1 个卷积前的 qkv;卷积输出不写入 conv_state。缓存池 shape 为 [num_cache_slots, 3 × num_heads × head_dim, conv_kernel−1],请求通过缓存索引找到自己的槽位。
论文H3、Mamba引入了卷积:H3 用 shift SSM 混合最近几个 token,Mamba 把它定型为 causal conv1d(kernel=4)加 SiLU。Yang 等人 2024 年的 DeltaNet 把这一做法用到 delta rule 线性注意力上,并对 q、k 做 L2 norm(取代 Schlag 等人 2021 年使用的 sum normalization)。这组操作取代了 φ,之后的 GDN、KDA 都沿用了它。L2 norm 的作用见 DeltaNet 一节。
去掉了分母,且非线性映射 φ 被前置的卷积和 L2 Norm 取代,那么全局记忆状态的更新与读取,就自然简化成了纯粹的累加形式:
即 S← S+vk**T。这意味着,每个新来的 v**t 和 k**t 在完成当前的外积累加后就可以立刻丢弃,无需作为逐 token 的历史记录保留。后续读取依赖状态矩阵,而不需要随上下文增长的完整 KV Cache;前面的短卷积仍单独保留固定长度的、卷积前的 qkv 输入。
新 value 直接叠加在旧预测上。同一个 key 写两次,取出来的是两次 value 之和。没有任何遗忘机制,写错的、过期的信息会被毫无选择地塞进这个固定容量里,导致记忆很快饱和甚至数值爆炸。
DeltaNet:写门与残差写入
(基于 Linear Transformers Are Secretly Fast Weight Programmers, ICML 2021与Parallelizing Linear Transformers with the Delta Rule over Sequence Length, NeurIPS 2024)
Delta rule 形式的线性注意力由 Schlag 等人(2021)提出,但只能逐 token 串行训练。Yang 等人(2024)用 WY 表示把连乘的 I-βikiki**T 压缩成低秩形式,设计出 chunk 并行算法,使 DeltaNet 可以高效训练并扩展到大模型规模,同时确定了短卷积、SiLU 加 L2 norm 的现代架构。
线性注意力只会累加。DeltaNet 的思路是:写入前先用当前 key 查一下状态里已经存了什么,只把想存的和已经存的之间的差写进去。
S**t-1k**t 是用 k**t 从旧状态读出的值,表示旧的状态中已经存在的关于当前token的信息,v**t - S**t-1k**t 就是写入残差。DeltaNet 引入写门 βt = σ(·) ∈ (0,1)(每个 head 一个标量,由 hidden state 计算而来),按比例写入这个误差:
整理成右乘形式,更容易看出它对状态做了什么:
这里的核心在于转移矩阵 I - βtktkt**T。由于 k**t 做了 L2 norm,这个矩阵保证了旧状态在传递时只能缩小或保持原样,(即旧状态在当前 k**t 方向上按 (1-βt) 的比例平滑收缩,而在其他正交方向上原样保留),从而避免了传统线性注意力中因 Key 范数过大导致的状态爆炸。
DeltaNet 的局限在于:当前更新保留了与 k**t 正交的方向,但这些方向不一定对应单个特征通道。如果相关方向长期缺少更新,过期关联就可能持续保留,增加记忆干扰;它缺少独立于当前 key 覆写的主动遗忘机制。
GDN:增加遗忘门
(基于 Gated Delta Networks, 2024)
遗忘门并非 GDN 首创。RetNet, 2023 用每 head 一个固定衰减,Mamba2, 2024 用每 head 一个随输入变化的标量,GLA, 2023 则用每 key 通道一个随输入变化的衰减。GDN 的贡献是把 Mamba2 式的标量门和 delta rule 结合起来,并让 chunk 并行算法仍然成立;后文的 KDA 则是把 GLA 式的通道门和 delta rule 结合起来。
在 Delta Rule 写入之前,先让整张状态矩阵乘以一个标量遗忘门 αt∈(0,1)(每个 Head 一个标量,广播到所有行、列):
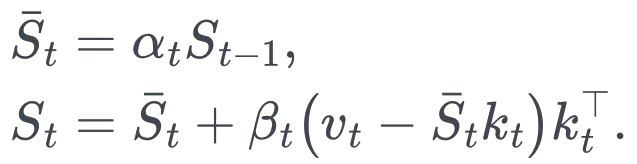
先整张状态矩阵(所有方向上的记忆)都无差别地按 αt 发生衰减,然后按照上一节的Delta Rule写入。
这里的问题是:同一个 Head 的所有特征通道只能共享同一个遗忘速度 αt。这意味着,无论对应的内容是否重要,每一步都会按同比例变小。说白了,遗忘门的表达能力有点弱,那是不是可以把 αt 换成 d**k 维向量呢?
KDA: By Channel的遗忘门
(由 Moonshot AI 在 Kimi Linear, 2025 中提出,GLM-5.3-Flash 也是用的KDA)
KDA 保留了残差覆写,但将遗忘门从标量升维成了 d**k 维向量。状态矩阵右乘对角阵 Diag(αt),意味着第 j 个通道拥有自己专属的遗忘速度 αt,j:
即遗忘门从GDN num_heads 扩充到KDA num_heads × head_dim。
聪明的你有没有想到:既然遗忘的维度可以从by Head 标量进化到by Head Channel,那有没有可能再进一步进化到S矩阵每个by Item的维度呢?即遗忘门进化到 S 矩阵的每一个元素(即 αt ∈ ℝd**v × d**k),做逐元素衰减 S̄t = S**t-1 ⊙ αt,那表达力岂不是拉满了?
说白了,不是不想上清华,是表达力与并行效率的取舍, 代数结构决定并行上限,硬件成本决定表达力边界。每个元素独立遗忘当然可以定义,但每个 head 每个 token 的门值数量会从 head_dim 增加到 head_dim_v × head_dim_k,带来更高的门生成和数据读写开销。更重要的是,按key通道遗忘时,所有 value 行共享同一个右乘转移,整个更新仍具有对角矩阵加秩一修正的结构,可以设计高效的分块并行算法。任意逐元素遗忘通常不再保留这种共享结构,不能直接沿用同样的算法优势。这里后续会详细讲到。
| 机制 | ① 衰减 | ② 写入 | 遗忘粒度 | 每 token 门的 Shape |
|---|---|---|---|---|
| 线性注意力 | S̄t = S**t-1 | S**t = S̄t + vtktT | 无 | 无门 |
| DeltaNet | S̄t = S**t-1 | S**t = S̄t + βt(v**t - S̄tkt)ktT | 无 | β [num_heads] |
| GLA | S̄t = S**t-1Diag(αt) | 同线性注意力 | 每 head 每 key 通道 | α [num_heads, head_dim] |
| GDN | S̄t = αtSt-1 | 同 DeltaNet | 每 head 一个 | β、α 各 [num_heads] |
| KDA | S̄t = S**t-1Diag(αt) | 同 DeltaNet | 每 head 每 key 通道,即 S 的每一列 | β [num_heads];α [num_heads, head_dim] |
旁注:RWKV 的路线 RWKV 不在这四档中间。RWKV-6 已经按通道衰减,但写入仍是 S← SDiag(w)+vk**T,同一个 key 上新旧 value 继续累加;GDN 相反,衰减是每个 head 一个标量,但沿 k 做残差覆写。KDA 把这两件事叠在一起:覆写来自 DeltaNet,按通道遗忘来自把 GDN 的标量 α 拆开。RWKV-7 也用了对角加秩一的转移,但抹除用的 key 可以和写入用的 key 不同,那是旁边的另一条演进线。
理解KDA:科学的假设
上一节把更新式收到了 KDA。下面以 GLM-5.3-Flash 使用的 KDA为例,展开状态如何维护、遗忘和覆写如何发生,以及训练和 Prefill 如何并行。
KDA中,每个请求的每一层、每一个Head 都会维护一个尺寸固定的矩阵——即全局记忆状态 S**t,专门用于存储当前请求的所有 Token 的上下文信息。
在每一层 KDA 进行前向计算时,模型会根据当前Token的Hidden State和对应权重,经过线性投影计算出用于提取信息的查询向量 q**t、作为寻址模式的 k**t、包含具体内容的 v**t,以及控制记忆更新的遗忘门 αt、写门 βt 和输出门 γt。然后进行如下运算:
其中:
- 遗忘门(Forget Gate) - S**t-1Diag(αt)
决定过去的隐藏状态 S**t-1 中,哪些信息应该被保留,哪些应该被遗忘。
- 写门 - βtvtkt**T
当前 Token 提供的新知识,准备写入到状态矩阵中
- Delta Rule Correction - -βtSt-1(αt⊙ k**t)ktT
要把经过衰减的历史状态中与当前 k**t 模式匹配的那部分旧内容给减掉,防止同一特征的重复写入,从而避免同一特征在长上下文中被重复累加而导致数值爆炸,赋予了状态矩阵精准覆写的能力。
RNN 范式的局限
如果KDA这条路走得通,上文所述的显存容量、内存带宽以及计算量随上下文线性增长的三个核心问题,也就解决了。
但是呢,众所周知RNN是有历史问题的,不然就没transformers什么事了。经典RNN的问题:
固定大小的状态,怎么记住越来越长的历史?
所有的历史被压缩到一个固定大小的矩阵中,必然会导致信息的有损压缩与丢失。随着上下文的变长,新 token 的信息会不断覆写、冲刷旧状态。这导致模型在处理长文本"needle in a haystack"任务,或需要精准回忆特定细节时,容易出现遗忘,精准召回能力降低。
门控和 Delta Rule 更新可以改善信息选择与写入方式,但不会让固定状态拥有无限容量。一种自然的折中是 Hybrid:让线性层承担低成本的历史聚合,让 Full/Sparse Attention 层保留更直接的历史访问通道。
PS:只要保留需要完整历史 KV 的全注意力层,这些层的 KV Cache 就仍随上下文长度线性增长;稀疏注意力减少的是访存量,KV仍全部保存。当然也有类似Sliding Window Attention、Compressed Sparse Attention、KVCache跨层共享,不过这些不在本文的讨论范围。
时间维上的递归依赖,导致无法并行计算从而充分利用算力。如何高效训练和 Prefill?
时序/因果并行
经典 RNN
经典 RNN 的更新为:
即使 x1,x2,x3 都已知,计算仍然是 h0→ h1→ h2→ h3:可以提前批量算好所有 Wxx**t,但计算 Whh2 必须先拿到 h2,不能只凭已知的 x3 直接得到。
把两步展开就更明显:
经典 RNN 将非线性嵌入了递归状态反馈链,使状态变换通常难以高效合并,因而难以沿时间维度并行展开。
transformers attention 并行
考虑某一层,全部输入表示 X 已由上一层算好:
Softmax 按行计算,M 为因果掩码:允许位置为 0,未来位置为 -∞。
因果注意力的位置 t 输出为:
注意右侧:有 q**t,k**j,v**j,没有 *ot*-1**。因此,计算 o3 不需要知道 o1,o2,各行可以同时开始。
这里同样存在非线性 softmax,却没有阻碍各行并行,因为它没有建立本层前一位置输出 → 本层后一位置输出的反馈链。标准 Transformer 的 FFN、归一化和残差也不引入这种沿位置的递归。
这就是与经典 RNN 的关键差别:
- RNN:
后一个位置读取本层前一个位置刚算出来的递归状态。
- Attention:
各个位置读取由当前层输入产生、已经准备好的投影。
因此,各个 Query 对应的注意力计算可以并行调度。Softmax 同样是非线性的,但它没有建立“本层前一个位置的输出到后一个位置输出”的递归链。
因果掩码限制的是允许读取哪些信息,不是必须按照什么位置顺序执行。实际 kernel 可以分块,不必显式保存完整 T× T 矩阵;它仍保留了这种位置间的并行机会。
Linear Attention Chunk-Wise
回到 KDA,令状态矩阵 S**t∈ℝd**v× d**k,k**t∈ℝd**k、v**t∈ℝd**v 为列向量,βt 为标量。我们将前面的 KDA 状态更新原公式拿过来:
在矩阵运算中,αt⊙ k**t 等价于 Diag(αt)k**t。我们将带有旧状态 S**t-1 的项合并,提取公因式:
这样一合并,我们得到了一个关键的表达式:
其中 T**t 是记忆状态的衰减与修正变换矩阵,H**t 是当前 Token 带来的原始增量矩阵(未扣除残差的纯新增量)。
这步转化非常关键:虽然 KDA 包含了复杂的非线性门控、遗忘和纠错,但只要我们在当前步把由 k**t, v**t, αt, βt 构成的系数固定下来,新状态 S**t 相对于旧状态 S**t-1 的更新关系,就是一个仿射变换。更重要的是,T**t 和 H**t 可以由当前层已知输入准备好,不需要等待前置的递归状态 S**t-1 算完。即:准备工作并行做,状态按块顺序传。
数学中严格来说,y = Ax 叫线性变换,而 y = Ax + b叫仿射变换。因为我们的公式是 S**t = S**t-1T**t + H**t(多加了一个 H**t),所以叫它仿射变换。
已知一个 chunk 包含 C 个 token,其块末状态可以写成:
这里 Transitionchunk 表示整个块的状态转移,Δchunk 表示不含传入状态影响的块内增量;单 token 的原始写入仍记为 H**t。由此,我们可以并行计算每个chunk的Transitionchunk和Δchunk ,最后按顺序计算各个块的合并结果。
下面讨论的 Chunkwise 实现统一取 C=64,按三阶段执行:
| 阶段 | 主要工作 | chunk 之间的依赖 |
|---|---|---|
| 1. 块内预计算 | 准备衰减系数,将块内残差依赖整理成下三角系统,计算与传入状态无关的辅助矩阵 (块内并行的逻辑后续解释) | 不同 chunk 可并行 |
| 2. 块间状态传递 | 用本块的传入状态修正残差,更新块末状态,并保存输出阶段需要的数据 | 同一请求内按 chunk 顺序递推 |
| 3. 块内输出 | 用已经准备好的块首状态和实际残差,计算各 token 的输出 | 不同 chunk 可并行 |
阶段 2 的并行度来自请求数、head 数和 V 轴分块;它保留了块间递推。阶段 1 和阶段 3 则能利用序列维度上的并行机会。这里的并行是2个维度的,块间和块内的:
- 宏观并行:状态更新是可组合的仿射变换:并行计算每个chunk的Transitionchunk,Δchunk
- 微观并行: 块内残差递推改写成下三角系统与矩阵运算
后文解释块内并行的逻辑,并推导这些辅助矩阵,并解释如何把大量块内运算转成矩阵乘法。
投影和门控可以包含非线性,关键不是整个模型是否线性,而是递归状态如何进入下一步更新,以及更新系数能否独立于该递归状态准备好。
Rope Nope
实际上,这里的并行是有代价的。RNN 的状态递推本身通常就对输入顺序敏感:交换两个 token 的位置,会改变它们经过的状态和后续计算。但 Attention 的单次内容聚合并不直接表达位置关系:固定一个 Query,将其可见范围内的 Key、Value 成对重排,不改变这次聚合的结果。
有意思的是,KDA之所以能够同时获得O(1)显存/计算复杂度和并行,竟然都是靠从非线性到线性,我理解这里是存在表达方式与计算效率的取舍的。
- 获得 Chunkwise 并行:经典 RNN 的非线性状态反馈 → 对旧状态的线性/仿射更新
- 获得单步 Decode 相对上下文长度的 O(1) 状态存储与计算: Softmax Attention 的非线性匹配 → 固定状态聚合与线性读取
这里需要说明的是:传统 RNN 因为非线性函数(如 tanh)的嵌套不可交换,天生保留了位置信息;但纯线性注意力(没有遗忘门)如果只做简单的状态累加(S**t=S**t-1+vtktT),由于矩阵加法满足交换律,输入 [A, B] 和 [B, A] 得到的最终状态将完全一致,导致天然的位置信息丢失。如何把丢失的信息找回来呢?遗忘门, KDA论文中也提到:遗忘本身也是一种相对位置编码,一个token距离当前越远,经历的衰减次数越多,它的信号就越弱。也就隐式的注入了距离信息。
Softmax Attention的Causal Mask解决的是能不能看的时间边界问题。位置 99 和位置 1 对位置 100 来说都属于允许访问的历史,掩码会对它们都放行,但不会通过掩码值进一步表达相距 1 与相距 99 的区别。当然,在多层Causal Mask通过不同位置的可见前缀,间接让 V(以及 K,Q)获得了隐式的位置信息。但是这种隐式位置信息是有问题的:
- 第一层是无序的,即Layer 1 的第 3 个位置无法区分 [A, B, C] 和 [B, A, C]。
- 位置信息和语义信息纠缠;
- 无法表示相对距离;
RoPE 是一种常用的显式位置建模机制,本质是用旋转的角度来代表 Token 的位置。以旋转前的列向量 q**t,k**j 表示内容投影,按位置分别旋转后:
使用标准 RoPE 时,上面注意力公式中的 QK**T 就替换为旋转后的 Q̃K̃T。相对位置 j-t 因而直接进入 Query–Key 打分;这让模型可以学习位置关系,但不保证距离越近,分数就越高。
相对于不使用显式位置编码的 RNN,采用 RoPE 的 Attention 增加了位置表示的计算与工程成本:
- 额外旋转运算。
- 位置与旋转系数管理。
- 长上下文适配。当使用范围超过训练时的位置范围,旋转频率、位置缩放等设置可能影响效果,需要相应的训练和验证,不能只扩大位置编号就假定能力自动延伸。
多层因果 Attention 可以通过不同位置的可见前缀,间接形成顺序线索,RoPE则显式的把相对位置直接纳入注意力计算,即将相对位置引入 Query–Key 打分;而 KDA 将顺序的影响体现在状态演化中,即便Chunkwise 并行执行,这种顺序关系也不会消失。因此,是否使用 RoPE,取决于整个架构已有的顺序建模机制,以及额外位置表示的实际收益与成本。下表对比几款模型的选择:
| 模型 | 模型结构 | 位置编码 |
|---|---|---|
| Kimi K3 | 93 层 = 69 KDA + 24 MLA。基本按每 4 层 3 KDA + 1 MLA 排列,末尾第 92、93 层都是 MLA。 | NoPE |
| GLM-5.3 | 78 层全 DSA(MLA + indexer)。indexer 为 21 层 full + 57 层 shared | RoPE |
| GLM-5.3-Flash | 45 层 = 34 KDA + 11 DSA。每 4 层 3 KDA + 1 DSA,共 11 组,末尾再加 1 层 KDA | NoPE |
| Qwen3.8-Flash-Next | 48 层 = 36 GDN + 12 QSA。每 4 层 3 GDN + 1 QSA | RoPE |
| Qwen3.8-Max | 92 层 = 69 GDN + 23 Gated Attention。每 4 层 3 GDN + 1 Gated Attention,共 23 组 | RoPE |
从训练的角度理解演进
Linear Transformers Are Secretly Fast Weight Programmers 从 fast-weight associative memory 的视角解释线性注意力:状态矩阵 S**t 不仅是随序列递推的隐藏状态,也可以看成一组在上下文处理中不断更新的快权重,用来存储从 key 到 value 的临时关联。Kimi Linear 延续这一视角,并进一步用在线学习、重建损失和快权重衰减统一解释 DeltaNet、Gated DeltaNet 与 KDA。 From the fast-weight perspective, S**t serves as an associative memory storing transient mappings from keys to values. - 来自KDA章节:Linear Attention as Online Learning
Memory As a Model
最基本的线性注意力通过外积将当前 key-value 关联写入状态,并使用 query 读取状态:
与推理时通常保持不变的投影参数不同,S**t 会随 token 到来而不断变化;但它又像普通线性层的权重矩阵一样,通过矩阵乘法作用于输入。因此,从 fast-weight perspective 看,S**t 是一组随上下文快速更新的权重,也是一块动态的关联记忆。
在初始状态 S0=0 时,将状态递推展开:
若 S0≠0,右侧还需加上 S0,下面的读取式也相应多出 S0q。
用任意 query q 读取时:
其中,kiT**q 衡量 query 与历史 key 的匹配程度,并决定对应的 value 被取出多少。因此,外积 vikiT 可以看成向状态中写入一条 key-value 关联,而 Stq 则按照 key 匹配程度聚合历史 value。
既然 S 可以接受 query,自然也可以把一个 key 代入其中:
它表示当前关联记忆根据 k 召回的 value。于是,在写入当前关联 (k**t,v**t) 之前,可以把
解释为旧记忆对当前 value 的重建或预测。
损失函数
普通线性注意力无论当前关联是否已经存在,都会把 vtktT 继续累加到状态中:
先把状态在第 t 步的变化记为
普通线性注意力的外积更新意味着
根据梯度下降公式:
其中:
Δ θ:参数变化量(有时也用 Δ w 表示权重 weight 的变化)。
θ(Theta)或 w(Weight):代表模型中的参数。
η(Eta)或 α(Alpha):代表学习率(Learning Rate),控制步长。
∇ L(θ) 或 ∂ L∂ θ:代表损失函数的梯度。
为了和普通线性注意力的更新对应起来,先取学习率 η=1。这样,我们需要的梯度就是:
那对应的损失函数应该是:
前面已经说过,Sk**t 是记忆根据当前 key 召回的 value,而 v**t 是我们希望记住的目标 value。因此,vtTSkt 是目标 value 与召回 value 的内积。最小化它的负值,就是鼓励这个内积变大。但是实际上呢,我们的诉求是让召回的 value 接近目标 value,也就是让重建误差趋近于 0,而不是让上面的 Loss 一路降到 -∞。所以,有没有可能搞一个这样的损失函数呢?
重建损失函数
DeltaNet 将它改写为一个重建问题:把 S 看成从 key 预测 value 的线性模型,要求 Sk**t 尽可能接近 v**t。当前样本的回归损失为:
根据链式法则:
以 βt 为学习率,对当前样本做一步梯度下降,便得到 Delta Rule:
这说明,Delta Rule 不再把 v**t 原样累加进记忆,而是先检查旧记忆已经能够预测出什么,再写入尚未记对的部分。如果 S**t-1k**t=v**t,预测残差为零,就不需要重复写入。
将更新式右乘当前 key,可以更直接地看到这种纠错作用:
当 key 已归一化,即 ‖k**t‖2=1 时:
也就是说,更新后的预测会从旧预测向目标 v**t 移动。此时,0<βt<1 表示部分修正,βt=1 才表示在当前 key 上精确覆写。
需要注意,这并不是字典中互不干扰的独立槽位。对另一个 key k',本次更新造成的变化为:
因此,与 k**t 相似的 key 也会受到影响;只有与 k**t 正交的方向不会受到这次更新的直接影响。
从重建误差到正则化
前面,我们把关联记忆 S 看作一个在线训练的线性模型:每来一个样本 (k**t,v**t),就根据重建损失更新一次:
但重建损失只关心一件事:当前样本预测得准不准。
从训练的角度看,一个自然的扩展是:除了拟合当前样本,还对模型权重施加正则化约束,对较大的权重施加惩罚。在损失函数中加入 L2 正则项:L**reg = L + λ2 ‖θ‖2,其关于参数 θ 的梯度就是 ∇ L + λ θ。代入 SGD 的更新公式:
g**t=∇ L(θt) 表示当前数据损失的梯度。只有在 0<ηλ<1 时,1-ηλ 才是介于 0 和 1 之间的衰减因子;ηλ=0 表示不衰减,ηλ=1 表示将旧权重的直接项清零。不能仅凭加入了 L2 正则,就断言任意步长都会产生这种衰减。
据此,对重建损失直接加上 L2 正则项:
以 βt 为学习率,在旧状态 S**t-1 上做一步普通 SGD,得到:
令 αt=1-βtλt(若要对应 0<αt<1 的遗忘门,需满足 0<βtλt<1),则:
看见没,1-ηλ 和 GDN 的遗忘门,在“缩小旧权重”这件事上具有相同的形式。把关联记忆 S 看作快权重,遗忘就可以理解为对快权重施加衰减。
但 GDN 还多了一处需要注意的设计:它先衰减旧记忆,再用衰减后的记忆计算重建误差,最后根据误差进行纠正:
因而,GDN 可以理解为“先做快权重衰减,再做一步重建学习”。αt 控制旧记忆保留多少,βt 控制当前关联纠正多少。二者承担不同的角色,通常由模型根据输入生成,而不是必须满足某个固定的 αt=1-βtλ 关系。
KDA具体实现
对 KDA 而言,Decode 与训练、Prefill 可以采用不同的执行计划:
- Decode:
每次只来一个新 token,直接更新一次状态并读取输出,利用固定状态控制单步成本。
- 训练和 Prefill:
整段输入已知,可以提前准备更新系数,通过扫描或 Chunkwise 重排计算,提高吞吐。
在 vLLM v0.32.0 中,GLM-5.3-Flash 的 KDA 层按平台和 additional_config.kda_prefill_backend(auto / triton / flashkda,默认 auto)选择 prefill 后端:
| 平台 / 配置 | Prefill | Decode 与推测验证 | 内部 prefill checkpoint |
|---|---|---|---|
CUDA SM90/SM10x/SM12x,bf16,head_dim=128,有界 gate,auto 或 flashkda | FlashKDA(torch.ops._flashkda_C.fwd,L2 Norm、门控、β 的 sigmoid 均在 kernel 内融合) | Triton fused_recurrent_kda | 支持:num_prefill_checkpoint_blocks=1,prefill_checkpoint_alignment=16 |
kda_prefill_backend=triton | Triton chunk_kda_with_fused_gate | Triton fused_recurrent_kda | 不支持 |
| ROCm | AMD 版 chunk_kda_with_fused_gate | AMD 版 fused_recurrent_kda | 不支持 |
每个请求的每个 KDA 层,都为各个 head 维护独立状态。下面以本文 GLM-5.3-Flash 的 q/k/v 等头数、等维度配置为例,展示全部 heads 合起来的逻辑形状。推测解码采用后文介绍的逐 token 状态快照路径:
| 状态 | 单份 Shape | 开启推测时的逻辑使用方式 |
|---|---|---|
conv_state | [3 × num_heads × head_dim, conv_kernel − 1 + num_spec] | 使用一条扩展窗口,根据接受长度选择其中的历史片段 |
S(recurrent_state) | [num_heads, head_dim, head_dim] | 保存 1 + num_spec 个验证位置对应的状态快照 |
Prefix Cache
然而理想很丰满,现实很残酷。如果每个请求只保存一份S(recurrent_state),那Prefix Cache就没法做了,扔掉KVCache的成本是巨大的。(因此vLLM是默认开启了Prefix Cache的)
如果仍然每个block_size保存一份,那Linear Attention节省缓存的效果可就大打折扣了~(显存容量不再是O(1), 显存带宽、计算量还是O(1)),这个如何是好?我们看看vLLM是怎么做的。
首先vLLM中Prefix Cache是以Block为单位的(默认block size 16),利用当前块内的Token序列以及前置块的哈希值,计算出一个唯一的 Hash Key。这种较粗的匹配粒度,经常被拿来与SGLang基于Token级别的 Radix Tree进行对比,虽然实际上几乎没什么影响。(关于prefix cache的基础知识可以参考vLLM官方文档Automatic Prefix Caching)
然后当前用到Linear Attention的开源模型基本都是Hybrid,这里要怎么设计呢?
KV Cache是如何管理的
vLLM 首先需要知道每一层的缓存长什么样,这由 KVCacheSpec 描述。同类型的层通常会产生相同的 spec。
但是呢,如果每层根据KVCacheSpec独立管理block table,即便KV cache显存在启动时已经预分配,请求运行时仍需为每层分别维护和分配Block ID,增加调度元数据与管理开销。那怎么办呢?
可以考虑相同的KVCacheSpec层放在一起管理,这便有了KVCache Group,一个KVCache Group对应一个block table,但是由于所有的Group共用一个BlockPool,这里的分配也要考虑不同Block的page size尽可能一致,这样可以有效的减少显存碎片。因此即便KVCacheSpec一致,也可能被分成不同的KVCache Group。
这里还有另外一种场景,比如MLA和Indexer生命周期一致,Spec类也都是MLAAttentionSpec,但是head_size不一致,单层的page size也就不同。按 bf16、block_size=64 算,MLA 每 token 1152B,一页72KB;Indexer每 token132 B,一页8.25KB。
怎么办呢?如果按上面的方式分成两个 Group,就要求两者的单层 page 相等。2个办法:
- 把Indexer padding到跟MLA的page size一致,这样会造成非常大的浪费;
- 调整Indexer的block size让其page size尽可能与MLA的page size差不多大,但是这样生命周期又不一致了。
怎么办呢?vLLM引入了一种特殊的KVCache Spec - UniformTypeKVCacheSpecs, 合并条件:block_size 相同,且在注册表里属于同一个 uniform 基类。
KVCacheGroupSpec( layer_names=["model.layers.0.self_attn.attn", # MLA"model.layers.0.self_attn.indexer.k_cache", # Indexer"model.layers.1.self_attn.attn","model.layers.1.self_attn.indexer.k_cache", ... # 共 61 × 2 = 122 层 ], kv_cache_spec=UniformTypeKVCacheSpecs( block_size=64, kv_cache_specs={"model.layers.0.self_attn.attn": mla_spec, # 72 KiB"model.layers.0.self_attn.indexer.k_cache": idx_spec, # 8.25 KiB ... }, ),)mla_spec = MLAAttentionSpec(block_size=64, num_kv_heads=1, head_size=576, # kv_lora_rank 512 + rope 64 dtype=torch.bfloat16)# 单层 page = 64 × 576 × 2B = 73,728 B = 72 KiBidx_spec = MLAAttentionSpec(block_size=64, num_kv_heads=1, head_size=132, # 128 fp8 + 128/128 × 4B scale dtype=torch.uint8)# 单层 page = 64 × 132 × 1B = 8,448 B = 8.25 KiB合并之后,这些层共用一张 block table,Group 的 page_size_bytes 是组内各层 page size 之和:
@propertydefpage_size_bytes(self) -> int:returnsum(spec.page_size_bytes for spec inself.kv_cache_specs.values())也就是说,vLLM 的 CacheEngine 在向 GPU 显存池申请内存时,分配一个 block ID,直接包含了 61 个 MLA 页和 61 个 Indexer 页的存储位置,合计 61 × (72 + 8.25) KiB = 4,895.25 KiB ≈ 4.78 MiB。
Linear Attention的Prefix Cache
讲完了 Group,再回到线性注意力。KDA、Mamba 这类层每层每个请求只有一份固定大小的 state,不随 token 数增长。要放进这套 Block 机制,即满足不同group page size一致的诉求,就需要让一份 state 的字节数等于attention 一个 block 的单层 page size。
这里解释下为什么让一份 state 的字节数等于attention 一个 block 的单层 page size? 以Qwen3.8-27B为例,它有一个 16 层 Full Attention KVCache Group,以及三个各 16 层的 GDN KVCache Group:
- Attention KVCache Group每个Block:16 × Attention 单层页大小
- GDN KVCache Group每个Block: 16 × GDN 单层存储页大小 所以最终保证:Attention 单层页大小 = GDN 单层存储页大小就好了。
这里到了GLM-5.3-Flash就有点复杂了,因为它涉及到上面提到的UniformTypeKVCacheSpecs。它的 KV Cache Group 划分如下(Group 由通用的 _get_packed_kv_cache_groups 生成):
[# Group 0:MLA + Indexer,合成一个 UniformTypeKVCacheSpecs 11层MLA+Indexer KVCacheGroupSpec( layer_names=[mla.*, indexer.k_cache.*], kv_cache_spec=UniformTypeKVCacheSpecs(block_size=640, kv_cache_specs={ mla.i: MLAAttentionSpec(head_size=512, dtype=bf16), # 640 KiB indexer.i: MLAAttentionSpec(head_size=132, dtype=uint8, tokens_per_state=4), # 20.6 KiB }), ),# Group 1:Indexer 的 kpool tail 环形缓冲,每个请求固定 1 个 block,不参与 prefix caching KVCacheGroupSpec(layer_names=[tail.*], kv_cache_spec=UniformTypeKVCacheSpecs( kv_cache_specs={tail.i: CircularBufferSpec(block_size=ring)})), # 无 MTP 时 ring=4,2 KiB# Group 2..:KDA 层,按一个 block 能装下的 state 数切成4组Group,[9,9,8,8] KVCacheGroupSpec(layer_names=[kda.0, kda.3, ...], kv_cache_spec=UniformTypeKVCacheSpecs(kv_cache_specs={ kda.i: MambaSpec(page_size_padded=MLA 单层 page)})), ...]KDA 的分组数来自打包规则:一个 block 要装下 11 层 MLA + 11 层 Indexer,共 11 × 640 + 11 × 20.625 = 7,266.875 KiB,能容纳 ⌊7266.875 / 640⌋ = 11 份 KDA state,所以 34 层 KDA 切成 cdiv(34, 11) = 4 组,每组轮流取层,得到 [9, 9, 8, 8]。
所以,其实最终是就得让一份 state占用的字节数等于一层MLA KV Block所占用的字节数。做法是把 attention 的 block_size 放大,同时把 state padding到相同字节数。
- GLM5.3 Flash MLA注意力层,每token占用字节数(单层):
attn_page_size_1_token = num_heads × (head_size + head_size_v) × dtype 字节数 = 1 × 512 × 2 = 1024 Bnum_heads = 1
MLA 在 decode 时等价于 MQA,KV 只有一个 head,不随 TP 切分。
head_size = kv_lora_rank + qk_rope_head_dim = 512 + 0 = 512
GLM-5.3-Flash 的 MLA 是 NoPE 设计(mla_use_nope = true),没有 RoPE 部分。
head_size_v = 0
MLA 只缓存一份 latent 向量,没有单独的 V。
- dtype 是 bf16,2 字节。
GQA的公式则为: num_heads × (head_dim + head_dim_v)× dtype 字节数 DeepSeek V3或Hy4Preview带64维RoPE,
head_size = kv_lora_rank + qk_rope_head_dim = 576,每token是1152B。
- KDA 层一份 state 的字节数(单层、单请求、单卡、TP=1、num_spec=0)
| 状态 | Shape | dtype | 字节数 |
|---|---|---|---|
conv_state | [3 × num_heads × head_dim, conv_kernel − 1 + num_spec] = [3072, 3] | bf16 | 18,432 |
recurrent_state | [num_heads, head_dim, head_dim] = [8, 128, 128] | fp32 | 524,288 |
合计 mamba_page_size | 542,720 |
- 求 block_size(
_align_hybrid_block_size)
attn_block_size = kernel_block_alignment_size * cdiv( mamba_page_size, kernel_block_alignment_size * attn_page_size_1_token,)if cache_config.block_size < attn_block_size: cache_config.block_size = attn_block_size logger.info("Setting attention block size to %d tokens ""to ensure that attention page size is >= mamba page size.", attn_block_size, )block_size = kernel_block_alignment_size × cdiv(mamba_page_size, kernel_block_alignment_size × attn_page_size_1_token) = 128 × cdiv(542720, 128 × 1024) = 128 × 5 = 640- kernel_block_alignment_size 取后端支持的最小 kernel block 与用户配置 block_size 中的较大者;对 MLA 混合模型,再与 128 取最大值,本例即 128。原因是 TRTLLM/FlashInfer 的 MLA decode kernel 要求物理kernel block 数按 128 / kernel_block_size 对齐,因此把 manager 的 block size 设为 128 的倍数,切成 kernel block 后仍满足这一约束。
- 之后还要按所有非 SSM 后端最小 kernel block 的最小公倍数(backend_block_alignment)再向上取整一次。本例中 Indexer 要求 index_kpool × 32 = 128,640 已经是 128 的倍数,结果不变。
- 对齐 page size
- MLA 每个 Block 的字节数:
640 × 1024 = 655,360 B。 - KDA 的 state 补齐到同样大小:
mamba_page_size_padded = 655,360 B,大约多出 20.7% 的填充。
| 计算 | 结果 | |
|---|---|---|
| MLA 每 token | 1 × (512 + 0) × 2B(NoPE,没有 RoPE 部分) | 1024 B |
| KDA 一份 state | conv_state [3072, 3] bf16 + recurrent_state [8, 128, 128] fp32 | 542,720 B |
| block_size | 128 × cdiv(542720, 128 × 1024) | 640 |
| MLA 单层 page | 640 × 1024 | 655,360 B |
| KDA padding 后 | mamba_page_size_padded = 655,360 B | 多出约 20.7% |
这也是 hybrid 模型启动时 block_size 经常被调到几百甚至上千的原因。TP 越小,每卡的 state 越大,block_size 也越大。
| Group | 对应的 Spec 类 | block_table shape |
|---|---|---|
| Group 0 (MLA + Indexer) | UniformTypeKVCacheSpecs (MLAAttentionSpec) | [max_num_reqs, cdiv(max_model_len, block_size)] |
| Group 1 (Tail Group) | UniformTypeKVCacheSpecs (CircularBufferSpec) | [max_num_reqs, 1] |
Group 2mamba_cache_mode="align") | UniformTypeKVCacheSpecs (MambaSpec) | [max_num_reqs, cdiv(max_model_len, block_size) + num_speculative_blocks] |
Group 2mamba_cache_mode="none") | UniformTypeKVCacheSpecs (MambaSpec) | [max_num_reqs, 1 + num_speculative_blocks] |
分好 Group 之后,还要决定这些 Group 在物理显存里怎么摆。v0.31.0 及以前,GLM-5.3-Flash 没有复用通用的 Block-outermost 布局,而是专门定制了一套 Layer-outermost 布局;v0.32.0(#57169)删掉了这套定制逻辑,改用通用的 BLHNC(Block-outermost)打包布局(kpool tail 的 KpoolTailBackend 只声明支持 BLHNC)。先看旧布局:
之所以当初要定制,根本原因在于稀疏注意力层中Indexer和MLA Kernel各自有着严格的固定步长寻址约束:
- 第一个 Kernel(DeepGEMM
paged_mqa_logits,负责读Indexer Cache打分): vLLM的KVCacheManager分配的1 个block包含 640个Token,经 4 合 1 压缩后在Indexer Cache中对应 160 个 Pool State(160 × 132 B = 20.625 KiB)。但 DeepGEMM 的paged_mqa_logitskernel只接受每页 32 或 64 个 State(SM120 上只有 64),所以实际按32个 State(对应 128 个 Token,占32 × 132 B = 4.125 KiB)一页加载。 因此,Indexer 无法直接使用 vLLM 全局那张 640-token 粒度的block_table,而是必须将每个20.625 KiB的大块切分为5 个4.125 KiB的小页(kernel_block),并派生出一张列宽翻 5 倍、128-token(32-state)粒度的专属细粒度页表kernel_block_table传给paged_mqa_logits。算子在内部循环中从kernel_block_table取出整数小页号k,按indexer_ptr + k * 4.125 KiB寻址。 - 第二个 Kernel(Sparse MLA,负责根据 Top-K 读
MLA Cache算 Attention):
在拿到第一个 Kernel 筛出的 2048 个离散 Token 索引后,Sparse MLA 核函数将整个MLA Cache视为一张平铺的二维 Token 行表(每行代表 1 个 Token 的完整 KV,占 512 × 2 B = 1 KiB),通过 block_table 将逻辑 Token 位置重映射为全局整数行号r,在算子内部按 mla_ptr + r * 1 KiB 寻址。
在 Layer-outermost 下,由于同一层的各个大块在物理显存中紧挨着存放,相邻大块的间距就是该层自身的单块大小(Indexer 为 20.625 KiB = 5 × 4.125 KiB,MLA 为 640 KiB = 640 × 1 KiB),天然就是这两个 Kernel 寻址步长的整数倍(block_table中的大块 [0, 1] 只需简单乘以 5 就能展开为 kernel_block_table 中的 [0, 1, 2, 3, 4, 5, 6, 7, 8, 9]),从而天然屏蔽了跨块步长对齐问题。但代价是:Layer-outermost 要求同一 Group 内的所有层必须拥有完全相同的page_size步长,导致不得不为 GLM-5.3-Flash专门定制了一套 Layer-outermost 布局。
从长期维护与架构统一的角度出发,肯定是希望删掉这套定制逻辑,将 GLM-5.3-Flash 收敛到通用的 Block-outermost(块内紧凑打包)路径上。而在 Block-outermost 下,同层相邻两个大块之间夹杂着其他所有 21 层的数据,跨块间距统一变成了整块总大小bytes_per_block(原始有效数据之和为 7,266.875 KiB),原有的天然整除被打破。
因此,切到Block-outermost 就必须同时满足上述两个独立 Kernel 的步长整除约束:每个 spec 通过 block_stride_alignment 声明自己要求的块间步长:Indexer为一个 kernel block的 4.125 KiB,Sparse MLA 为一行1 KiB,_get_kv_cache_bytes_per_block 再把整块总大小 bytes_per_block向上对齐到 LCM(4.125KiB, 1KiB) = 33KiB的整数倍(即 7293 KiB),使相邻大块间距同时成为 DeepGEMM 小页(4.125 KiB)的 1768 倍与 MLA Token 行(1 KiB)的 7293 倍。在此基础上,Worker 侧的AttentionGroup只需在构建 Metadata 时,将block_table中的每一个大块号b按跨步公式 1768 * b + [0, 1, 2, 3, 4]展开写入私有的 5 倍宽 kernel_block_table(例如大块 [0, 1] 展开为 [0, 1, 2, 3, 4, 1768, 1769, 1770, 1771, 1772]),而 Sparse MLA 则按 7293 * b + off 重映射行号,即可在不改动任何一行底层 CUDA Kernel 代码的前提下,完美实现跨层跳步寻址。Block-outermost的布局如下:
同构模型所有层的单页page size相同,采用 Layer-outermost 即可使同层各块物理连续、单层步长天然对齐;而 Hybrid 模型包含多种单页字节数不同的异构缓存层(如 640 KiB 的 MLA、20.625 KiB 的 Indexer、2 KiB 的 Tail),采用 Block-outermost 将同一 block_id 下不同大小的层在块内按真实字节数紧凑拼接,并统一对齐块级总步长(bytes_per_block),既能用同一套分块规划逻辑兼容任意异构层组合,又能保证单个 block_id 对应一段物理连续的内存,从而满足按块分配与按块 RDMA 传输的需求。(虽然 KDA 与 MLA 之间由于 _align_hybrid_block_size 仍保持了单层 640 KiB 对齐,但 MLA(640 KiB)、Indexer(20.625 KiB)与 Tail(2 KiB)之间已无需单层大小相等)
S 到底存几份?
所以:S 到底要存几份?每 block_size 个 token 都保存一份 S 吗?vLLM 早期确实提供过这种 mamba_cache_mode="all" 模式,v0.32.0 彻底移除,MambaCacheMode 只剩 "align" 和 "none"。要知道,缓存块本身是受 LRU 管理的,随时可以淘汰,所以 "all" 模式真正致命的并不是长期占用显存,而是无效的显存写入与算力浪费——它要求算子在一次 forward 中强行导出并向 HBM 写入沿途每一个 block_size 边界的中间状态,既拖慢了 kernel 执行,又把大量带宽浪费在了根本没人复用的中间状态上。
当前开启 Prefix Cache 后,hybrid 模型默认使用 mamba_cache_mode="align"。规则是:只保存每个 scheduler step 最后一个 token 的 S,且仅当该 token 位于 i * block_size 位置时,才将该 block 注册进前缀缓存。
调度侧:Scheduler._mamba_block_aligned_split 负责对齐每个 step 的结束位置与 block_size(640):
- 单步 token 预算充足时,在 last_cache_position 处截断:对于 2000 token 的 prompt,如果单步预算够大,既不能一口气跑完 [0, 2000)(否则唯一写出的状态落在 2000,连 1920 处的满块状态都没留存下来),也不会按 640 -> 1280 -> 1920 -> 2000 切碎成 4 个 step;而是只在最后一个可缓存的整块边界 last_cache_position = 1920(3 × 640)处截一刀:第 1 步直接运行 [0, 1920),第 2 步运行剩余的 [1920, 2000)。第 1 步跨过的 640、1280 两个位置不分配物理 block,在 block table 中直接填 null_block。(若算子支持 num_prefill_checkpoint_blocks > 0 内部导出,则无需在 1920 处截断 step,可一步跑完 [0, 2000) 并由算子在内部将 1920 处的 S 写入预留 block。)
- 单步 token 预算受限时,中间 chunk 向下取整到
i * 640(aligned_end)
如果当前 step 预算不足以算完整个 prompt,就把 chunk 长度截断为 640 的整数倍;如果剩余预算不足 1 个 640,本步返回 0 暂不调度该请求,避免写出非块边界的中间状态。
显存侧:按单个 KDA 层计算,align mode 状态块切换期间,每个运行中的请求会暂时同时引用 2 + num_speculative_blocks 个状态块,分别用于旧状态、新状态和推测解码。这里统计的是Scheduler 中该请求的 req_to_blocks 列表里的非null_block条目数,也就是本请求仍然引用的状态块数,不包括已经释放本请求引用、但仍保留在缓存池中的历史 S 快照:
- 在同一个 640 块内推进时,通常直接在当前物理 block 上更新 S,不需要为每一步分配新 block。
- 切换到下一个状态块时,
MambaManager分配新的物理 block;Worker 在 forward 前通过preprocess_mamba将旧 S 拷贝到新 block,再在新 block 上继续计算,避免覆盖旧块中可复用的快照。在交接完成、安全释放旧块之前,当前请求会同时持有旧块和新块的引用。 - 更早、不再被当前请求需要的 block,由
MambaManager.remove_skipped_blocks从 Scheduler 维护的请求 block 列表中移除,并以null_block占位,同时将对应物理 block 的ref_cnt减 1。只有没有其他引用时,ref_cnt才会归零。 已注册hash的块ref_cnt归零后仍可带着S和hash留在BlockPool的空闲队列中,供其他请求命中,也可按缓存淘汰策略被重新分配并覆盖。
请求 2000 token 的 prefill(block_size = 640,示意):情况 A:单步预算充足(在 last_cache_position = 1920 处截断,2 步跑完)step 1 [0, 1920) KDA block table: [null, null, B2] 640/1280 跨过不存,B2 存 S@1920step 2 [1920, 2000) KDA block table: [null, null, B2, B3] B2 留在池中可命中,B3 存 S@2000情况 A':单步预算充足,且后端支持内部 checkpoint(v0.32.0 GLM-5.3-Flash 默认的 FlashKDA)step 1 [0, 2000) KDA block table: [null, null, B2, B3] kernel 内部把 S@1920 导出到 B2,B3 存 S@2000情况 B:单步预算受限(例如每步最多算 1 个 block,4 步跑完)step 1 [0, 640) KDA block table: [B0] B0 存 S@640step 2 [640, 1280) KDA block table: [B0, B1] B1 存 S@1280step 3 [1280, 1920) KDA block table: [null, B1, B2] B0 摘除回池(带 hash),B2 存 S@1920step 4 [1920, 2000) KDA block table: [null, null, B2, B3] B1 摘除回池(带 hash),B3 存 S@2000命中侧:MambaManager.find_longest_cache_hit从右往左查找,只取最后一个命中的 block,前面全部用 null_block 占位。因为线性注意力只需要断点处的那一份 S,前缀上的历史 S 没有用。Full Attention 层则正常从左往右匹配。两边命中长度不一致时,HybridKVCacheCoordinator 会循环取最小值,直到所有 Group 收敛到同一个命中长度。
所以这里其实这里可以看到,在开启Prefix Cache align mode下,确实可以只保留 2 + num_speculative_blocks(导出内部 checkpoint 的那一步再加 1)。其他的block释放回到BlockPool, 仍可能被命中,当然也可能因为显存不足而被驱逐。区别于full attention,请求未结束时,必须要确保所有的kv不被释放,即ref_count>0。
PS:为了减少"为了保存可缓存的 S 而额外拆出来的分段"。比如,上面的例子:
- 不支持内部 checkpoint
[0, 1920)、[1920, 2000),需要 2 次 forward。
- 支持且满足内部导出条件:
[0, 2000),只需 1 次 forward,同时保存S@1920和S@2000。
不过,仔细想想这套大 block_size(640)+ 只在 last_cache_position(1920)存一份 S的解决方案其实不够完美。放到真实的在线业务中会遇到两个典型场景的痛点:
- 长 System Prompt + 不同用户问题(共享前缀在中间分叉):在单步预算充足的常态下,调度器只在整个 Prompt 的尾部附近last_cache_position(1920)截断并保存
S,中间跨过的 640、1280 全是null_block。如果多个请求共享前 1300 token 的 System Prompt、后面接各自不同的用户问题,第一个请求在 1920 存下的S已经混入了它自己的用户问题,而中间 1280 处又是null_block,后来的请求连一个整块都命中不了。 - Agent 多轮对话 / 相同请求重试(
block_size = 640匹配粒度太粗)
即便在尾部续写或重试的场景下,由于 block_size 从 16 膨胀到了 640,匹配粒度粗了 10 倍以上。任何不足 640 个 token 的短前缀、或者整块之后的尾部余数(如 2000 token 中的 1920 ~ 2000),都无法被缓存复用,必须重新做 Prefill 计算。
下面我们看看 vLLM 是如何依次解决这两个问题的。
共享前缀分叉点(Marconi-style APC)
先看第一个问题:对于“一段很长的 System Prompt 后面拼接各自不同的用户问题”的场景,共享前缀在 Prompt 中间就结束了;第一个请求登记的尾部缓存点(1920)落在后面不共享的用户问题上,后来的请求命中不了。这就尴尬了——难道为了这个诉求,又要回退到每 block_size 个 token 都保存一份 S 么~
按照前面的例子:第一个请求到来时,系统确实不知道前面哪一段是公共的 System Prompt;但别忘了,Mamba 虽然只保存了 1920 处的 block、跳过了中间的 640 和 1280(填了 null_block),Full Attention 却把 640、1280、1920 三个满块的 KV 和 hash 全都登记进缓存池了。
那完全可以利用Full Attention中的命中长度作为下一次的缓存边界,vLLM 借鉴了 Marconi 的思路:第一个请求不去猜,等第二个请求到来时,直接从 Full Attention 的命中结果里反推出公共前缀的分叉点,让第二个请求在计算时顺路把分叉点处的 S 存下来,供第三个及以后的请求直接复用。具体实现分为三步:
- 第二个请求到达时,探测:
KVCacheManager.get_computed_blocks里,如果 full attention 命中的长度比 Mamba 长(多出的部分记为num_uncached),就取最长的单组命中作为分叉点,记到Request.shared_prefix_boundary:
shared_prefix_boundary = num_new_computed_tokens + num_uncached其中 num_new_computed_tokens 是所有 Group 对齐后的共同命中长度(此时被 Mamba 拖住,比如为0)。由于 Full Attention 在中间只按满块登记了 hash,中间分叉点天然落在 block_size(640)的整数倍边界上(若分叉恰好命中前序请求的尾部,则对齐到 hash_block_size)。
- 第二个请求调度时,截断:轮到第二个请求执行时,
Scheduler._mamba_block_aligned_split会把shared_prefix_boundary加入强制停点列表stops(默认对齐到block_size,开启--enable-mamba-shared-prefix-checkpoint时支持停在块内细粒度分叉点),让当前 step 的 chunk 刚好在分叉点(junction)处结束,kernel 跑完自然就产出了该位置的S。 - 保留:
cache_blocks在登记缓存时会将该分叉点加入reachable_boundaries(以及_cache_partial_tail_block的放行条件),确保即使开启了稀疏保留策略(retention_interval),这份特意在分叉点存下的S 也不会被当作普通中间状态跳过或丢弃。
用前面的数字代入(block_size = 640,未设置 --prefix-match-unit):
请求 A:2000 token,一个 chunk 0 → 1920,再 1920 → 2000(FlashKDA 内部 checkpoint 时一步跑完)。只有 1920 处有 S。请求 B:和 A 共享前 1300 token。 full attention 命中 1280,Mamba 命中 0(640、1280 处没有 S) → 整体命中 0,B 从头计算 → shared_prefix_boundary = 0 + 1280 = 1280 → B 的 prefill 截成 0 → 1280、1280 → ...,1280 处的 S 被缓存请求 C:和 A、B 共享前 1300 token。Mamba 命中 1280,整体命中 1280。这个机制默认开启,B 自己吃不到收益,它负责为后来者把分叉点的 S 存下来。
解决block_size变大的问题
解决了中间满块边界(1280)和尾部满块边界(1920)的 S 留存问题后,再看第二个痛点:block_size 从 64 变成 640,Prefix Cache 的block size的匹配粒度也就粗了 10 倍。即只有当两个请求的公共前缀长度至少达到 640 个 token(或 640 的整数倍)且完全一致时,才能命中一个完整的缓存块;任何不足 640 个 token 的匹配部分(或尾部余数部分)都无法被缓存复用,必须重新进行 Prefill 计算。这就不能像前面说的忽略了~
怎么办呢?其实也没那么复杂,原来计算hash的维度和block_size是绑定的,那是不是可以将两者解耦:保持物理显存分配的 block_size 不变,但引入更小、且能整除 block_size 的 hash_block_size 作为哈希计算的步长(即一个物理块内包含多个哈希单元)。这样一来,即使最后一个物理块没有填满,只要它凑够了至少一个 hash_block_size,就可以用块内最后一个哈希边界的 hash 值将这个未满的物理块缓存起来——也就是所谓的 cache_partial_block(部分块缓存)。当然,受限于 CPU 哈希计算与块内查表的开销,以及底层算子的对齐要求,hash_block_size 也不能无限小。
以下两个细粒度例子的配置假设:物理 block_size 仍为 640,但显式设置 --prefix-match-unit=64,使 hash_block_size = 64。
将这套细粒度哈希与 cache_partial_block 机制应用到前面说的两种场景中(同时还需要考虑 EAGLE/MTP 投机解码强制回退一个 hash_block_size 重算的要求),分别对应了调度器里的两个细粒度停点:
- Agent 多轮会话 / 相同请求重试(Prompt 尾部停点
tail_boundary)
在这类场景下,复用边界就在上一轮 Prompt 的末尾。在上述--prefix-match-unit=64配置下,不使用内部 checkpoint 时,Scheduler._mamba_block_aligned_split会计算出 Prompt 尾部最后一个对齐hash_block_size(64)的位置tail_boundary:未开启 EAGLE/MTP 时,2000 token 对应 1984 = 31 × 64;若开启 EAGLE/MTP,由于匹配时会回退一个hash_block_size,这里会主动提前回退一格到 1920 = 1984 - 64。
tail_boundary = ( get_mamba_prefill_checkpoint_position( request.num_prompt_tokens,self.hash_block_size,self.use_eagle_block_drop, )ifself.mamba_partial_cache_hit andnot use_internal_checkpointelse0 )在上述未开启 EAGLE/MTP 的 64 粒度例子中,调度器在 tail_boundary(1984)处多截一刀,Full Attention 和 Mamba 都通过 _cache_partial_tail_block -> cache_partial_block 将未满块B3(以及 S@1984)注册在h31下。下一轮对话或重试请求到来时,就能直接命中到1984(并通过 Copy-on-Write 拷到私有新块继续往后写),把原本1920 ~ 1984的尾部余数也省下来。
若走 GLM-5.3-Flash 默认的 FlashKDA,由于支持内部 checkpoint(1984 - 0 是 16 的倍数),调度器不再多截这一刀:一次 forward 跑完 [0, 2000),kernel 在内部把 S@1984 导出到预留 block,再由 MambaManager._cache_partial_tail_block 把该 block 按1984重新登记 hash。
- 长 System Prompt + 不同用户问题(分叉点细粒度停点
--enable-mamba-shared-prefix-checkpoint): 回到前面的 Marconi 共享前缀分叉点场景:如果开启了 EAGLE/MTP(或前序请求留下了细粒度尾部),第二个请求在 Full Attention 命中到1280后,会被 EAGLE 退掉一个hash_block_size(64),导致探测出的分叉点junction = shared_prefix_boundary落在了物理块内部的1216! - 默认情况下,Mamba 在中间只认640的整块边界,会把1216 向下取整到640,导致第三个请求只能命中640(因为 EAGLE 退了 64,白白丢掉 576 个 token)。
- 开启
--enable-mamba-shared-prefix-checkpoint后,调度器的junction_stop不再向下取整到 640,而是直接停在块内的细粒度分叉点1216处;同时MambaManager._cache_partial_tail_block放行该分叉点,调用cache_partial_block将S@1216缓存下来,让第三个及以后的请求在1216处实现细粒度命中。
这里特别需要注意的是: “长 System Prompt + 不同用户问题”的中间分叉场景下,--prefix-match-unit 并不能让分叉点也按 64 细粒度命中。因为full attention下,只有尾部的block是允许cache partial的,中间部分仍然都满的,所以得到的junction_stop也一定是block size的倍数。cache.enable-mamba-shared-prefix-checkpoint 只不过是缓解eagle/MTP的丢掉block带来的问题,只丢掉一个小的hash_block_size。
align模式下,因为 Prefill 可以一个大 chunk 跨过好几个 block_size,中间全填 null_block;但 Decode 是逐个 token 往前生成的,它必然会走到每一个 i * block_size(640)的边界。每当 Decode 跨过一个 640 边界时:
- 刚填满的旧块会被注册进 Prefix Cache(以便多轮对话时连模型生成的回答也能作为下一轮的前缀命中);
- 为了不覆盖旧块里的快照,必须分配一个新物理块,并在下一步 forward 前通过
preprocess_mamba(precopy_mamba_align_fused_kernel)把所有层的状态S从旧块完整拷贝到新块,再在新块上继续原地更新。
这里的读写S会成为瓶颈,而且大量写S可能还会把缓存池里真正高频复用的 Prompt 缓存冲刷掉。为此,vLLM 又进一步演化出了两条优化路线:
- 稀疏缓存保留(
prefix_cache_retention_interval):过滤掉非必要的中间块注册,只保留 Prompt 尾部、Marconi 分叉点或指定大间隔的S快照,防止长 Decode 冲刷缓存池; - ReplaySSM:在 Decode 阶段引入小环形缓冲区,缓存近期的递推输入,通常不逐步将完整S写回 HBM,而是在缓冲窗口满或需要保存 checkpoint 时 flush 写回,缓解 Decode 阶段高频写S的带宽瓶颈。vLLM 的 Mamba2 实现通过
--use-replayssm开启,默认缓冲窗口为 16 步。
方法适用性不等于当前实现覆盖范围:ReplaySSM 的“缓存输入并重放”和 RecoverSSM 的“保存验证窗口的修正量,接受后恢复并提交状态”,在方法上都可以用于 GDN 和 KDA;不能简单说 ReplaySSM“不适用于 GLM-5.3-Flash 的 KDA”。具体能否直接启用,要看 vLLM 是否已为该模型、kernel、后端和配置接入了相应实现。
推测解码:验证后如何恢复状态
线性注意力的推测解码与 Full Attention 差异很大:
Full Attention 的 KV Cache 和线性注意力里的 短卷积状态 conv_state,存的都是各个 token 独立的向量(conv_state 只需把滑窗拓宽为 conv_kernel - 1 + num_spec,把候选 token 依次追加在窗口末尾,下一步按 num_accepted_tokens - 1 偏移读取即可),被拒绝的 draft token 不会污染前面的历史状态。
唯独线性注意力的递归状态 S(recurrent_state):所有 token 都原地混合更新到同一个矩阵 [num_heads, head_dim, head_dim] 中,一旦把最终被拒绝的 draft token 更新进去,历史状态就被不可逆地污染了。因此,默认方案必须为每个请求额外分配 num_speculative_blocks 个物理块,将每个候选 token 更新后的 S 分别落盘到不同槽位,以便拒绝采样后回滚到 num_accepted_tokens - 1 对应的干净状态。在已接入相应实现的模型中,也可以采用 ReplaySSM / RecoverSSM,在验证后仅提交接受部分的状态更新;GDN/KDA 都可以采用这些思路,但本文基准版本中的 GLM-5.3-Flash 尚未接入,不能将其当作该模型已有的默认路径(实现范围见上文标注)。
假设目标模型的状态已经处理到前缀 p。上轮采样得到了一个确定 token x0,但目标模型尚未把它作为输入执行前向;草稿模型又给出了 d1, d2, d3(num_spec = 3)。这一轮目标模型的实际输入为:
[x0, d1, d2, d3]处理 x0 的输出用于验证 d1,处理 d1 的输出用于验证 d2,依此类推;最后一个位置的输出可用于全部接受后的 bonus token。验证 kernel 为这四个输入位置分别保存状态:
| 状态列索引 | 本轮处理到的输入 | 保存的递推状态 |
|---|---|---|
| 0 | x0 | S**p+1 |
| 1 | x0, d1 | S**p+2 |
| 2 | x0, d1, d2 | S**p+3 |
| 3 | x0, d1, d2, d3 | S**p+4 |
假设验证结果是 d1, d2 被接受,d3 被拒绝,并重新采样出修正 token r。本轮确认生成的 token 为 [d1, d2, r],而本轮输入中真正有效并算完状态的恰好是 [x0, d1, d2](共 3 个 token),因此下一轮应从 S**p+3 开始,把尚未输入过目标模型的 r 作为下一轮的第一个确定输入 x0'。换言之:采样出了 r,不等于目标模型已经计算并缓存了 r 的状态。
一般地,若接受了 a 个 draft token,还会额外采样出 1 个 recovered token(或全部接受时的 bonus token),因此:
在实现上,spec_state_indices_tensor 为每个请求提供一行物理 slot,形状为 [num_spec_requests, 1 + num_spec],这些物理 slot ID 并不要求连续。例如:
spec_state_indices_tensor[request] = [41, 9, 72, 18]接受两个 draft(a = 2):num_accepted_tokens = 3selected_column = 2下一轮初始递推状态 = state_pool[72](S_){p+3}在没有跨块状态搬移的常规路径中(例如 mamba_cache_mode="none",或 align 模式下仍在同一个 640 块内推进时),下一轮 fused_recurrent_kda 读取初始状态时直接使用:
column = num_accepted_tokens[request] - 1slot = spec_state_indices_tensor[request, column]S = state_pool[slot]这一步直接通过索引偏移完成了逻辑回滚,不需要先把选中的状态从 slot 72 复制回固定的主槽 slot 41;随后 kernel 在片上以 state_pool[72] 为起点,按新一轮输入顺序重新从第 0 列(slot 41)开始依次覆写各状态槽,上一轮被拒绝分支留下的快照(slot 18)自然被覆盖。(仅当 align 模式下跨过 block_size 边界需要封存旧块时,preprocess_mamba 才会按 num_accepted_tokens - 1 将选中槽位的状态显式拷贝到新分配的块槽位中,并将 num_accepted_tokens 重置为 1。)
KDA实现逻辑概述
α[c] = exp(forget_log[c]) # 遗忘门,每个 key channel 一个,∈ (e^{-5}, 1)β = sigmoid(write_logit) # 写门, 每个 head 一个标量γ[c] = sigmoid(output_b[c]) # 输出门,每 head 每 channel,∈ (0, 1)其中:
| 变量 | 计算公式 | 权重 Shape | 输出 Shape |
|---|---|---|---|
qkv | hidden @ W_q hidden @ W_k hidden @ W_v SiLU(causal_conv1d(qkv)) | qkv权重都是:[hidden_size, num_heads × head_dim] conv权重:[3 × num_heads × head_dim, conv_kernel] | qkv都是[num_sched_tokens, num_heads, head_dim] |
β 写门 | sigmoid(hidden @ W_β) | [hidden_size, num_heads] | [num_sched_tokens, num_heads] |
γ 输出门 | sigmoid(hidden @ W_γa @ W_γb) | [hidden_size, head_dim] ,[head_dim, num_heads × head_dim] | [num_sched_tokens, num_heads, head_dim] |
α 遗忘门 | exp(forget_log(hidden @ W_αa @ W_αb)) | 同 γ 两段;另加 A_log、dt_bias | [num_sched_tokens, num_heads, head_dim] |
q, k = l2norm(q), l2norm(k) # 每 head 独立,沿 head_dim 归一化S ← S ⊙ α # 遗忘:按 key 列缩放Δv ← v − S k # 残差S ← S + (β · Δv) ⊗ k # 外积写入o ← S (q · head_dim^{-1/2}) # 读出,注意 scaleo ← RMSNorm(o) ⊙ γ # 输出,W_o[num_heads × head_dim, hidden_size]⊙ 广播在 V 轴上,只按 K 通道不同。GDN 和 KDA 的遗忘门都由当前 token 的 hidden 动态生成。关键区别是:GDN 为每个 head 生成一个衰减标量,而 KDA 为每个 head 的每个 key 通道生成独立的衰减系数。
关于遗忘门的处理逻辑这里需要详细说下:
x = forget_b + dt_bias # forget_b = hidden @ W_αa @ W_αbz = exp(A_log) · xforget_log = lower_bound · sigmoid(z) # 被夹在 (lower_bound, 0)α = exp(forget_log) # 被夹在 (e^{lower_bound}, 1)S = S * α # 每步最多缩到约 0.67%,不会放大| 步骤 | 计算公式 | 输入 Shape | 权重 Shape | 输出 Shape |
|---|---|---|---|---|
| 加偏置 | x = forget_b + dt_bias | [num_sched_tokens, num_heads, head_dim] | [num_heads, head_dim] ,沿 token 广播 | [num_sched_tokens, num_heads, head_dim] |
| 按 head 缩放 | z = exp(A_log) · x | [num_sched_tokens, num_heads, head_dim] | [1, num_heads, 1] ,沿 token、channel 广播 | [num_sched_tokens, num_heads, head_dim] |
| 有界 log | forget_log = -5 · sigmoid(z) | [num_sched_tokens, num_heads, head_dim] | lower_bound = -5 | 同输入,∈ (-5, 0) |
| 遗忘门 | α = exp(forget_log) | [num_sched_tokens, num_heads, head_dim] | — | 同输入,∈ (e^{-5}, 1) |
| 乘到状态 | S = S × α | S[h,req] [head_dim, head_dim] ;α[num_sched_tokens, num_heads] [head_dim] | — | S[h] 同输入;每列最多缩到约 e^{-5}≈0.67%,不会放大 |
A_log 每 head 一个标量;dt_bias 每 head 每 channel 一个。上表省略了 batch 维;当输入使用 [1, num_sched_tokens, num_heads, head_dim] 时,A_log 的广播形状才是 [1, 1, num_heads, 1]。S为每请求每 head 一张shape为[head_dim, head_dim]的recurrent_state。
vLLM中Decode的实现
融合GEMM Proj
实现里 6 个投影合成一次 in_proj_qkvbfg_a。
| 步骤 | 计算公式 | 输入 Shape | 权重 Shape | 输出 Shape |
|---|---|---|---|---|
| 融合投影 | hidden @ W_qkvbfg_a | [num_sched_tokens, hidden_size] | [hidden_size, 3 × num_heads × head_dim + num_heads + 2 × head_dim] | [num_sched_tokens, 3 × num_heads × head_dim + num_heads + 2 × head_dim] |
| split | 按列切开 | 上一行 | — | 见下表 |
| 张量 | Shape | 含义 |
|---|---|---|
qkv | [num_sched_tokens, 3 × num_heads × head_dim] | 尚未拆 q/k/v |
write_logit | [num_sched_tokens, num_heads] | 写门 logit,每 head 1 个数 |
forget_a | [num_sched_tokens, head_dim] | 遗忘门第一段,不按 head 切 |
output_a | [num_sched_tokens, head_dim] | 输出门第一段,同样不切 |
GEMM:遗忘门、输出门升到 per-channel
| 步骤 | 计算公式 | 输入 Shape | 权重 Shape | 输出 Shape |
|---|---|---|---|---|
| 遗忘升维 | forget_a @ W_fb | [num_sched_tokens, head_dim] | [head_dim, num_heads × head_dim] | forget_b [num_sched_tokens, num_heads × head_dim] |
| 输出升维 | output_a @ W_gb | [num_sched_tokens, head_dim] | [head_dim, num_heads × head_dim] | output_b [num_sched_tokens, num_heads × head_dim] |
| reshape forget_b | view | forget_b | — | [1, num_sched_tokens, num_heads, head_dim] |
| reshape output_b | view | output_b | — | [num_sched_tokens, num_heads, head_dim] |
短卷积
通道维独立,所以把 q/k/v 在通道上拼起来做一次 causal conv,和三次分开数学等价。
| 步骤 | 计算公式 | 输入 Shape | 权重 Shape | 输出 Shape |
|---|---|---|---|---|
| 合并 conv | causal conv1d, SiLU, kernel=conv_kernel | qkv [num_sched_tokens, 3 × num_heads × head_dim] | q/k/v 原始权重各为 [num_heads × head_dim, 1, conv_kernel];合并后传给算子的权重为 [3 × num_heads × head_dim, conv_kernel] | 同输入 Shape |
| split | view | 上一行 | — | q,k,v 各 [num_sched_tokens, num_heads × head_dim] |
| 拆 head | view | 各投影 | — | [1, num_sched_tokens, num_heads, head_dim] |
卷积读/写 conv_state,decode 用 causal_conv1d_update,prefill 用 causal_conv1d_fn。
门控变成 α、β(decode 在 kernel 内)
| 步骤 | 计算公式 | 输入 Shape | 参数 Shape | 输出 Shape |
|---|---|---|---|---|
| 写门 | β = sigmoid(write_logit) | [1, num_sched_tokens, num_heads] | — | 同输入,fp32 |
| 遗忘 | forget_log = lower_bound · sigmoid( exp(A_log) · (forget_b + dt_bias) ) | forget_b [1, num_sched_tokens, num_heads, head_dim] | A_log [1,1,num_heads,1] ;dt_bias [num_heads, head_dim] | forget_log 的 Shape 同 forget_b,值落在 (lower_bound, 0) |
| 衰减系数 | α = exp(forget_log) | [1, num_sched_tokens, num_heads, head_dim] | — | 每 head、每 key channel 一个,(e^{lower_bound}, 1) |
递推核(每个 head 独立)
kernel 里还会对 q、k 做 L2 norm(use_qk_l2norm_in_kernel=True)。
| 步骤 | 计算公式 | 输入 Shape | 状态 Shape | 输出 Shape |
|---|---|---|---|---|
| 归一化 | q, k ← l2norm(q), l2norm(k) ;q ← q · head_dim^{-1/2} | q, k [head_dim] | — | 同输入 |
| 遗忘 | S ← S ⊙ α | α [head_dim] broadcast 到 V | S [head_dim_v, head_dim_k] | 原地 |
| 残差 | Δv ← v − S k | v,k [head_dim] | 同上 | Δv [head_dim] |
| 写入 | S ← S + (β Δv) ⊗ k | β 标量 | 同上 | 原地 |
| 读出 | o ← S q | q [head_dim] | 同上 | o [head_dim] |
逐 token 扫完后:
core [1, num_sched_tokens, num_heads, head_dim]decode(含推测验证)在各平台都走 fused_recurrent_kda;prefill 在本文配置下默认走 FlashKDA,强制 Triton 或不满足 FlashKDA 条件时走 chunk_kda_with_fused_gate(分块 + 门控 cumsum),见本章开头的后端表。公式同一套,只是执行计划不同;下一节按 Triton 路径展开。
输出门 + 投回 hidden
| 步骤 | 计算公式 | 输入 Shape | 权重 Shape | 输出 Shape |
|---|---|---|---|---|
| 门控 RMSNorm | 每 head RMSNorm,再 × sigmoid(output_b) | core 与 output_b [num_sched_tokens, num_heads, head_dim] | RMSNorm 的 head_dim 向量 | 同 core |
| 展平 | view | 上一行 | — | [num_sched_tokens, local_projection_size] |
| 输出投影 | flat @ W_o ,TP 时再 AllReduce | [num_sched_tokens, local_projection_size] | [num_heads × head_dim, hidden_size] (数学上;RowParallel 按行切) | [num_sched_tokens, hidden_size] |
Prefill中的Chunk微观并行
本节以 Triton FLA 路径(chunk_kda_with_fused_gate)为讲解实现,取其 chunk 长度 C=64(FLA_CHUNK_SIZE)、子块大小 16×16。一般公式对任意 C 成立;FlashKDA 计算的是同一套代数,但它是独立的融合 CUDA kernel,tile 划分和中间结果的存放以其自身实现为准,不能直接套用这里的分块参数。
先约定一个 chunk、一个 head 内的记号。S0 是块首状态,S**C 是块末状态;q**i,k**i 均指短卷积及激活之后、已做 L2 归一化的向量,读出时使用 q̂i=q**i√(d**k)。本节的 o**i、O 只表示核心状态读出,尚未经过输出端的 RMSNorm、输出门和投影。定义逐通道的 log-gate 和块内前缀和:
对数和指数均逐元素计算,前缀和在每个 chunk 开头重新起算。α 连乘和 e**G 表达的是同一组衰减:
上文已经给出三阶段执行方式:不同 chunk 的预计算和输出可以并行,同一请求的块间状态仍按顺序传递。切块本身并没有消除递归依赖,还需要把块内计算组织成适合 GPU 执行的运算。
在 Decode 阶段,每次只来一个新 Token,S**t-1→ S**t 的更新自然只执行一步。在 Prefill 阶段,一批输入已经给定;如果仍逐 token 执行状态更新,就会受到时间依赖的限制,主要计算也仍是矩阵与向量乘法、外积和归约,难以获得较大矩阵乘法的 Tensor Core 执行效率。
Chunkwise 重排把大量逐 token 运算转成矩阵乘法,使状态和输入能够被多个 token 复用,并增加时间维上的并行机会;同时也引入辅助矩阵和快照等开销。它不要求所有 token 的每一步都同时执行,最终收益取决于这些成本的平衡,需要结合实际 kernel 测量。
这里要算的不只是“这个 chunk 结束后,状态变成什么”,还要算“chunk 里的每个 token 分别读出什么”。因此,接下来的推导有两个目标:
- 块末状态 *SC***
传给下一个 chunk,继续维护历史记忆。
- 块内输出 O
包含本 chunk 每个 token 在完成自己的更新后读出的 o**i,供后续的归一化、输出门和投影使用。
只得到 S**C,并不等于已经得到了所有 o**i:第 i 个 token 需要读取的是自己的 S**i,不能统一拿块末的 S**C 来读。后面要做的,就是在保留原递推结果的前提下,把状态更新和逐位置读出都改写为下三角系统与矩阵运算,避免为计算输出而逐个生成完整的 S1,…,S**C-1。
上文中,我们已经得到公式:
已知一个 chunk 包含 C 个 token,其块末状态可以写成
矩阵连乘按下标递增的顺序从左到右排列;当 i=C 时,空乘积为 Idk,因此最后一项就是 H**C。
缩写为:
这条公式把状态的来源分成了两条线:
- 块内新增的信息
本 chunk 的 value 写入后,经过后续 token 的变换,最终留下多少?这就是 Δchunk。
- 块外传入的信息
已有状态 S0 经过本 chunk 后,变成什么?这由 Transitionchunk 描述。
因此,接下来按以下顺序推导:
- 计算 Δchunk:它按定义不包含 S0,因此只追踪本 chunk 的 value 写入及其后续变换。
- 计算 Transitionchunk,再拆成两部分:
- a. D**C 遗忘门 α 对 S0 的直接衰减。
- b. 本 chunk 各 token 的残差更新,对 S0 的进一步修正。
- 把两条线重新合并,得到块末状态 S**C,用于块间传递。
- 计算块内输出 O:复用前面求出的实际写入残差,把每个位置的 o**i=Siq̂i 整理成矩阵乘法,无须逐个生成完整的中间状态。
输出部分最终会得到:
这里先记住各项的作用:Q̂in 是带上块首到当前位置衰减的 query;E 按行存放每个 token 的实际写入残差,已经包含写门 β;M 是包含对角线的下三角读取矩阵,保证每个 token 只读取自己及之前的写入。具体形式会在后面的“块内输出”中展开。
下面多次使用两条对角矩阵恒等式:
只有对角衰减可以这样合并;一般的 T**i 不能交换顺序。
计算 Δchunk
1. 只考虑块内写入,重新表示每次写入
因为 Δchunk 不包含 S0,本节只计算块内写入的累积,不计入传入状态的影响。 这等价于从零状态开始执行同样的更新,而不是要求实际传入状态为零。
先用四 token 的缩小示例展开:
将从零状态出发、只包含本 chunk 写入的状态记为 S**iloc,其中 S0loc=0,块末有 S**Cloc=Δchunk。将对应的残差 value 记为 u**i:它用当前 v**i 减去此前块内写入产生的预测,再乘更新强度 βi,不包含实际传入状态 S0 的影响。包含旧状态影响的实际残差仍记为 r**i:
从这个纯衰减 + 残差写入的递推展开:
推广到任意的 i,即在 token i 已完成衰减、尚未写入时,
2. 从当前读取推导 *Aij***
历史 token j 对当前局部读取 S̄ilock**i 的贡献为
中括号里是标量,表示历史 key 衰减到当前读取位置后,与当前 key 的对齐程度。把所有历史贡献相加,再代入残差定义:
现在才把中括号里的系数命名为 A**ij:
A 是一个记录“前面的 token 对当前 token 有多大预测贡献”的系数矩阵。于是
这里有三个容易混淆的细节:
- 衰减从 j+1 开始,因为 ujkjT 是在 token j 自己的衰减之后才写入的。
- 衰减包含 i,因为 token i 先衰减,再读取历史状态。
- 系数乘当前的 βi,而不是再乘一次 βj;历史更新强度已经包含在 u**j 中。
j≥ i 时置零来自因果顺序,不是对 key 正交性的要求。
3. 把递推整理成单位下三角系统
为便于展示,下面用四 token 的缩小示例(C=4):
把所有 u 项移到左边,并把列向量的转置按 token 排成行,定义
上述四条方程就变成
因此,对任意 C 都有
对角线上的 1 来自每行自己的 u**i;严格下三角的 A 则记录对历史残差的依赖。I+A 对角全为 1,所以总是可逆,不要求 key 之间线性无关。
写成逆矩阵是数学表达;实际计算可以直接解单位下三角系统,也可以先得到逆矩阵,再与右端相乘。两种方式求解的是同一个关系。
下三角系统仍有依赖,为什么这样改写能更快?
单纯写成 (I+A)-1 并不会让依赖消失。如果仍按行直接前向代入,就仍有逐行依赖。工程上的做法是进一步分块:小块内部保留短递推,跨子块的合并则尽量改成矩阵乘法。
令 L=I+A,把它分成两组 token 对应的块:
L11-1 和 L22-1 可以独立准备;两者就绪后,左下角通过矩阵乘法合并。这个公式可以递归应用,将长的逐行依赖拆成短的子块递推和若干矩阵乘法阶段。
本文核对的 vLLM Triton solve_tril 实现使用 16×16 子块,并提供合并到 32×32、64×64 等尺寸的路径。子块内部仍有循环,跨子块部分使用矩阵乘。
得到 R=(I+A)-1 后,可以通过矩阵乘法计算 U=R(BV),后面计算旧状态修正方向 W 时还能复用同一个 R。收益来自子块和 chunk 间的并行、矩阵乘法的数据复用,以及求解结果的复用;求逆和保存辅助矩阵本身也有成本,chunk 大小需要结合硬件和精度选择。
4. 把每次残差写入送到块尾
求出的 u**i 对应写入时刻。它在块末展开式中的对应项,还需要包含写入之后的衰减。定义
这里的空逐元素乘积为全 1 向量,所以 k**g,C=k**C。在4 token 的缩小示例中,
本节只累计块内写入,因此到块尾得到的就是 Δchunk。仍以四个 token(C=4)为例,把矩阵乘法完整展开:
最后一步不是额外假设,而是矩阵乘法的定义:U**T 的第 i 列为 u**i,K**g 的第 i 行为 k**g,i**T,乘起来就是这些外积的总和。
这个关系对任意 chunk 长度 C 都成立,因此第一条线的结果为
计算 Transitionchunk
前面算的是不含 S0 的块内增量,现在计算传入状态 S0 的影响。以下 S**i 表示完整实际状态,与前面的局部状态 S**iloc 区分。这一条线只回答:旧状态经过整个 chunk 后,留下什么?
从单 token 的公式
可以看出,旧状态受到两种不同操作:
- 遗忘门对状态的 key 列做直接缩放。
- 当前 token 读出已有预测,再沿当前 key 的外积方向扣除该预测,以便写入目标 value。
DC 遗忘门对 S0 的直接影响**
先提取展开式中 S0 只经过各次门控衰减的直接项:
因为 Diag(αi) 是对角矩阵,这些衰减可以逐维相乘:
就得到
对状态的第 b 列而言,缩放因子就是 ∏t=1Cαt,b。这部分只依赖遗忘门,与 key、value 和 β 无关。
但它还不是完整的 S0Transitionchunk:即使 αi 全为 1,后面的残差更新仍然可能改变旧状态。
后续 token 的残差更新对 S0 的进一步影响
1. 先求旧状态到当前位置的直接读取
token i 从旧状态的纯衰减项中读到的是
定义
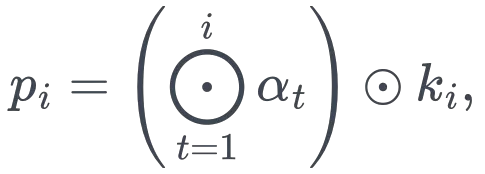
上式就成为 S0p**i。这里的衰减从块首一直覆盖到当前 token,包含 αi,因为读取发生在当前衰减之后。
例如
注意:S0p**i 只是旧状态未经前面残差修正时的直接读取,还不是旧状态对当前位置的完整影响。前面的 token 已经根据旧状态改写过自己的残差,当前 token 还会读到那些改写。
2. 在完整实际残差中分离 S0 的影响
将一般情况下的递推 S**i=S**i-1Diag(αi)+rikiT 展开,在 token i 读取之前有
右乘 k**i、代入 r**i=βi(v**i-S̄iki),得到
这里出现的 A 与计算 Δ 时完全相同。原因是:无论历史残差来自什么,历史写入 rjkjT 到当前位置的衰减与读取过程都相同。
与前面只追踪块内增量时得到的局部残差公式对照:
两式相减,原始 value 项抵消:
这就是“传入旧状态会怎样改变每次残差”的完整递推。它既包含当前对旧状态的直接读取,也包含前面修正的间接影响。
3. 提取与 S0 无关的修正方向 *wi***
第一个 token 没有历史残差,因此
于是定义 w1=β1p1。若此前已经有 u**j-r**j=S0w**j,那么
由此定义并归纳得到
这里并没有对 S0 求逆,也不要求 S0 满秩。w**i 是长度为 d**k 的方向向量,只由 key、遗忘门和 β 决定;将局部残差 u**i 补全为实际残差 r**i 时,需要扣掉的旧状态相关 value 是 S0w**i。
以四个 token 为例:
为什么不能直接令 w**i=βipi?以第二个 token 为例,token 1 的实际残差 r1 相对局部残差 u1 已经有了 -S0w1 这项修正;token 2 会读到这一差异,所以它的净修正要减去 A21w1。后面各步依此类推。
因此,每次修正都不是把原始 S0 独立擦除一次。此前 token 已经改变了后续 token 将读到的旧状态影响,这些相互作用由 A 的递推完整记录。
4. 为什么计算 W 可以复用计算 U 的下三角系统
上一节得到的是逐 token 的递推:
其中 w**i、p**i 都是长度为 d**k 的向量,A**ij 是一个标量,用来缩放历史向量 w**j。下面将这些递推整理成一个矩阵方程,关键是:矩阵乘法的每一行,恰好对应一个 token 的递推方程。
第一步:把所有含 w 的项移到左边。
接着上一节的四个 token,移项后分别为:
这里每一行中,当前 w**i 的系数都是 1,历史 w**j 的系数是 A**ij,未来 w**j 的系数则为 0。这正是一个对角线全为 1 的下三角系数矩阵。
第二步:按 token 排成行,写出对应的矩阵乘法。
先明确 Kin 存的是什么。前面已经将 token i 对旧状态纯衰减项的读取写成 S0p**i,其中
也就是说,可以把从块首到当前位置的门控衰减合并到当前 key 中,再用这个 p**i 读取原始传入状态 S0。将所有 token 的这些读取方向按行排起来,就是 Kin。 下标 in 表示它用于传入状态的读取。
例如,四个 token 时:
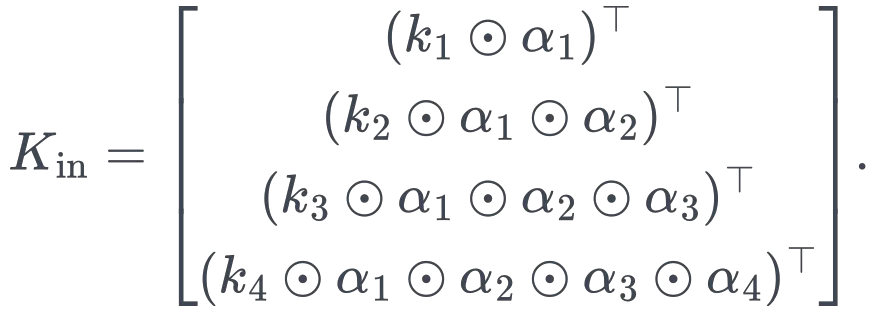
Kin 只由 key 和遗忘门决定,本身不含 S0、value 或 β。它提供的是直接读取方向;结合 β 和历史残差的修正,才得到前面递推中的 w**i。将这些修正方向也按行排起来,定义
两者形状均为 C× d**k。这里使用转置,只是为了把原来的列向量排成矩阵的一行;因此,上面的每个向量方程也要一起转置。四个 token 的方程就可以合写为:
例如,左边矩阵乘法的第 3 行展开就是
恰好等于右边第 3 行的 β3p3T。因此,这个矩阵等式只是把逐 token 方程放到一起,并没有改变递推关系。
前面定义的 A 是严格下三角矩阵,对角线为 0;加上单位矩阵 I,就补上了当前 w**i 的系数 1。右边每一行都是 piT 乘以对应的 βi,所以沿用 B=Diag(β1,…,βC),右边就是 BKin。
于是,对任意 chunk 长度 C,都有
第三步:复用已经计算的下三角逆矩阵。
与前面求 U 的方程并列:
两式的系数矩阵都是 I+A,因此可以沿用计算 U 时得到的 R=(I+A)-1:
计算 W 无须重新求逆,只需将同一个 R 乘以新的右侧输入 BKin。
5. 把对旧状态的修正传播到块尾
前面已经得到实际残差与局部残差的关系:
但残差 value 本身还不是写入状态的矩阵。根据更新规则 S**i=S**i-1Diag(αi)+rikiT,每次写入都要将残差 value 与当前 key 做外积。因此,两种情况下第 i 次写入分别是:
用实际写入减去局部增量写入,就得到 S0 引起的写入差异:
接下来将这项差异带到块尾。沿用计算 Δchunk 时定义的块尾衰减 key:
这里不包含 αi,因为本次写入发生在当前衰减之后;最后一个 token 的 k**g,C=k**C。在残差写入的展开方式下,第 i 次写入差异到块尾的对应项为
后续残差对它的进一步响应已经记入后续的 w**j,因此这里与计算 Δ 一样,只保留后续纯衰减,不能再乘一次完整 T。
将 k**g,i**T 按 token 排成行,就是前面的 K**g;W 的第 i 行则是 wiT。因此,矩阵乘法 WTK**g 恰好等于各次外积之和 Σiwik**g,i**T。把所有 token 对旧状态的修正项加起来,得到:
于是,Transition 的两部分终于合在一起:
这一等式对任意 S0 成立,因此
遗忘在 b 部分是一种定向修正的直观说法,不表示 WTK**g 的每个元素都非负,也不保证状态每个元素都减小。例如,当 ‖k**i‖2=1 且 βi=1 时,I-kikiT 会移除衰减后状态在 k**i 方向上的分量;一般情况下,应以矩阵公式为准。
合并得到块末状态
对任意 S0,展开 S**i=S**i-1Diag(αi)+rikiT,有
代入刚刚推导的 r**i=u**i-S0w**i:
所以最终得到
前两项属于 S0Transitionchunk,第三项属于 Δchunk。这是对开头公式的精确重写,没有近似,也没有省略 token 之间的交叉项。
块内输出:不物化逐 token 状态的并行读出
前面的合并得到块末状态得到的是 S**C。但模型输出要求每个 token 都读一次自己的状态 S**i,而 S1,…,S**C-1 正是 chunk 算法要避免逐个生成的中间状态。
单 token 的完整顺序是:先衰减,再读取残差,再写入,最后读出。
将状态递推展开到第 i 步:
因此,第 i 个 token 的输出为:
第一项是从衰减后的块首状态中读取;第二项是从当前及历史实际写入中读取。
定义带有块首到当前位置衰减的 query:
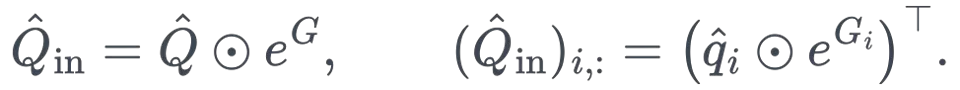
为便于展示,下面用四 token 的缩小示例(C=4):
定义包含对角线的下三角读取矩阵 M:
M**ij 表示:token j 的写入衰减到位置 i 之后,被 q̂i 读出的比例。
再将实际残差按行堆叠:
于是,整个 chunk 的输出可以写成:
E 的第 i 行是实际残差 riT,也就是 token i 真正写入状态的 value。它和前文的局部残差 U 相差 S0 带来的修正 WS0T。其中 U 来自局部写入的残差求解,W 来自旧状态对残差的修正。
以 i=1 验证:S1=S0Diag(α1)+r1k1T,所以 o1=S0(q̂1⊙α1)+(q̂1T**k1)r1,与公式一致。
把 E 展开,就能和前面的块末状态公式逐项对应:
完整计算顺序
前面分别得到了块内局部写入、旧状态对写入的修正,以及块内输出。现在把它们合在一起,得到一个完整 chunk 的计算公式。
一个 chunk 需要产生两类结果:
- 块末状态 *SC***
传给下一个 chunk;
- 块内输出 O
包含当前 chunk 中每个 token 的输出。
衰减区间
| 用途 | 衰减因子 | 对应区间 | 区间 | 对象 |
|---|---|---|---|---|
| 块首状态参与第 i 步的残差计算与读取 | eGi | 第 1 步到第 i 步 | 旧状态从块首到当前读取前 | p**i ,即 Kin 的第 i 行转置 |
| 第 j 步写入影响第 i 步 | eGi-G**j | 第 j+1 步到第 i 步 | 历史写入之后到当前读取前 | 构造 A**ij 时使用的历史 key,j<i |
| 第 i 步写入汇总到块尾 | eGC-G**i | 第 i+1 步到第 C 步 | 当前写入之后到块尾 | k**g,i ,即 K**g 的第 i 行转置 |
所有边界都来自同一个约定:先衰减,再读写。
因为逐元素乘积等于对数之和的指数,所以
这里 G**i-G**j 正好消去前 j 项,只留下 j+1 到 i。同理,G**C-G**i 只留下 i+1 到 C。
计算顺序与形状检查
现在可以从输入出发,按计算依赖把整个过程串起来。下面只看一个 chunk、一个 head:输入为传入状态 S0、按 token 排成行的 key 矩阵 K、value 矩阵 V、每个 token 的更新强度 βi,以及逐维 log-gate g**i=lnαi。
第一步:沿 token 维求前缀和,得到 G。
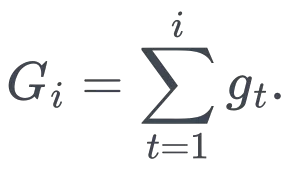
将每个 giT 排成一行,四个 token 时就是
这一步只得到累计 log-gate,还没有得到衰减因子或经过衰减的 key。对 G**i 取逐元素指数,才恢复 α1⊙⋯⊙αi。
第二步:由同一份 G 构造两种 key,并取出全块衰减。
对于 Kin,每行 key 乘上块首到当前位置的衰减:
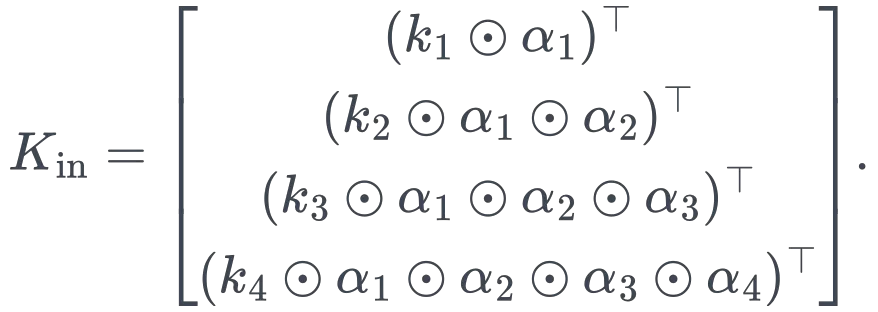
对于 K**g,用块尾累计值减去每一行的累计值,再取指数、乘 key:
例如,四个 token 时,G4-G2=g3+g4,所以 K**g 的第 2 行就是 (k2⊙α3⊙α4)T。这里复用的是同一份前缀和,不需要再计算一份后缀和。
旧状态的纯衰减也由同一份结果给出:各列的缩放因子为 eGC。因此,到这一步只使用了 key 和 gate,尚未计算残差。
第三步:由 key、G 和 β 构造 A,再求 (I+A)-1。
具体来说,先计算 exp(G**i-G**j),得到历史写入 j 到当前读取 i 之间的累计衰减因子;将它逐元素乘到历史 key k**j 上,再与当前 key k**i 做内积,最后乘当前更新强度 βi
然后计算
这里的 I+A 是残差递推的系数矩阵,不是第一步中用于累加 log-gate 的全 1 下三角矩阵。前缀和与两种 key 只解决了衰减问题;历史写入之间的残差依赖还要通过这个下三角系统处理。
第四步:用同一个 R 分别计算 U 和 W。
先给 V 和 Kin 的每一行乘对应的 βi,再左乘 R。这一步分别得到本 chunk 的局部残差 U,以及旧状态引起的残差修正方向 W。
第五步:代入 S0,合并残差后更新状态。
先用尚未衰减的 S0 计算实际残差,再将 S0 逐列乘全块衰减,最后加上实际残差经 K**g 汇总后的写入。不必分别生成纯衰减、残差修正、局部增量三个完整状态矩阵后再相加。
第六步:引入 query,利用同一份实际残差 E 计算块内输出。
输出还需要按 token 排成行的 query 矩阵 Q̂∈ℝC× d**k(已做 L2 norm 并乘了 scale)。先复用第一步的累计 log-gate G,让每行 query 乘上块首到当前位置的衰减:
再构造包含对角线的下三角读取矩阵 M:
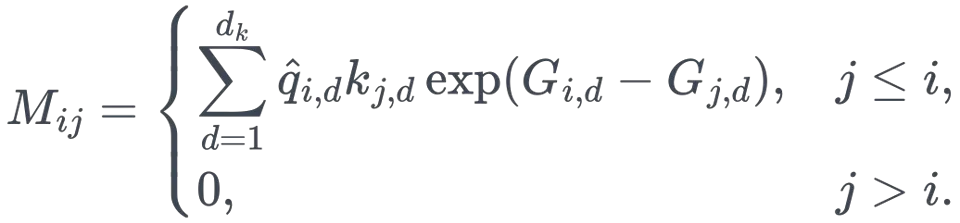
它与第三步构造 A 的过程类似,但有三个区别:当前读取向量由 k**i 换成 q̂i,不再乘更新强度 βi,并且保留对角线。因为输出是在当前写入之后读取的,所以第 i 个 token 可以读取自己的写入:
然后直接使用第五步得到的实际残差 E,计算整个 chunk 的输出:
其中,Q̂inS0T 是从衰减后的块首状态中读取,ME 是从当前及历史实际写入中读取。更新强度 βi 已经包含在 E 中,不需要在 M 中重复乘入。
整条推导的起点是旧状态的变换 + 块内写入的累积。为了真正计算这两部分,先把逐 token 更新改写成纯衰减 + 残差写入。
对新 value,历史读取产生系数 A,由此解出不含旧状态影响的残差 U,再用块尾 key K**g 汇总,得到 Δchunk。
对旧状态,先保留遗忘门带来的 S0Diag(α1⊙⋯⊙αC),再追踪旧状态如何改变每一次残差。这个差异经过相同的历史读取关系,因此复用同一个 A 解出 W,并在块尾形成 -S0WTK**g。
最终2种信息来源通过同一套更新规则传播:
总结
还是那句话,大模型本身更像是一门基于假设的实验科学,而底层的 AI Infra 则是实打实的数学与工程。
从普通线性注意力、DeltaNet、GDN 一路演进到 KDA,核心其实就一件事:在模型表达力、算法并行度(代数结构)和硬件成本(访存与算力)之间做 trade-off。无论是本文讲的 Linear Attention,还是 MLA、DSA、CSA、SWA、IndexCache,本质上都是对全注意力机制的适度妥协,用表达能力上的取舍,换取计算与访存效率的提升。这正是算法与体系架构 Hardware-Software Co-design 的核心所在。
本文属于《大模型架构演进:从内存墙到百万上下文》的一篇,其他部分还在筹备中...
reference
DeepSeek-R1: Incentivizing Reasoning Capability in LLMs via Reinforcement Learning
DeepSeek-V2: A Strong, Economical, and Efficient Mixture-of-Experts Language Model
DeepSeek-V4: Towards Highly Efficient Million-Token Context Intelligence
DeepSeek-V4.1-Flash: Pushing the Limits of KV Cache Compression
DeepSeekMoE: Towards Ultimate Expert Specialization in Mixture-of-Experts Language Models
Native Sparse Attention: Hardware-Aligned and Natively Trainable Sparse Attention
IndexCache: Accelerating Sparse Attention via Cross-Layer Index Reuse
Very Deep Convolutional Networks for Large-Scale Image Recognition
Deep Residual Learning for Image Recognition
Identity Mappings in Deep Residual Networks
mHC: Manifold-Constrained Hyper-Connections
Conditional Memory via Scalable Lookup: A New Axis of Sparsity for Large Language Models
Adaptive Computation Time for Recurrent Neural Networks
Relaxed Recursive Transformers: Effective Parameter Sharing with Layer-wise LoRA
Mixture-of-Recursions: Learning Dynamic Recursive Depths for Adaptive Token-Level Computation
Scaling up Test-Time Compute with Latent Reasoning: A Recurrent Depth Approach
Blockwise Parallel Decoding for Deep Autoregressive Models
Speculative Decoding: Exploiting Speculative Execution for Accelerating Seq2seq Generation
Fast Inference from Transformers via Speculative Decoding
Accelerating Large Language Model Decoding with Speculative Sampling
EAGLE: Speculative Sampling Requires Rethinking Feature Uncertainty
EAGLE-2: Faster Inference of Language Models with Dynamic Draft Trees
EAGLE-3: Scaling up Inference Acceleration of Large Language Models via Training-Time Test
Better & Faster Large Language Models via Multi-token Prediction
SuffixDecoding: Extreme Speculative Decoding for Emerging AI Applications
Medusa: Simple LLM Inference Acceleration Framework with Multiple Decoding Heads
DFlash: Block Diffusion for Flash Speculative Decoding
DSpark: Confidence-Scheduled Speculative Decoding with Semi-Autoregressive Generation
Adaptive Verification in vLLM: DSpark confidence-scheduled verification
Efficient Streaming Language Models with Attention Sinks
When Attention Sink Emerges in Language Models: An Empirical View
Why do LLMs attend to the first token?
gpt-oss-120b & gpt-oss-20b Model Card
RadiK: Scalable and Optimized GPU-Parallel Radix Top-K Selection
Gated Delta Networks: Improving Mamba2 with Delta Rule
Kimi Linear: An Expressive, Efficient Attention Architecture
Linear Transformers Are Secretly Fast Weight Programmers
Parallelizing Linear Transformers with the Delta Rule over Sequence Length
Eagle and Finch: RWKV with Matrix-Valued States and Dynamic Recurrence
Transformers are RNNs: Fast Autoregressive Transformers with Linear Attention
The Devil in Linear Transformer
Hungry Hungry Hippos: Towards Language Modeling with State Space Models
Mamba: Linear-Time Sequence Modeling with Selective State Spaces
Retentive Network: A Successor to Transformer for Large Language Models
Gated Linear Attention Transformers with Hardware-Efficient Training
RoFormer: Enhanced Transformer with Rotary Position Embedding
LoRA: Low-Rank Adaptation of Large Language Models
A Storage Efficient WY Representation for Products of Householder Transformations
Marconi: Prefix Caching for the Era of Hybrid LLMs
ReplaySSM: Cache SSM Inputs, Not State
ReplaySSM: Rethinking State Storage for Faster Hybrid-Model Decoding
将Softmax Attention线性化为Gated DeltaNet
Transformer升级之路:2、博采众长的旋转式位置编码
YaRN: Efficient Context Window Extension of Large Language Models
从 305 GB 到 7.4 GB:大模型 KVCache 架构演进全景
算一算 DeepSeek Flash V4.1 的 KVCache 大小
Scaling Kimi K3 on AMD Instinct MI355X: Matching NVIDIA HGX B300 Throughput per GPU on AgentX
Kimi K3 Is Here: Efficient Day-0 Support on vLLM
附1. chunk内 A和M 的计算
1. 为什么不能一次矩阵乘法算完
逐元素写开:
衰减因子同时依赖 i 和 j。如果逐通道拆成 eGi⊙ e-G**j,在精确算术下就能写成一次矩阵乘法再取下三角:
这里 tril 保留对角线。但 G 是负数的累加,一个 chunk 内可接近 64×(-5)=-320,而 e320 远超 fp32 上限(约 e88.7),会溢出;事后加因果掩码也无法修复已经溢出的有效下三角项。
2. 切成 16×16 子块
把 chunk_size = 64 切成 4 个子块:
上三角子块全为 0,直接跳过。
非对角子块 *Mab*(a>b):用参考点拆成矩阵乘法。** 取行子块 a 的第一个 token 作为参考点 n:
- 拆分是精确的:同一通道的两段指数相加,正好还原 G**i-G**j。
- 不会溢出:行 i 在参考点之后,列 j 在参考点之前,即 i≥ n>j。G 单调不增,所以两段指数都 ≤0。
对角子块 *Da*:逐列直接算。** 子块内的行和列属于同一段 token,找不到"行都在之后、列都在之前"的参考点。设子块首 token 的全局编号为 n**a,局部行列编号为 r,s∈{1,…,16},对应 i=n**a+r-1、j=n**a+s-1,则:
若实现先计算整列再把 i<j 的行置零,被置零的位置指数为正,但跨度最多 15 个 token;lower_bound = -5 时最大约 e75,仍在 fp32 范围内。最终结果只保留 i≥ j,包含对角线。
3. 与 A 共用同一个 kernel
在同一个子块中,K**b⊙ eGn-G**b 只算一次,然后分成两路:
| 左乘的矩阵 | 之后 | 保留范围 | |
|---|---|---|---|
| A | K**a⊙ eGa-G**n | 每行乘 βi | i>j |
| M | Q̂a⊙ eGa-G**n (Q̂ 已含 scale) | — | i≥ j |
所以 M 和 A 是同一对 kernel 的两个输出,不需要额外再读一遍 key 和 gate。
4. M 与 A 的对照
两者的衰减区间都是 j+1 到 i,区别只有三点:
| A**ij | M**ij | |
|---|---|---|
| 与历史写入做内积的向量 | k**i | q̂i |
| 系数 | 乘 βi,用于构成当前残差 | 不乘,写入强度已包含在 r**j 中 |
| 对角线 | 不含,因为残差在写入前读取 | 含,因为输出在写入后读取 |
附2: 为什么要L2 Norm
L2 Norm是什么
假设原始的 Key 向量 k̃t 是一个 d**k 维的列向量,即 k̃t = [x1, x2, ⋯, xdk]T。
根据 L2 范数的严格数学定义,向量 k̃t 的长度为:
我们再来看根号里面的内积 k̃tTk̃t。行向量乘以列向量,展开后正是各个元素的平方和:
给这个内积套上平方根,就得到了:
对非零向量 k̃t,理想的 L2 归一化操作为
所以,在非零输入、精确算术下,归一化后有 ktTkt=1。工程实现会加入 ε 等数值保护,避免零向量除零;此时范数不一定严格等于 1。下面先按理想的单位范数推导,非单位范数时应保留前文公式中的 ‖k**t‖22。
确保 Delta Rule 转移不放大旧状态
先看不含额外遗忘门的 DeltaNet 更新:
L2 归一化约束的是旧状态转移矩阵 I-βtktkt**T,并不单独保证带有持续写入的完整状态永远有界,也不保证所有历史关联都不会遗忘。
要验证这一点,我们需要建立一个直觉:矩阵 *St* 是一个记忆库**。测试这个记忆库好不好的最好方法,就是用不同的查询向量(Query)去读取它,看看能读出什么(即计算 Stq)。
我们需要证明:在 0≤βt≤1 时,Delta Rule 的旧状态转移只收缩或保留各方向,而不会将它们放大。它不是 GDN/KDA 中单独的遗忘门 αt。
两个方向: 1. 用k**t模式匹配S**t; 2. 用k**t的正交方向模式匹配S**t
查询刚刚写入的知识
即用 k**t 本身去查询
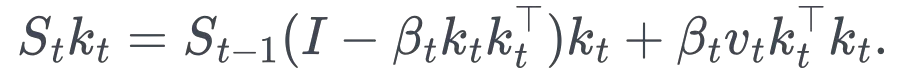
利用结合律,把内积 ktTkt 括起来:
代入 ktTkt=1:
这里:
- S**t-1k**t
旧状态在当前 Key 上的读出。
- (1-βt)S**t-1k**t
旧读出保留 1-βt 的比例。
- βtvt
写入的新值。
所以,当 0≤βt≤1 时,当前 Key 对应的读出,是旧读出与新值之间的加权平均。
查询完全无关的知识
如果我们在存入 k**t 之后,用一个与它正交的查询向量 q 去读取记忆呢?这里的条件是严格的 ktT**q=0,不能直接把语义上的“不相关”当作数学上的正交。
我们再次用 q 去右乘更新后的记忆 S**t:
代入正交条件 ktT**q = 0:
结论:在这个不带额外遗忘门的 DeltaNet 更新中,与当前 key 严格正交的查询读出保持不变;非正交方向仍可能受到干扰。单位 key 下,I-βtktkt**T 在 k**t 方向的特征值为 1-βt,在其正交补空间上为 1,所以旧状态转移的谱范数不超过 1。
对于 GDN/KDA,应把上述推导中的 S**t-1 换成已经衰减的 S̄t。例如 KDA 在 ktT**q=0 时满足的是
一般不等于 S**t-1q。也就是说,正交方向不受本次残差写入影响,但仍会受到遗忘门的作用。KDA 的完整旧状态转移同样不放大:
这里假设 0≤αt,d≤1、0≤βt≤1;当数值保护使 ‖k**t‖2≤1 时,不放大的结论仍成立,但“βt=1 时精确覆写”还需要 ‖k**t‖2=1。
附3:链式法则
假设 s,k,v 都是普通数字,那么损失是:
对 s 求导,要分两层:
- 外层是平方:12x2 的导数是 x。
- 内层是 v-sk:对 s 求导得到 -k。
根据链式法则,把这两部分乘起来:
附4: 哈希粒度
在本文配置中,MLA group 和 4 个 KDA group 的 block_size 都是 640,tail group 不参与 prefix caching 的哈希粒度计算。未设置 --prefix-match-unit 时:
hash_block_size = gcd(640, 640, …) = 640scheduler_block_size = lcm(…) = 640
正文中 1984 的尾部停点和 1216 的分叉点示例,另行假设显式设置了 --prefix-match-unit=64。此时 hash_block_size = 64,而物理 block_size 与 scheduler_block_size 仍为 640;改变的是哈希匹配粒度,不是物理块大小。
group_block_sizes = [ resolve_dcp_kv_block_size(g.kv_cache_spec, dcp) for g in groups]scheduler_block_size = math.lcm(*group_block_sizes)...hashing_sizes = [ block_sizefor group, block_size inzip(groups, group_block_sizes)if group.kv_cache_spec.prefix_cacheable] or group_block_sizesrequested = cache_config.prefix_match_unithash_block_size = requested if requested isnotNoneelse math.gcd(*hashing_sizes)scheduler_block_size | hash_block_size | |
|---|---|---|
| 取值 | 所有 group 的 block_size 的最小公倍数 | 参与 prefix caching 的 group 的 block_size 的最大公约数;如果设置了 prefix_match_unit,就用它 |
| 作用 | 调度器的对齐单位:前缀命中长度、已计算 token 的推进都按它对齐 | 计算 Request.block_hashes 的单位:每满这么多 token 算一个链式哈希 |
| 为什么这样取 | 取公倍数,才能保证在这个边界上每个 group 都正好是整数个 Block,命中后各 group 同时可用 | 取公约数,才能保证每个 group 的 Block 都由整数个哈希单位组成。block_size 较大的 group 每隔 block_size / hash_block_size 个哈希取一个即可(BlockHashListWithBlockSize),哈希只需算一遍 |
附5: 为什么开启 EAGLE/MTP 时,Prefix Cache 命中必须无条件回退一个块(use_eagle_block_drop)?
Draft KV[i] = f(h[i], t[i+1]),每个位置的 draft KV 都用到了下一个 token。最后一个命中块的块尾位置 k−1 用到的是块外的 t[k],但 block hash 只覆盖 t[0..k−1]。如果写缓存的请求 A 和后来的请求 B 在 t[k] 上不一样,这个槽位对 B 来说就是错的。多模块 MTP 依赖得更远,块尾最多有 n−1 个槽位受影响。
- 只有分叉点恰好落在块边界上才会真污染。 设分叉点为 d,命中会停在 k = ⌊d/B⌋·B。只有 d % B == 0 时,t[k] 才是分叉后的 token。不对齐时,t[k] 还在公共前缀里,A 和 B 一致,这个块其实是干净的。
- 调度器不存 t[k],也不存 hidden state,分不出这两种情况,只能按最坏情况处理:无条件回退一个 block(开了细粒度 hash 时回退一个 hash 单位)。
- 共享缓存块是只读的,不能只重写那一个槽位,所以整块重算。
PS prompt 都在缓存里,调度器也要把最后一个 token 重新跑一次前向,因为要拿到它的 logits 才能采样出第一个输出 token。所以命中上限是 num_tokens - 1。又因为命中按块对齐,这个 −1 会造成两种结果:
- prompt 长度不对齐时,最后一个块本来就没满,不会被命中,−1 没有额外损失。
- prompt 长度正好是 block_size 的整数倍时,−1 会让最后一个满块整块命中不了,最后这个 token 所在的整块都要重算。比如完全相同的 prompt 重发一次就是这种情况。