Ember 引擎实现 30B 模型端侧无损推理,缓解存算力错配
无量火科技发布Ember推理引擎,在不修改模型且保持质量无损的前提下,大幅降低内存占用,使30B参数大模型能在手机端运行。该方案旨在解决云端算力溢出导致的存储资源供需矛盾,推动AI向终端迁移。
报道正文
本文目录4 个章节
不用改模型,推理质量无损
克雷西 发自 凹非寺
量子位 | 公众号 QbitAI
大模型证明了自己的价值,代价是把算力资源的供需彻底打乱了。
TrendForce数据显示,从2025年年中到现在,短短一年多,部分DDR5内存的价格涨了近10倍。
原因不复杂,云端大模型的训练和推理吞掉了太多产能。
产能被云端大量消耗之后,需求开始向外溢出,端侧成了承接这场溢出的下一站。
同一时期,手机上能跑的模型也在快速膨胀,从3B涨到了30B+。
模型在变大变强,硬件资源的扩张却始终很慢,存算力资源的错配已经相当严重。
行业不是没有办法。
模型侧在压精度,推理引擎侧在压系统开销,两条路都在往前走。
9月高通骁龙峰会上,无量火科技,一家成立不到一年的中国公司,与高通联合发布了移动端解决方案,展示了它的Ember推理引擎。
这套引擎让手机跑通了30B大模型,模型未经额外改动,砍掉了大部分内存占用,而且推理质量无损。
这场变化不只发生在一家公司,也不只体现为一套引擎。
这标志着,端侧AI正在迎来一段非常长的上涨周期。
存算力错配,端侧的长上涨周期
关于端侧AI的前景,无量火科技CEO王瑜琨有一个看似矛盾的判断。
他认为,存算力资源的供需错配越深,端侧AI的增长空间就越大。
这段时间我们都在目睹,云端大模型对存储资源的胃口变得越来越大,全球DRAM产能已经被吞掉了一大块。
更直接的感受体现在价格上,从2025年年中到现在,内存价格最高涨了近10倍,整体均价也涨到原来的五六倍。推动这一涨幅的主要因素,就是训练和推理对存储资源的持续消耗。
同一时期,端侧模型的参数规模也在快速膨胀,从3B一路推到了30B甚至100B。
模型在膨胀,内存在涨价,矛盾的核心就是模型进化得太快,硬件性能扩张得太慢。
王瑜琨反而从这个矛盾里看到了机会。
他的逻辑是,大模型已经被充分认可,但由于用户体验和成本原因,终端厂商不可能一直靠云端算力来撑。
模型进化和云端算力需求的溢出,会共同促使智能向终端迁移,这个过程会持续相当长的时间。
从终端市场的动作来看,迁移的信号已经出现了。
今年以来,多家厂商的智能体手机扎堆发布,传统手机生态受到了明显冲击。
智能体体验的落地还需要等,但围绕端侧最核心的内存瓶颈,技术上现在已经分出了两条路。
一条从模型侧入手,压低精度;另一条从推理引擎侧入手,在不改变模型的前提下压缩系统开销。
两条路思路不同,但并不互相排斥,也可以叠加。
无量火选择了在推理引擎上做文章。
芯片有人做,模型有人做,中间这层端侧AI基础设施,目前还没有跑出公认的标准。
无量火瞄准的,正是这个空缺。
用AI优化AI,推理引擎走向自进化
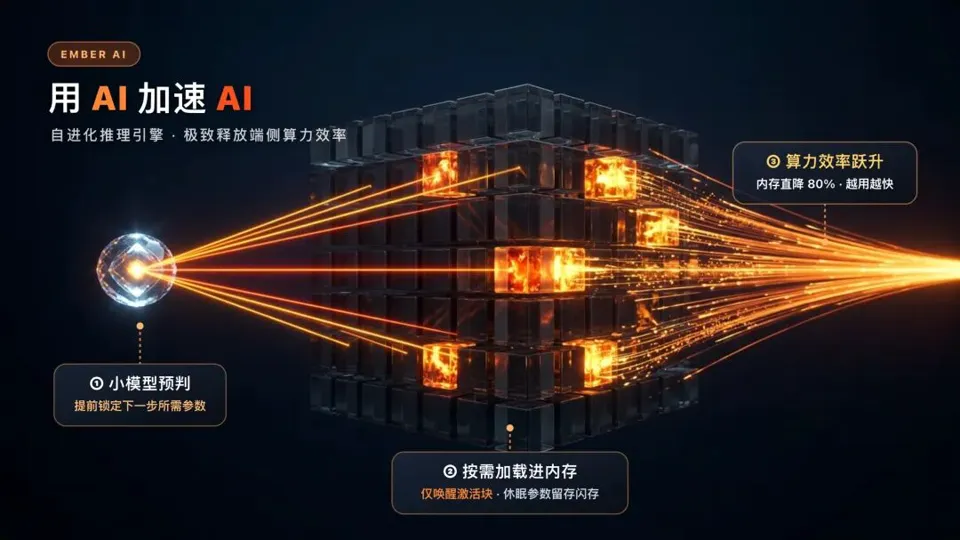
Ember推理引擎的核心思路是预测性部分加载,只把推理真正需要的参数装进内存。
这套引擎的出发点,是很多大模型具备稀疏特性。
以MoE架构为例,模型在生成每个token时只需要激活少数几个专家网络,其余专家处于休眠状态,真正用到的参数量远小于模型全量。
Ember的做法是训练一个轻量预测模型,由这个预测模型提前判断下一步推理需要哪些参数,然后只把这部分从闪存加载进内存,其余参数留在存储中不动。
模型运行时的内存占用因此大幅下降,但推理质量几乎不受影响。
这套逻辑并不局限于某一类模型架构,具有相当的普适性。
这种普适性体现在,它不仅和MoE架构天然适配,也同样适用于Dense模型。
Dense模型的FFN层在推理过程中也存在大量冗余激活,Ember能够将Dense模型改造成类似MoE的运行状态,效果接近原生模型。
无量火的实测数据印证了这条路径的可行性,Ember将MoE模型的内存占用降低了80%,Dense模型降低了50%。
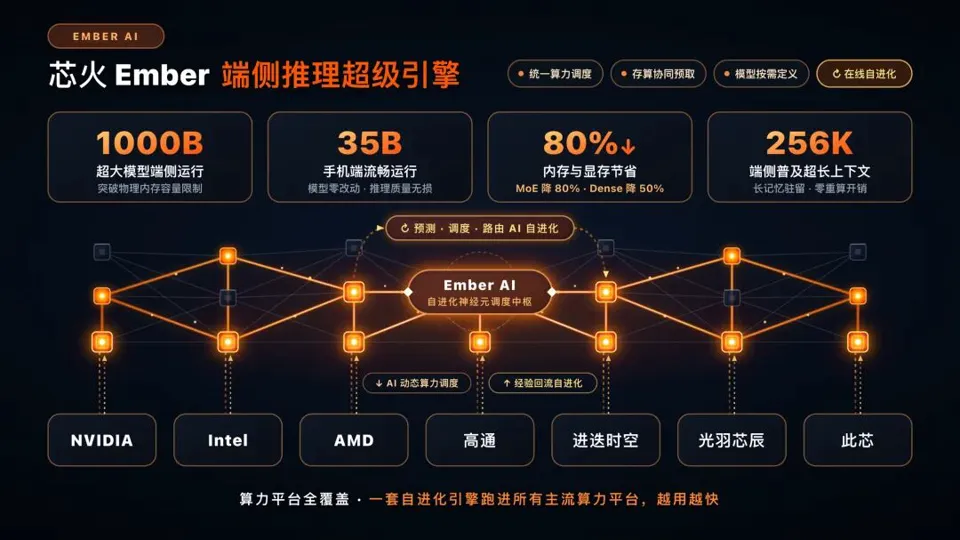
王瑜琨还表示,这些数字还远不是极限,更激进的方案已经在内部推进中。
不过,和传统推理引擎相比,Ember在方法论上有一个关键差异。
传统推理引擎依赖手写的优化规则,Ember在预测、调度、路由等环节大量使用深度学习算法。
这意味着Ember在部署到用户设备之后,可以在运行过程中持续积累优化经验,其推理速度会随着使用而提升。
这些经验还能跨用户共享,引擎的迭代因此具有了网络效应的雏形。
这种用AI优化AI的自进化模式之所以有空间,根本原因在于硬件扩张跟不上模型迭代。
所以需要引入AI充当「空间魔术师」,在有限的物理硬件里闪转腾挪,硬生生把错配的存算资源重新拉回平衡。
王瑜琨认为,AI的加速度还在提高,而硬件资源的扩张始终是最慢的一环,无论CPU、GPU还是内存、闪存。
接下来最值得做的事,就是极致发挥这些部件的性能。 AI会抛弃过去几十年构建起来的大量中间层,完全重构整个软件生态。
沿着这个判断,无量火在Ember推理引擎之上又往前走了一步,做了一套AI原生的操作系统,叫FlareOS。
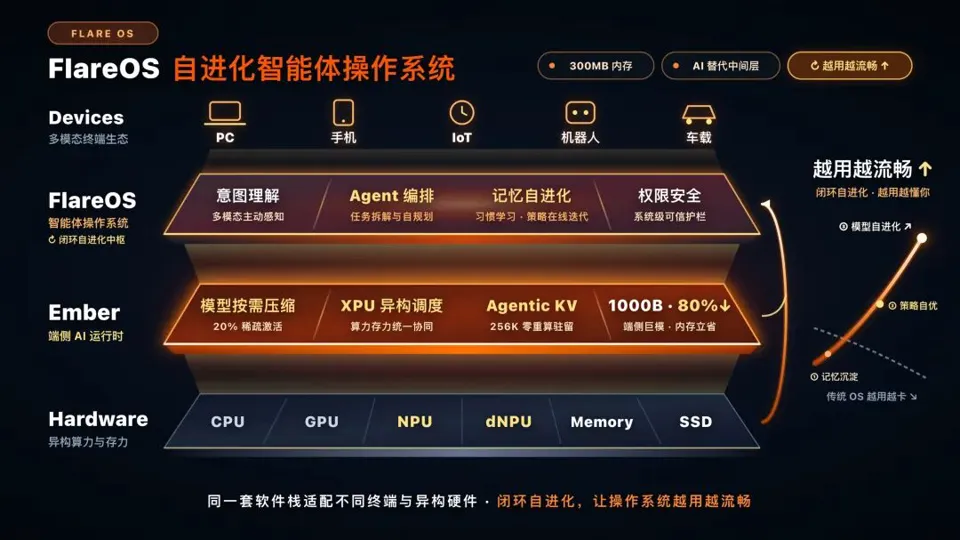
FlareOS基于Ember打造,仅用300MB出头的运行内存就能撑起完整的操作系统、大模型和多个Agent同时运行,其内存占用仅为传统操作系统的十分之一。
传统操作系统在几十年的演进中堆叠了大量抽象层和中间件,FlareOS用AI手段替代了其中很多环节,把释放出来的资源留给了智能运算。
在王瑜琨看来,推理引擎和操作系统最终都会走向「智能软件」阶段,软件在闭环逻辑内自行进化,不再依赖工程师的手工迭代。
传统软件越用越卡,AI原生软件可以越用越快,这是两者的根本差别。
先占位置,再铺开生态
技术方案得到验证之后,无量火要解决的下一个问题是落地速度。
得益于团队早期在PC和手机端打下的深厚性能底子,以及在MoE方向上的超前探索,无量火很快与上游芯片厂商在技术路线上达成合拍,商业化落地由此进入快车道。
从时间线来看,无量火的推进节奏确实紧凑。
公司设立在素有「中国硅谷」之称的上海浦东张江,那里有密集的半导体上下游产业生态,促成了无量火的飞速破局。
成立百天时,无量火便与多家头部算力平台达成实质合作; 同时作为唯一的初创企业入选中国信通院创新实践汇编,成为浦东新区Al Infra标杆企业。
成立不到半年,无量火便作为全场唯一的中国初创企业,登上高通骁龙峰会主题演讲舞台,联合发布了突破性的端侧推理方案。
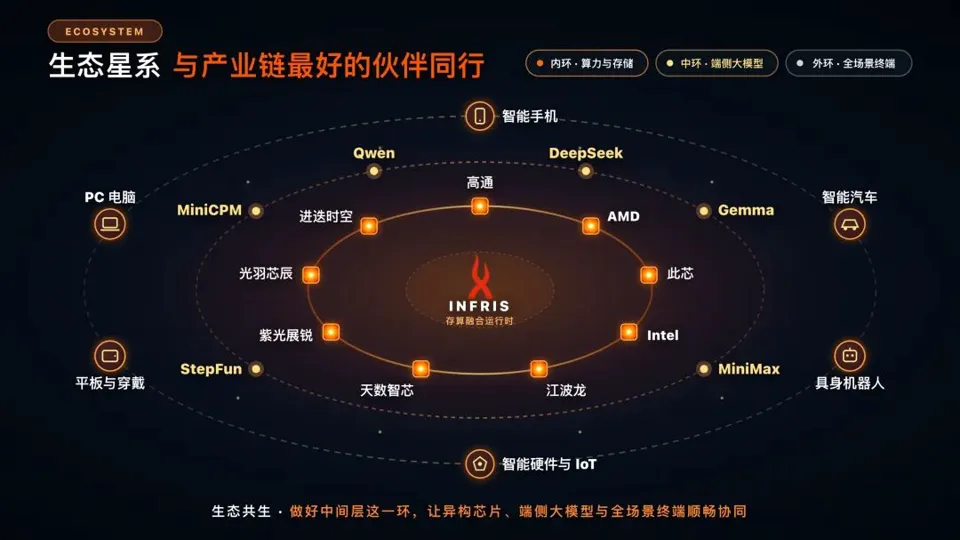
骁龙峰会之后,Ember的芯片适配进一步铺开,目前已覆盖国内外十余家主流算力平台,OEM合作伙伴涵盖了多家头部终端厂商。
但是,覆盖面铺开了,先发优势能撑多久?
王瑜琨的回答是「靠速度拉开身位,用生态锁死壁垒」。
要拉开身位,核心是让引擎进化的速度,持续跟上模型的迭代速度。
无量火敢这么说,底气来自其团队底座。
其核心创始团队均来自芯片与互联网产业界一线,工程功底扎实,对行业痛点抓得极准,落地思路清晰;同时,公司内部崇尚极客文化,从第一天起就采用AI原生的方式运转。
对AI的坚定信仰加上高度精准的投入,不仅让无量火跑出了极高的进化速度,也支撑着他们走向一个更大的目标——
不止于做一套推理引擎,还要做更底层的「智能系统」,让软件真正实现自进化。
眼下,速度与生态正在帮无量火筑起这道护城河。主流开源模型的架构大约半年就会经历一次大变样,注意力机制在迭代,新的结构不断被引入……
每一次架构变化都对推理引擎的适配能力提出新的要求,在这样的节奏面前,跟不上的推理引擎会被甩出去。
反过来,当一套引擎跑进足够多的芯片和终端之后,适配数据和优化经验会沉淀成产业级的生态。
后来者如果想要追赶,要跨过的是一整个生态位。
无量火的下一个关键节点是2027年1月的CES,届时将联合其合作伙伴发布FlareOS软硬一体化产品。
再往远看,存储和内存技术正在催化端侧算力的又一轮跃升。
DRAM的3D堆叠技术能将端侧带宽提升到传统SoC的十倍左右,闪存侧的HBF技术也能提供相当于传统Flash十多倍的带宽。
在这些上游技术的支撑下,王瑜琨预计「明年100B的模型就能在手机上流畅运行」。
如果这条路走通,从手机到车载到机器人,每一台终端上都可能跑着一套自进化的智能系统。
我们正步入智能奇点时代。伴随存算架构的快速迭代,以Token为载体的智能洪流奔涌而至。
一如无量火的使命——让智能,没有边界。
MoE大模型在手机上的落地,仅是序章;智能的终局,是万物泛在、无远弗届。
一键三连**「点赞」「转发」「小心心」**
欢迎在评论区留下你的想法!
— 完 —
🌟 点亮星标 🌟
科技前沿进展每日见