玩家用停产傲腾内存跑通 2.8 万亿参数 Kimi K3
一名 Reddit 网友在无显卡的家庭实验室环境中,借助已停产的英特尔傲腾持久内存 200 系列与 llama.cpp,成功加载并推理 2.8 万亿参数的月之暗面 Kimi K3 模型。在 1 比特量化下,关闭 DAX 并让热数据走 DRAM 缓存后,输出速度从每秒 0.85 词元提升至 1.5 词元,3 比特量化则仅 0.75 词元,生成 5 万词元需约 18.5 小时。该实验证明超大模型可完全依赖内存层级而非 GPU 显存运行,但速度远不具备实用价值。
报道正文
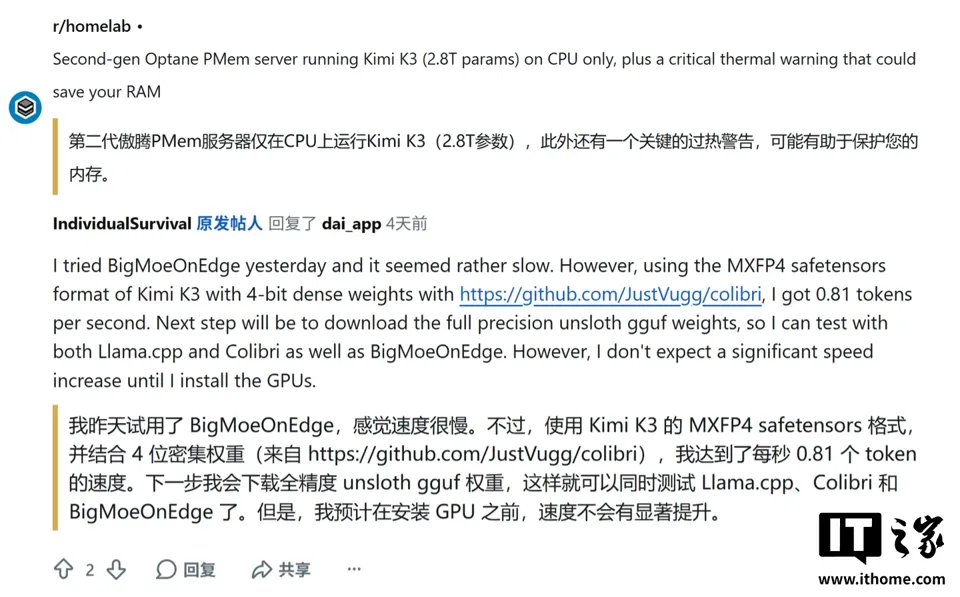
IT之家 11 月 13 日消息,网友 u/IndividualSurvival 于 11 月 2 日在 Reddit 社区发帖,分享了一项家庭实验室尝试,在不配备显卡的情况下,使用已停产的英特尔傲腾持久内存,成功运行 2.8 万亿参数的月之暗面 Kimi K3 模型。
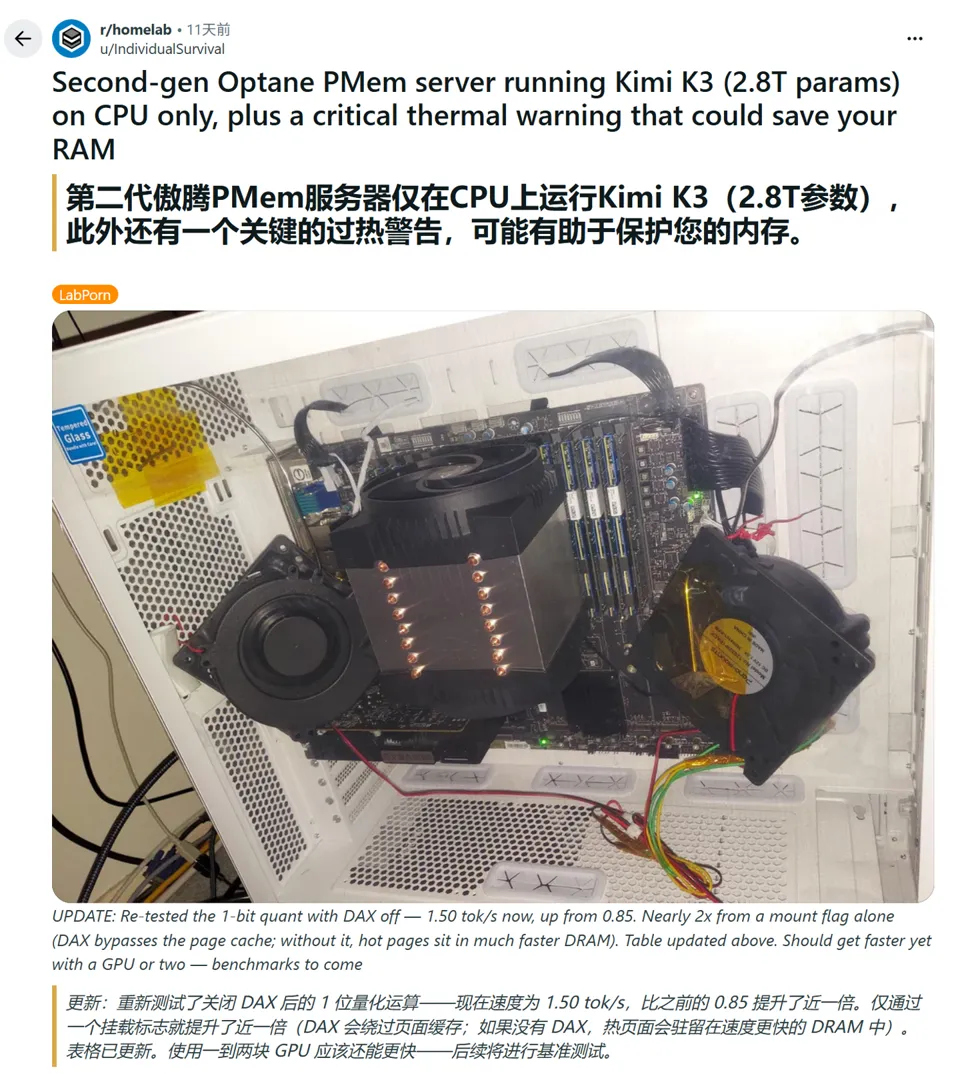
IT之家注:“傲腾”(Intel Optane)是一套基于 3D XPoint 的内存与存储产品技术,是英特尔与美光共同开发的非易失性存储技术。该网友使用傲腾持久内存 200 系列,外形和安装方式接近服务器内存条,单条提供 128GB、256GB 和 512GB 三种容量,针对第三代至强可扩展处理器平台设计。
在配置方面,该网友使用 40 核第三代英特尔至强可扩展处理器(原文并未明确具体规格),以及傲腾持久内存 200 系列(原文并未明确具体容量),并使用 App Direct 模式(DRAM 和傲腾作为两个独立的数据空间呈现给软件)测试,并使用 llama.cpp 软件执行推理。
不过该项目依然只是测试项目,词元(Token)输出速度方面并不流畅。报道显示,采用 1 比特量化、压缩模型数据后,初始生成速度约为每秒 0.85 个词元;关闭直接访问功能 DAX、让常用数据受益于 DRAM 缓存后,速度提升至每秒 1.50 个词元。另一项 3 比特量化测试仅达到每秒 0.75 个词元,生成 5 万个词元约需 18.5 小时。