Qwen-RobotNav 发布:统一五类导航任务,实现智能体驱动零样本泛化
阿里通义千问团队推出 Qwen-RobotNav,基于 Qwen3-VL 构建的规模化通用导航模型。该模型通过参数化接口统一管理视觉上下文,在单一权重下同时达成 VLN、目标搜索、跟踪、自动驾驶及具身问答(EQA)五大领域的 SOTA,并支持无需重训即可适配任意推理配置的智能体系统部署。
报道正文
本文目录7 个章节

搭建智能体驱动的导航系统需要一个可配置上下文内容管理的通用导航模型。指令跟随、物体搜索、目标跟踪和自动驾驶等任务虽然共享相同的感知-规划骨干网络,却需要截然不同的视觉信息处理策略。正如大模型工具调用中的模型上下文协议(MCP)为不同工具提供了统一接口,导航模型同样需要一套标准化的接口,在推理时灵活管理多样化的上下文需求。

我们提出了 Qwen-RobotNav,一个基于 Qwen3-VL 构建的规模化导航模型。它通过参数化接口从两个互补维度解决上述问题:任务模式决定导航行为,可控的观测参数(token 预算、时间衰减、相机权重)则决定视觉历史的编码方式。模型在 1560 万条样本上进行训练,在单一权重下统一五类任务,无需修改架构即可泛化到任意推理时配置,适配智能体系统。
核心亮点:
5大领域 8项SOTA单一模型统一 VLN、ObjNav、 Tracking、Driving 与 EQA上下文 即接口视觉信息管理 零架构修改智能体 驱动导航即工具调用+双层记忆 迈向EQA新时代真实世界零样本泛化单相机、开放环境 零样本真机部署
- 统一多域导航: 单一模型、单组权重,在 5 个导航领域达到 SOTA:VLN-CE RxR 76.5% SR、HM3Dv2 目标搜索 75.6% SR(仅 RGB,超越所有深度方法)、EVT-Bench 90.0% 跟踪率、NAVSIM 91.4 PDMS,以及 3 个 EQA 基准新纪录。随着模型参数量增加性能一致提升。
- 可控观测协议: 四个(视觉词元预算、时间衰减、逐相机权重、帧采样模式)可控参数在训练时逐样本随机化,使其无需重新训练或修改模型架构即可适配任意推理配置。
- 智能体导航系统: 作为长短期记忆系统中可配置的导航动作执行单元,上层规划器(Qwen3.7-Plus)分解长时序目标并调度可配置的导航调用,配合双层记忆机制 — 在 EXPRESS-Bench 上提升 15.4%,导航步数减少 77%。
- 开放环境泛化: 在 Unitree Go2 四足机器人上零样本部署,仅使用机器人自带的低分辨率相机,在开放真实环境与自由自然语言指令下展现出强大的泛化能力,无需任何环境特定微调。
可控上下文的导航模型#
移动导航涵盖了需求差异极大的任务类型。指令跟随需要对历史观测保持长期记忆,以回溯参照远处的地标;目标跟踪几乎只关注最近几帧的信息;物体搜索则在探索阶段需要长程的历史信息,而在接近目标的阶段需要紧凑的近期窗口。
现有的统一导航模型对"该记住什么"嵌入了固定假设。Qwen-RobotNav 的做法不同,它将上下文视为可由外部自由控制的部分,提供四个控制参数供智能体在每次调用时灵活调节:
- 视觉词元预算:所有视觉信息和历史信息的词元总量
- 时间衰减:近期帧相对于较早帧的权重偏好程度
- 相机权重:各相机的重要性权重(例如前向相机比后向相机更重要)
- 帧采样模式:随机采样以覆盖全局历史,或选取最新帧以构建紧凑的近期窗口
训练时,这些参数在每个样本中均被随机化,模型从未见过固定配置,因此能够泛化到推理时的任意设置。
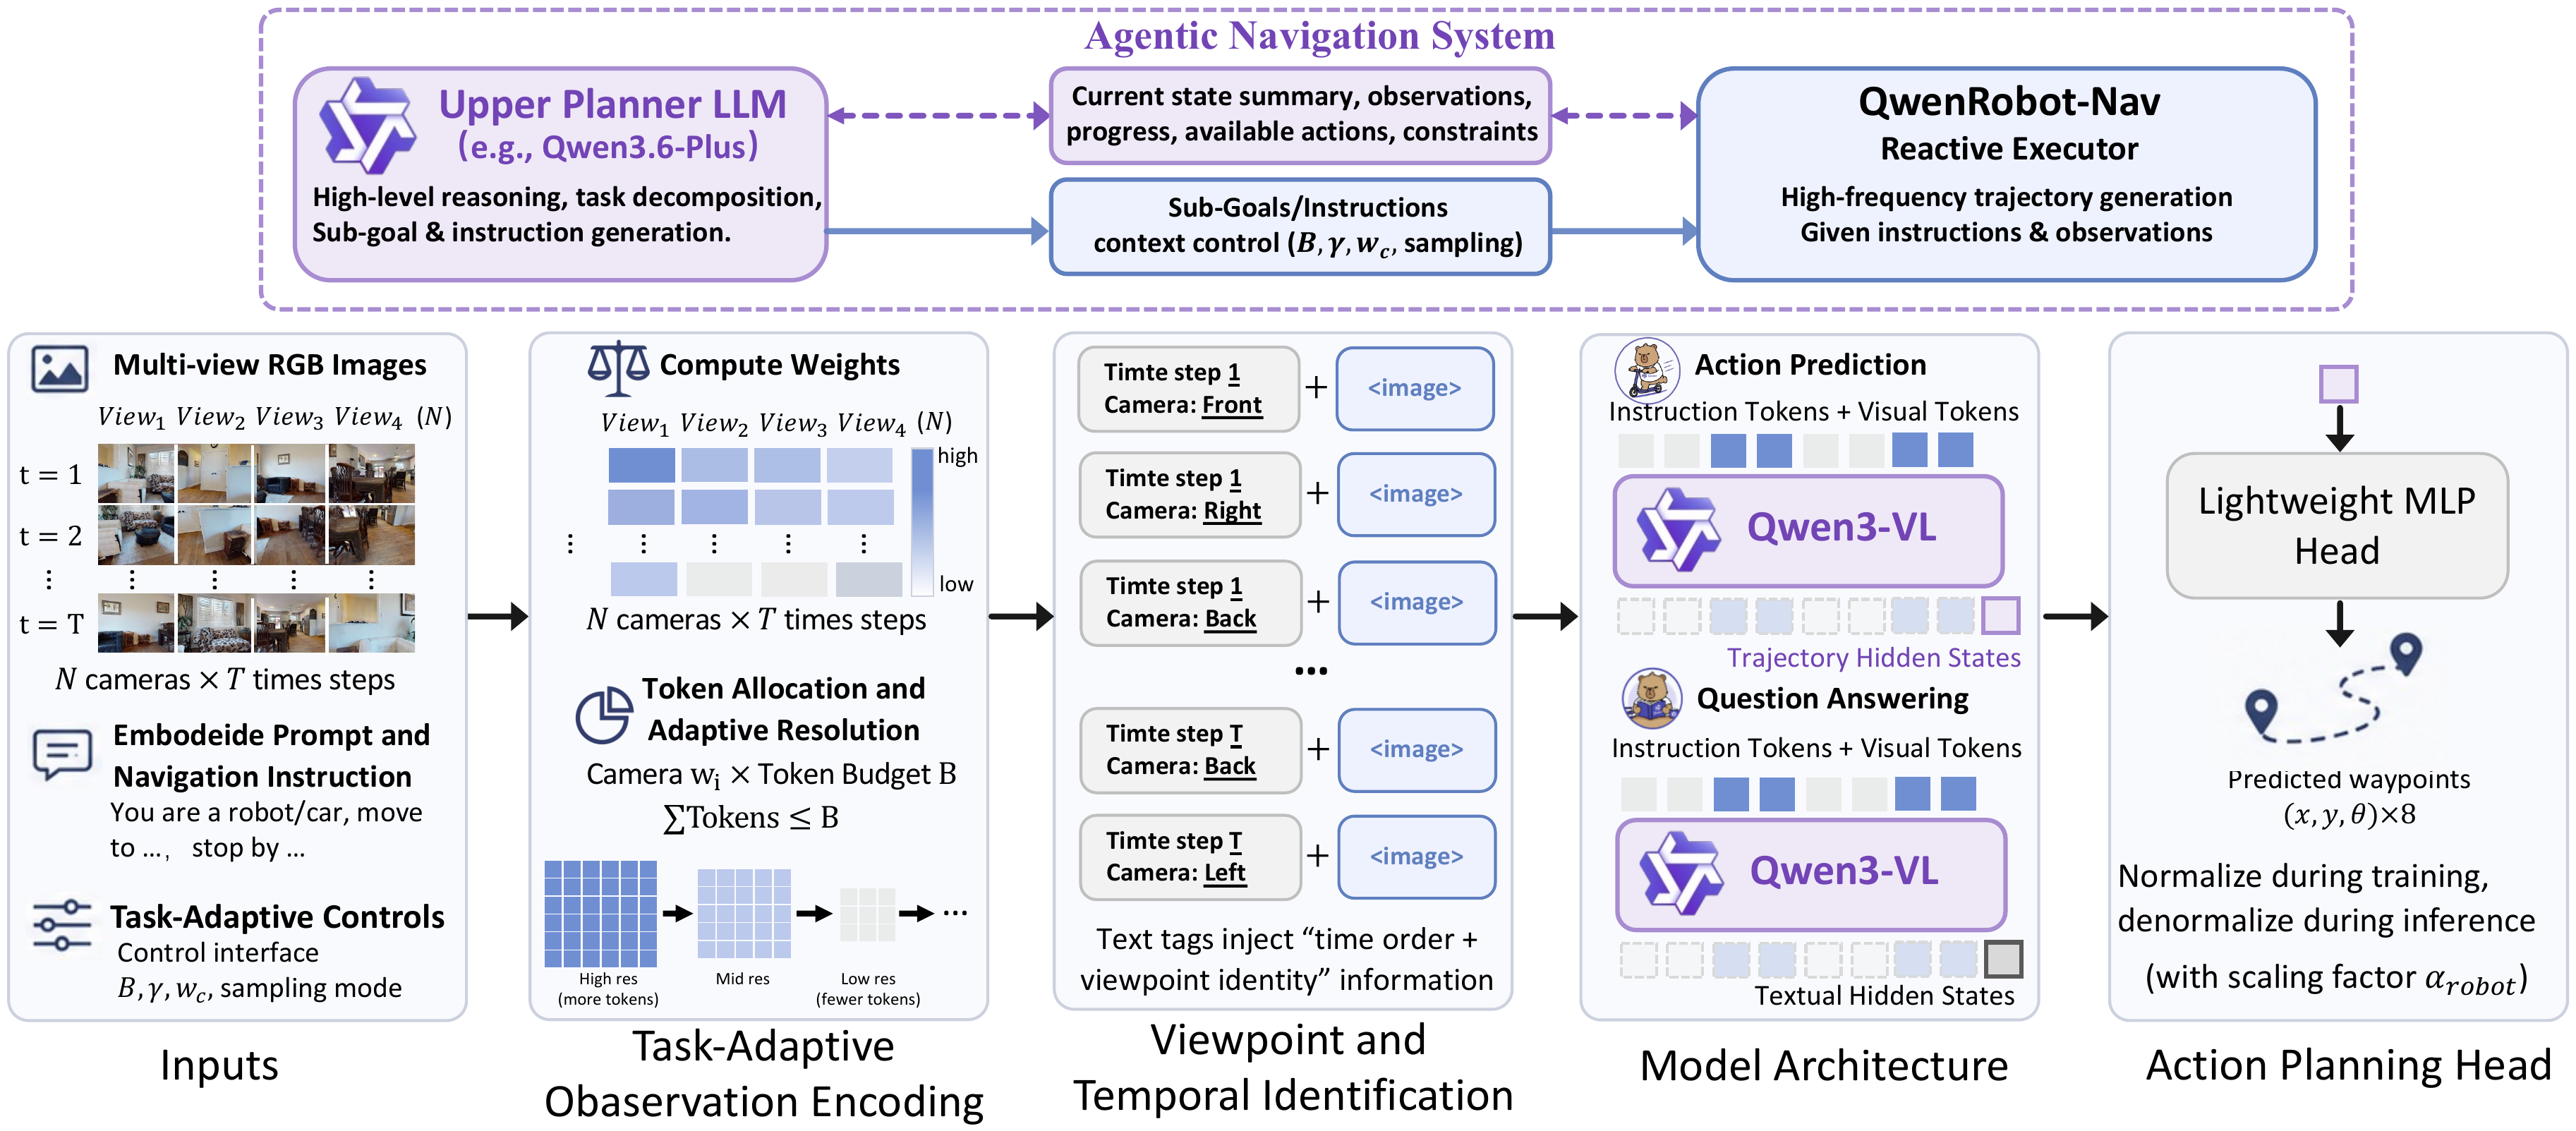
架构。 Qwen-RobotNav 继承 Qwen3-VL 骨干网络,并添加了一个轻量的 4 层 MLP 动作头,输出 8 个路径点(每个包含位置和朝向)。相机标识和时序信息完全通过与视觉词元交错的自然语言标签来传达:
Time step 0 Front View <image> Front Right View <image> ...
Time step 1 Front View <image> ...为智能体导航而设计#
Qwen-RobotNav 被设计为双层导航系统中的可重配置的导航基础模型。上层规划器(Qwen3.7-Plus)负责将长时序目标分解为子目标,Qwen-RobotNav 则作为灵活的导航规划模型来执行每一段导航。
智能体可在不同阶段中动态切换 Qwen-RobotNav 的任务模式和上下文策略。两层之间完全通过自然语言通信,系统因此保持高度的模块化和可扩展性。
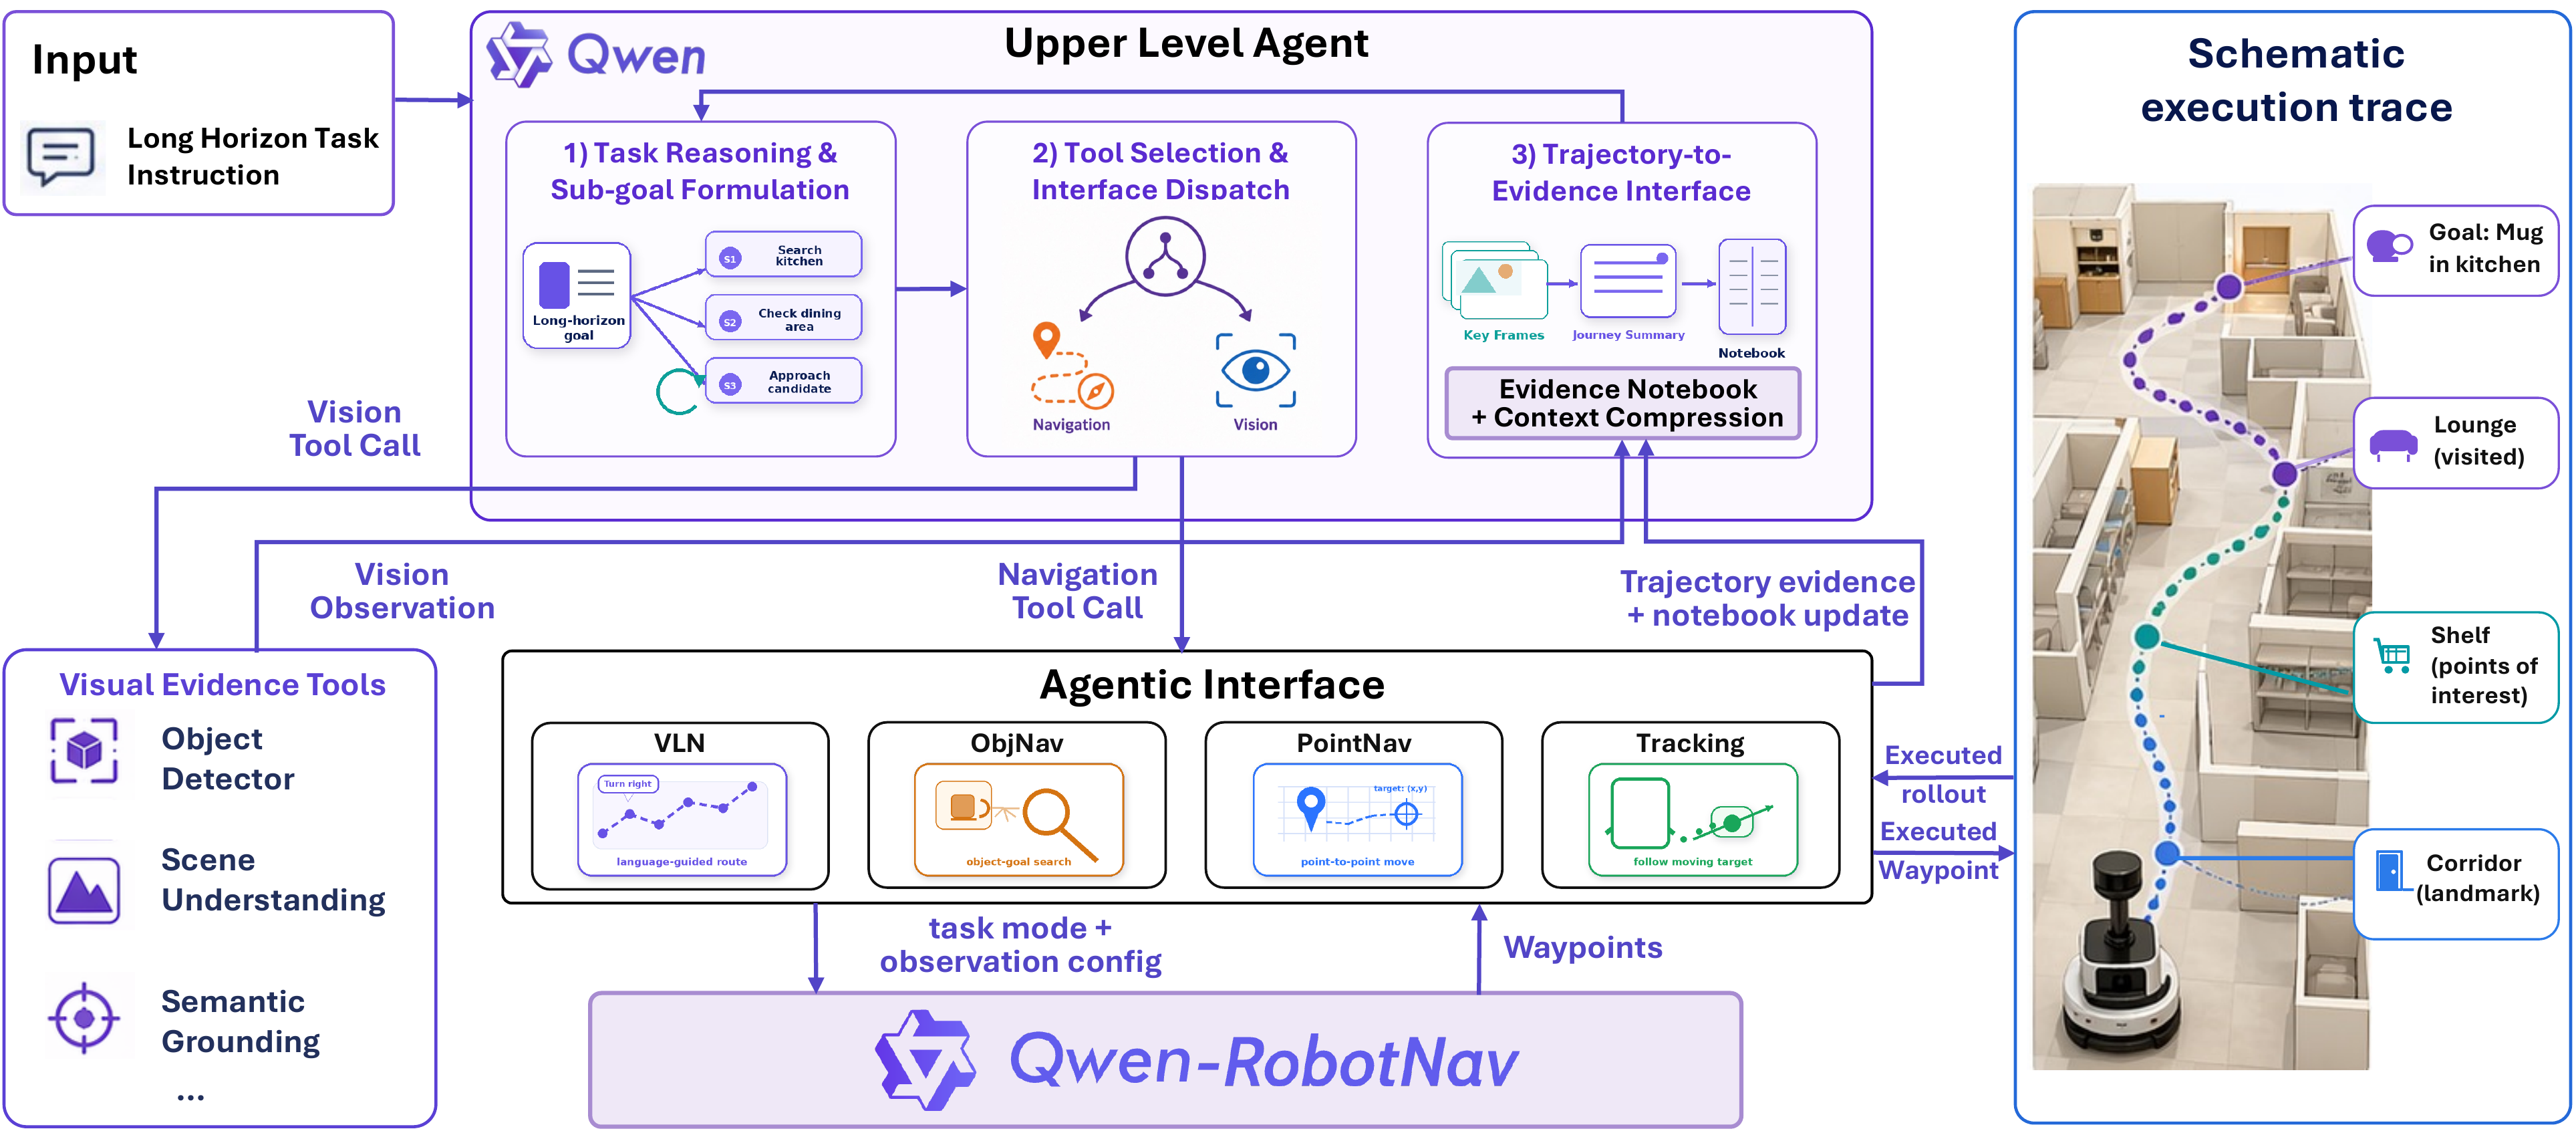
每次导航调用需指定三项内容:子目标指令、任务模式(VLN / PointNav / ObjNav / Tracking)以及观测配置。同一套模型权重服务于所有任务阶段,变化的只是调用参数。
为支持长时序推理,系统维护了两级记忆结构。每段导航过程结束后会压缩轨迹信息作为短期记忆;一个长期维护的笔记本则在多个回合间积累持久性结论(已搜索区域、候选物体位置、已排除的假设),确保规划器始终基于精简且相关的上下文进行决策。
大规模训练#
Qwen-RobotNav 在 1560 万样本上训练,覆盖五类任务,同时使用视觉-语言推理数据来保持骨干网络的感知能力。性能随参数量从 2B 到 8B 持续提升,在长时序推理任务上的增益最为显著。
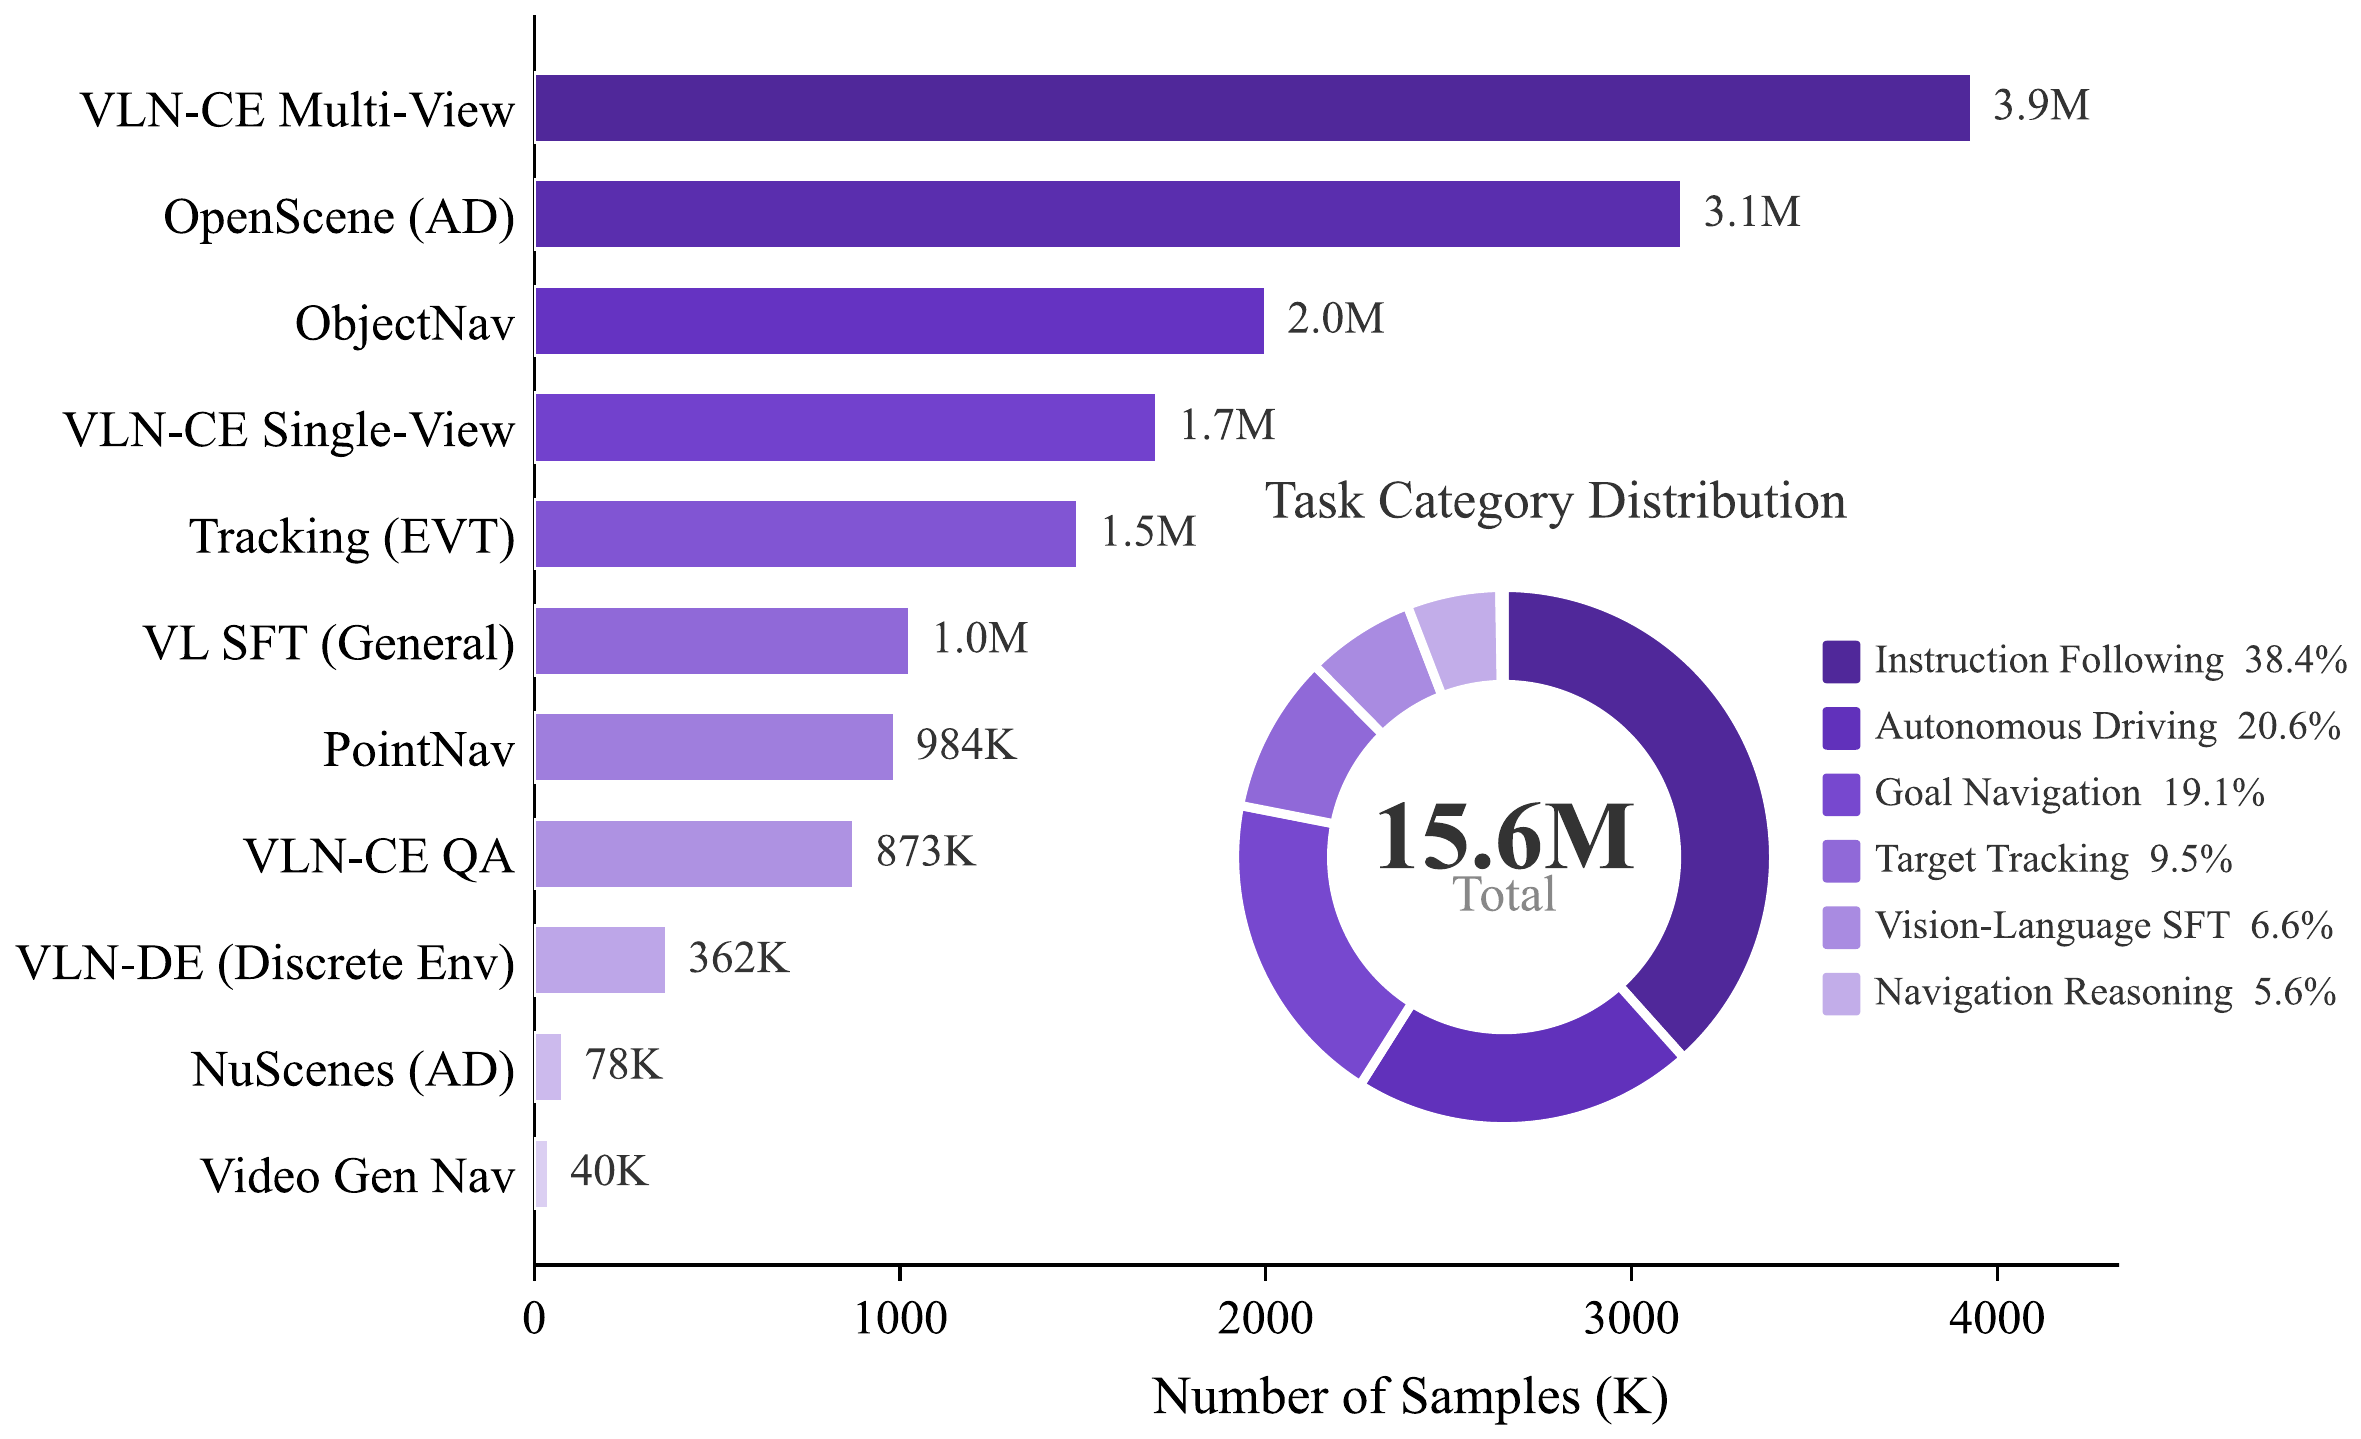
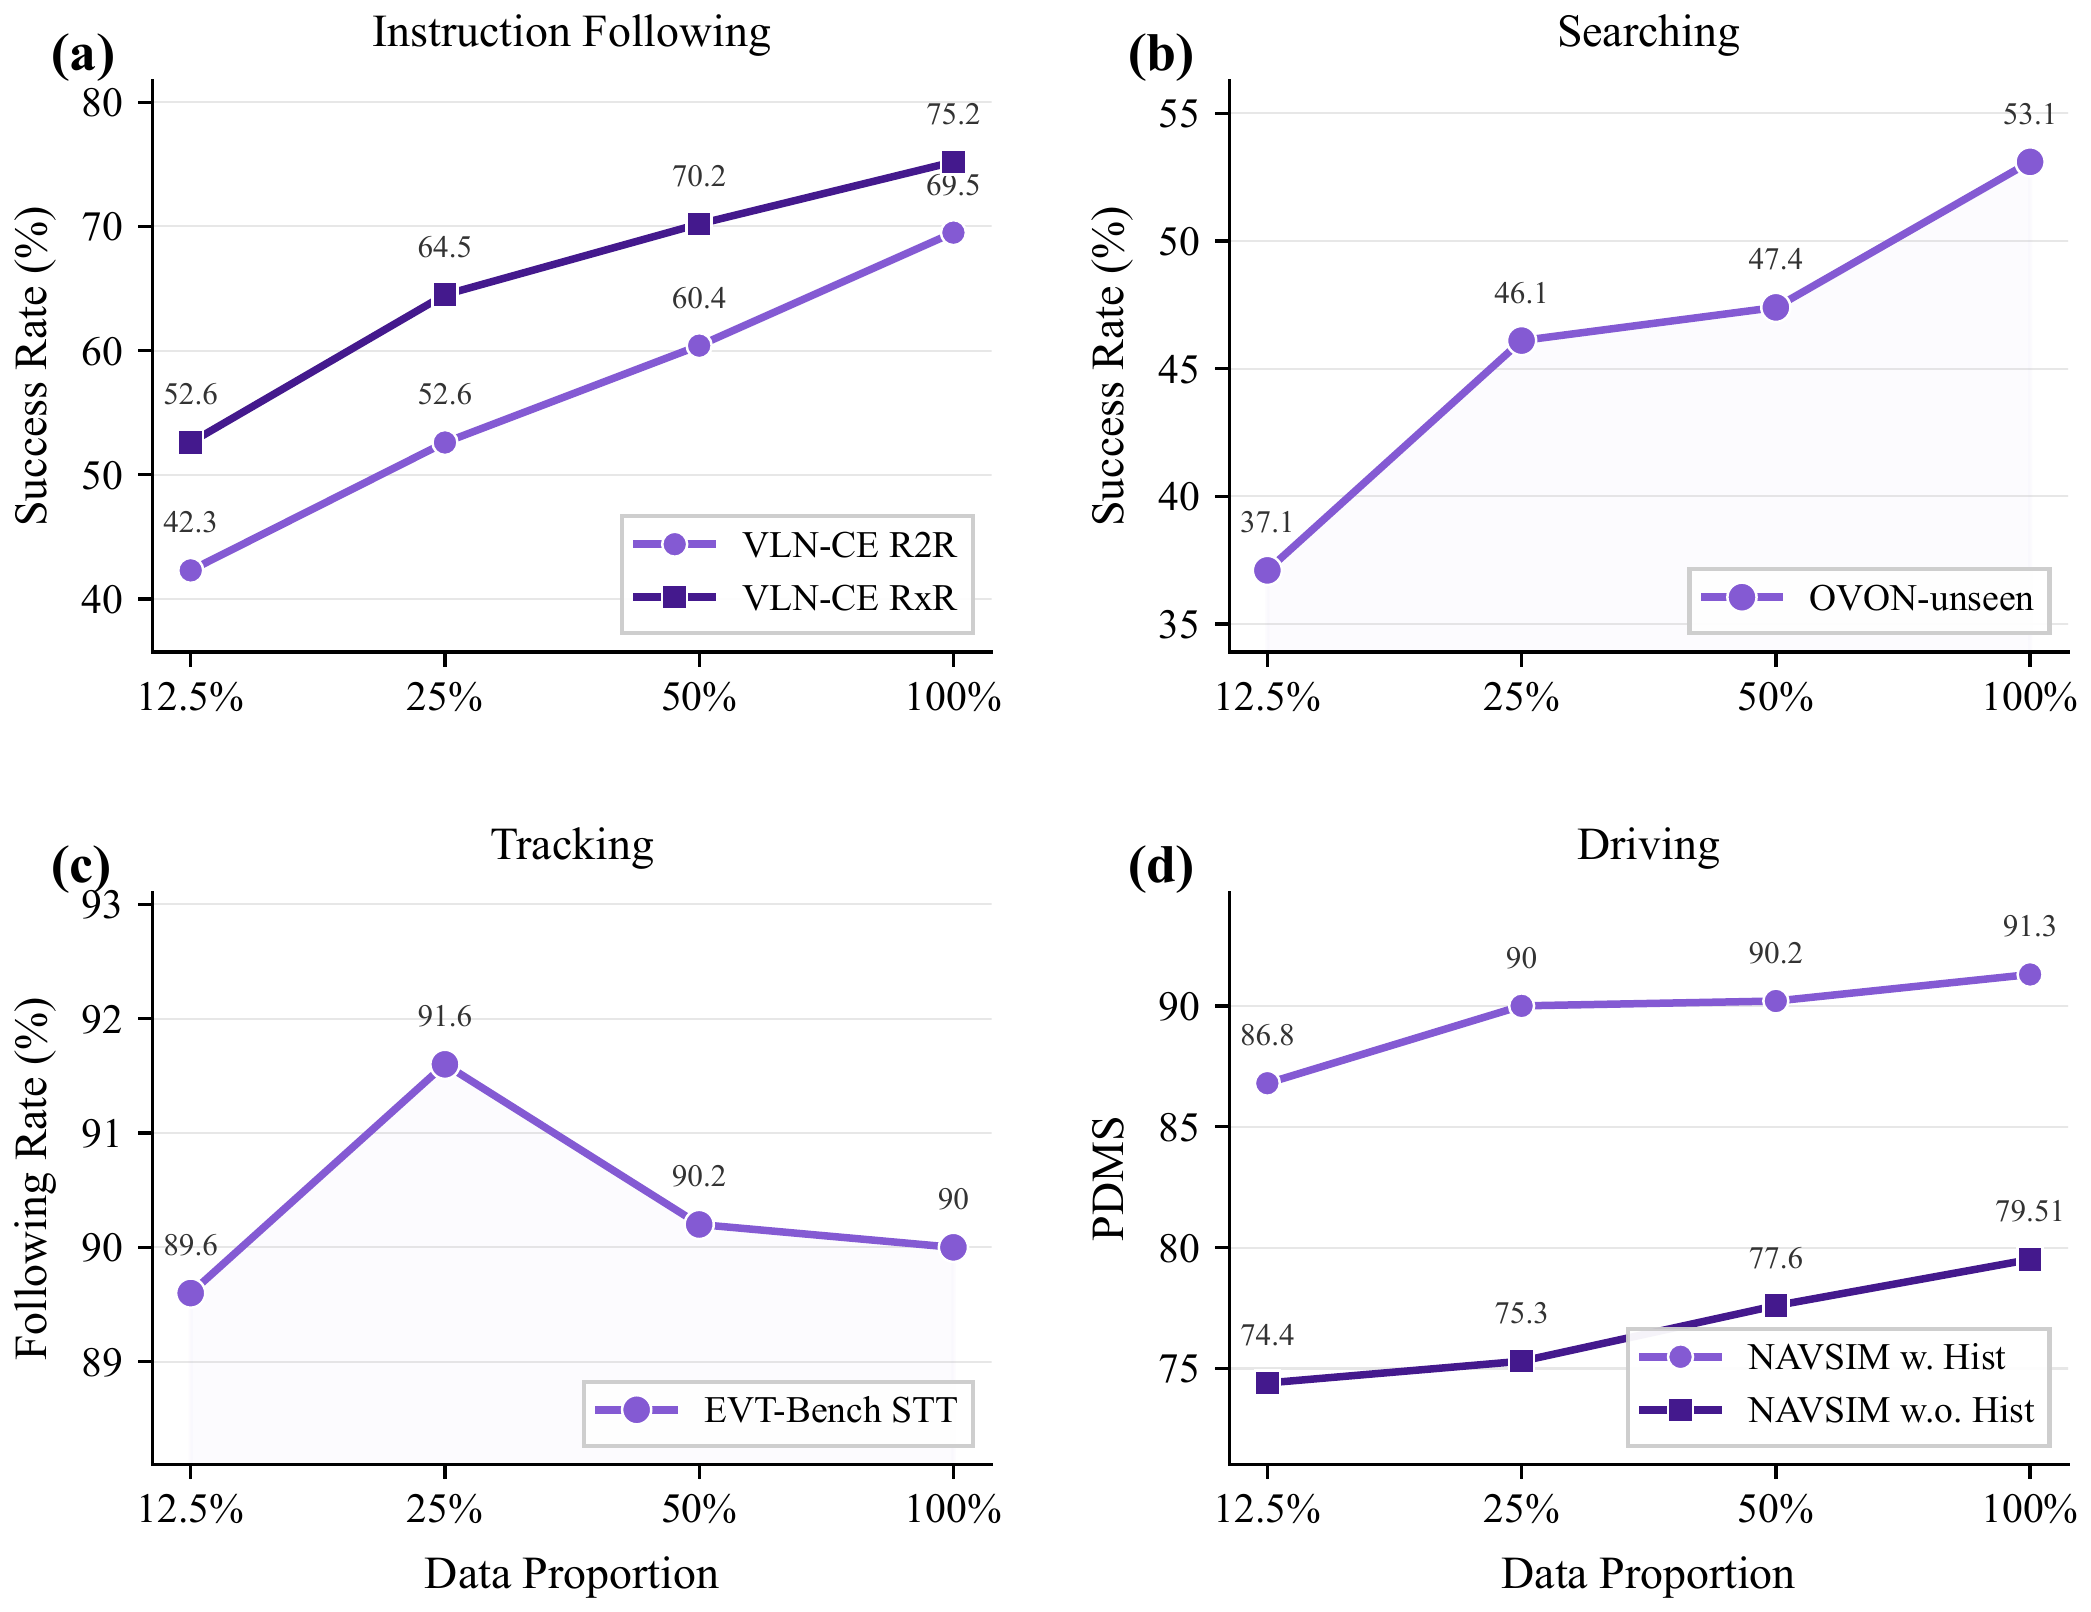
我们还提出了一条自动化流水线,通过提示词生成、视频合成、VLM 质量过滤、单目深度估计和运动学过滤,将文生视频的输出转化为导航轨迹,无需 3D 场景重建即可产出 4 万条高质量仿真样本。
性能表现#
指令跟随(VLN-CE)
R2R 和 RxR validation-unseen 分割上 VLN 成功率的发展趋势。传统方法在早期取得了稳步进展,而近期基于 LLM/VLM 的方法推动了最新的性能提升,其中 Qwen-RobotNav 在两个基准上均达到了最高成功率。
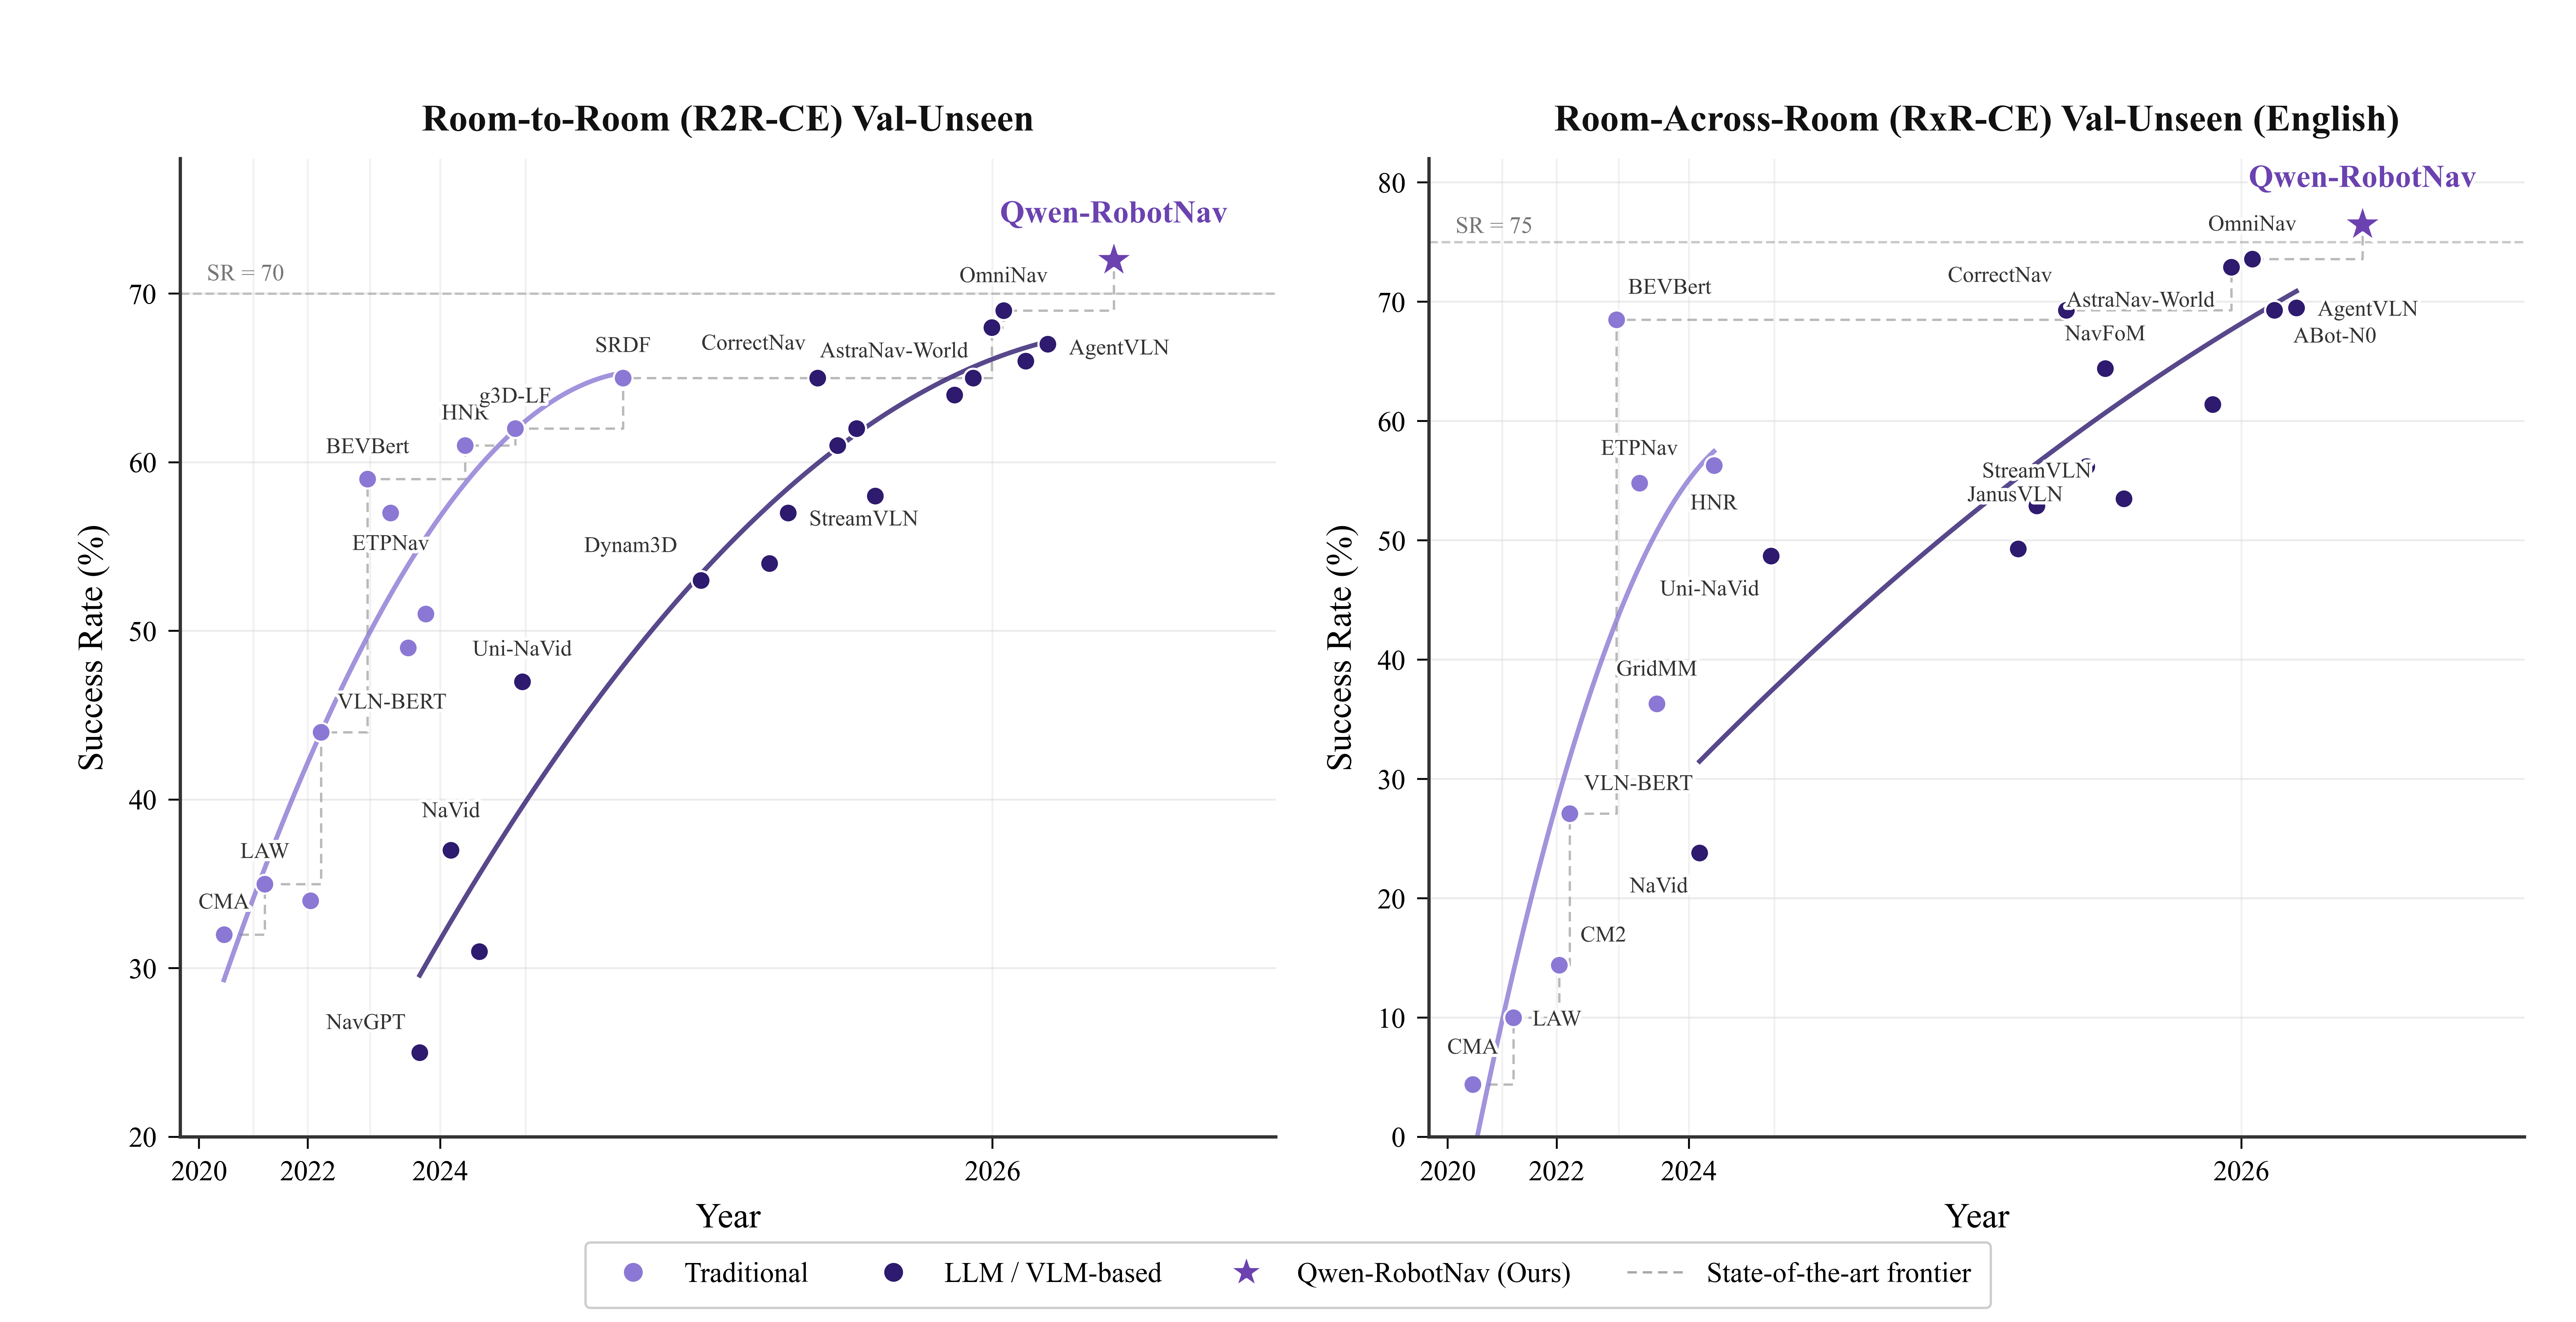
Qwen-RobotNav-8B 在 R2R 上达到 72.1% SR,在更长时序的 RxR 基准上达到 76.5% SR,全面超越了此前的最优方法。
| 方法 | R2R SR↑ | R2R SPL↑ | RxR SR↑ | RxR SPL↑ |
|---|---|---|---|---|
| NaVILA | 54.0 | 49.0 | 49.3 | 44.0 |
| NavFoM | 61.7 | 55.3 | 64.4 | 56.2 |
| ABot-N0 | 66.4 | 63.9 | 69.3 | 60.0 |
| OmniNav | 69.5 | 66.1 | 73.6 | 62.0 |
| Qwen-RobotNav-4B | 69.5 | 63.6 | 75.2 | 65.0 |
| Qwen-RobotNav-8B | 72.1 | 66.6 | 76.5 | 65.7 |
物体搜索
在 HM3Dv2 物体目标导航任务上,Qwen-RobotNav-4B 仅使用 RGB 观测即达到 75.6% SR,超越了所有使用深度信息的方法,平均到达目标距离仅 1.72m。
| 方法 | SR↑ | SPL↑ |
|---|---|---|
| VLFM | 52.5 | 30.4 |
| CogNav | 72.5 | 26.2 |
| Uni-NaVid | 73.7 | 37.1 |
| Qwen-RobotNav-4B | 75.6 | 30.6 |
| Qwen-RobotNav-8B | 71.2 | 33.0 |
主动视觉跟踪
在 EVT-Bench 上,Qwen-RobotNav 以 90.0% 的跟踪率领先,超越了专用跟踪器和通用模型。
| 方法 | TR↑ | CR↓ | SR↑ |
|---|---|---|---|
| TrackVLA++ | 81.0 | 2.10 | 86.0 |
| NavFoM | 80.5 | — | 85.0 |
| ABot-N0 | 87.6 | 8.54 | 86.9 |
| Qwen-RobotNav-4B | 90.0 | 6.40 | 77.4 |
| Qwen-RobotNav-8B | 89.7 | 5.70 | 78.6 |
搭配智能体系统后,Qwen-RobotNav 在三个 EQA 基准上均刷新了最优结果,大幅领先此前的方法。
| 方法 | HM-EQA Acc.↑ | MT-EQA Acc.↑ | EXPRESS LLM Score↑ |
|---|---|---|---|
| Explore-EQA | 58.4 | 36.2 | — |
| Memory-EQA | 61.4 | 43.1 | — |
| FAST-EQA | 69.2 | 50.5 | 68.7 |
| Qwen3.5-Plus + QwenNav-8B | 74.1 | 52.1 | 77.66 |
| Qwen3.6-Plus + QwenNav-8B | 76.7 | 54.4 | 79.27 |
自动驾驶(NAVSIM)
在闭环驾驶评测中,Qwen-RobotNav-4B 达到 91.4 PDMS,超越了专用驾驶模型。
| 方法 | NC↑ | DAC↑ | TTC↑ | Comf.↑ | EP↑ | PDMS↑ |
|---|---|---|---|---|---|---|
| NavFoM | 97.7 | 93.5 | 92.3 | 100 | 79.6 | 84.3 |
| AutoVLA | 98.4 | 95.6 | 98.0 | 99.9 | 81.9 | 89.1 |
| ReCogDrive | 97.9 | 97.3 | 94.9 | 100 | 87.3 | 90.8 |
| ReflectDrive | 97.7 | 99.3 | 93.5 | 100 | 86.9 | 91.1 |
| Qwen-RobotNav-4B | 99.8 | 97.5 | 98.5 | 99.9 | 84.4 | 91.4 |
| Qwen-RobotNav-8B | 99.8 | 96.9 | 98.2 | 99.9 | 84.2 | 90.9 |
Qwen-RobotNav 在 NAVSIM 和 AlpaSim 闭环仿真器(零样本)中均能生成时序一致的平滑弯曲轨迹。
真实世界部署#
我们将 Qwen-RobotNav 部署在宇树 Go2 四足机器狗上,通过 NVIDIA Jetson Thor 进行端侧推理,延迟仅 196ms(5.1 Hz)。唯一的视觉输入为 Go2 自带的低分辨率摄像头。所有实验均在未见过的环境中零样本完成,无需任何针对特定环境的微调。
部署
机器人在公寓环境中根据逐步语言指令执行导航任务,在卧室、客厅和浴室之间穿行,并响应细粒度的空间指令。
指令跟随
我们在一个未见过的展厅中测试了往返导航任务:机器人先按照语言指令从客厅导航 21.78 米到达病房,随后接收反向指令并精确原路返回。这一任务极具挑战性,要求模型在长距离上保持空间感知、在正反两个方向上锚定多样化的视觉地标,并纯粹依靠语言指令实现精确的双向位置控制。
智能体导航
在智能体模式下,系统能够处理超越简单路线跟随的开放式请求。例如,给定指令"检查 Cotti 咖啡店是否遗落了一把绿色雨伞",智能体会自动将任务分解为子目标,利用走廊地标进行定位和导航,检查目标场景,并在无需人工干预的情况下给出基于证据的回答。
智能体导航:自主前往 Cotti 咖啡店检查绿色雨伞。
展望#
Qwen-RobotNav 将多任务导航重新定义为上下文建模问题:不同任务共享相同的感知和规划骨干网络,但需要不同的观测处理策略。将上下文作为可外部控制的接口,使单一模型能够成为智能体系统中实用、可部署的导航原语。
引用#
@article{qwenrobotnav2026,
  title={Qwen-RobotNav: A Scalable Navigation Model Designed for an Agentic Navigation System},
  author={Qwen Team},
  year={2026}
}