Hugging Face Hub 集成 Stable-Baselines3
Hugging Face 宣布将主流深度强化学习库 Stable-Baselines3 接入其模型托管平台。用户现可通过 huggingface_sb3 库上传、分享及加载社区训练好的 RL 智能体模型,简化了强化学习模型的版本管理与协作流程。
报道正文
本文目录8 个章节
欢迎 Stable-baselines3 加入 Hugging Face Hub 🤗
发布于 2022 年 1 月 21 日 在 GitHub 上更新 点赞 - Thomas Simonini ThomasSimonini
在 Hugging Face,我们致力于推动深度强化学习(Deep Reinforcement Learning)研究人员和爱好者生态系统的建设。因此,我们很高兴地宣布已将 Stable-Baselines3 集成到 Hugging Face Hub 中。
Stable-Baselines3 是最受欢迎的 PyTorch 深度强化学习库之一,它使得在各种环境(如 Gym、Atari、MuJoCo、Procgen 等)中训练和测试智能体变得轻松便捷。通过这一集成,你现在可以托管保存的模型 💾,并从社区加载强大的模型。
在本文中,我们将展示如何实现这一点。
安装
要在 Hugging Face Hub 上使用 stable-baselines3,你只需要安装以下两个库:
pip install huggingface_hub
pip install huggingface_sb3
查找模型
我们目前正在上传玩 Space Invaders、Breakout、LunarLander 等游戏的智能体保存模型。此外,你可以在这里找到 所有来自社区的 stable-baselines-3 模型。
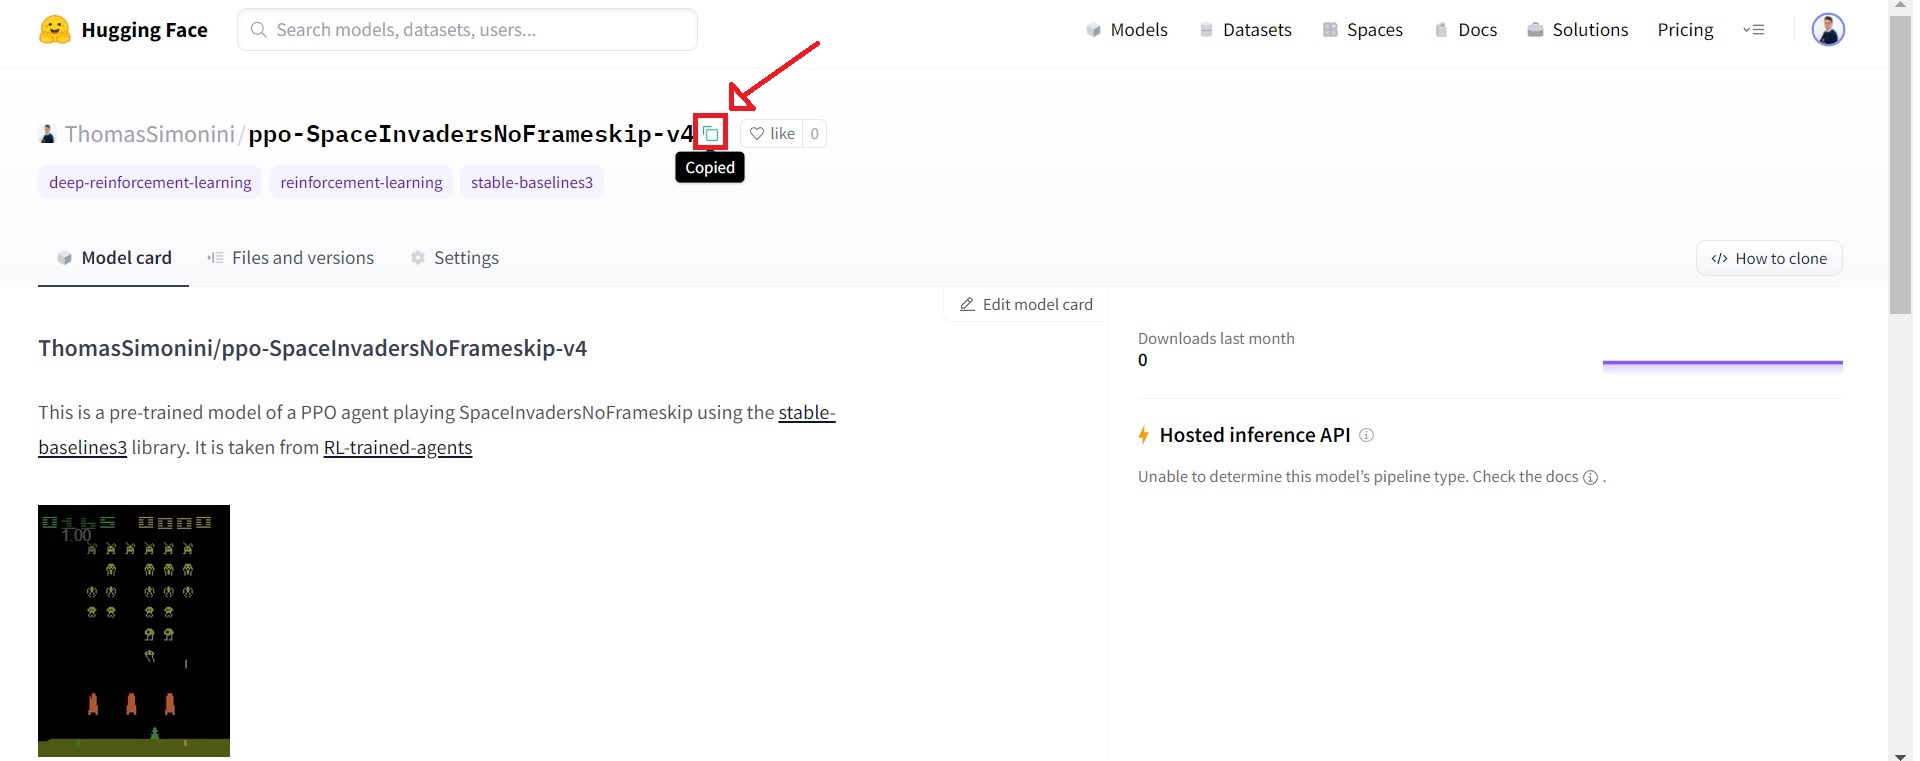
当你找到所需的模型时,只需复制仓库 ID:
从 Hub 下载模型
此集成的最酷功能在于,现在你可以非常轻松地将保存的模型从 Hub 加载到 Stable-baselines3 中。
为此,你只需复制包含已保存模型的 repo-id 以及该仓库中已保存模型 zip 文件的名称。
例如 sb3/demo-hf-CartPole-v1:
import gym

from huggingface_sb3 import load_from_hub
from stable_baselines3 import PPO
from stable_baselines3.common.evaluation import evaluate_policy

checkpoint = load_from_hub(
    repo_id="sb3/demo-hf-CartPole-v1",
    filename="ppo-CartPole-v1.zip",
)
model = PPO.load(checkpoint)

eval_env = gym.make("CartPole-v1")
mean_reward, std_reward = evaluate_policy(
    model, eval_env, render=True, n_eval_episodes=5, deterministic=True, warn=False
)
print(f"mean_reward={mean_reward:.2f} +/- {std_reward}")
将模型共享到 Hub
只需一分钟,你就可以将保存的模型上传到 Hub。
首先,你需要登录 Hugging Face 才能上传模型:
- 如果你使用的是 Colab/Jupyter Notebooks:
from huggingface_hub import notebook_login
notebook_login()- 否则:
huggingface-cli login然后,在本例中,我们训练一个 PPO 智能体来玩 CartPole-v1,并将其推送到新仓库 ThomasSimonini/demo-hf-CartPole-v1
from huggingface_sb3 import push_to_hub
from stable_baselines3 import PPO

model = PPO("MlpPolicy", "CartPole-v1", verbose=1)

model.learn(total_timesteps=10_000)

model.save("ppo-CartPole-v1")

push_to_hub(
    repo_id="ThomasSimonini/demo-hf-CartPole-v1",
    filename="ppo-CartPole-v1.zip",
    commit_message="Added Cartpole-v1 model trained with PPO",
)
试试看,并与社区分享你的模型吧!
接下来是什么?
在未来几周和几个月内,我们将通过以下方式扩展生态系统:
- 集成 RL-baselines3-zoo
- 将 RL-trained-agents 模型 上传到 Hub:这是一个使用 stable-baselines3 训练的预强化学习智能体的大型集合
- 集成其他深度强化学习库
- 实现 Decision Transformers 🔥
- 以及更多即将推出的功能 🥳
保持联系的最佳方式是加入我们的 Discord 服务器,与我们及社区交流。
如果你想更深入地了解,我们编写了一个教程,你将学到:
- 如何训练一个深度强化学习着陆器智能体,使其正确降落在月球上 🌕
- 如何将其上传到 Hub 🚀
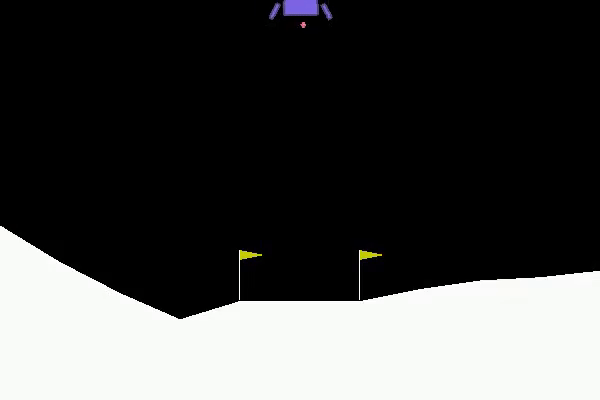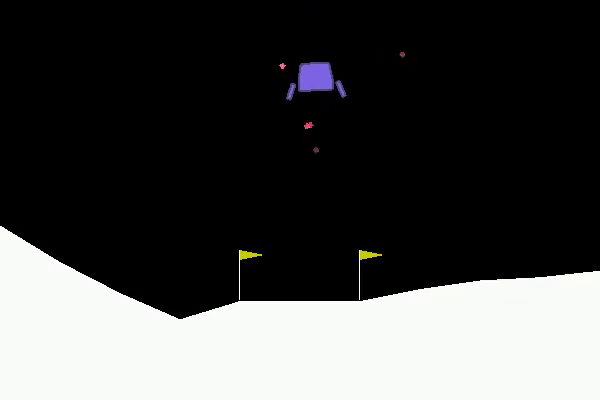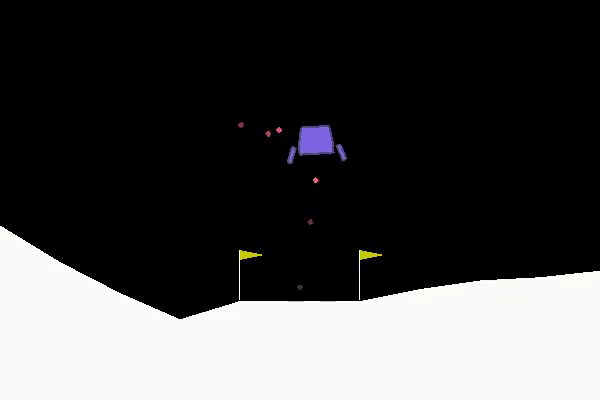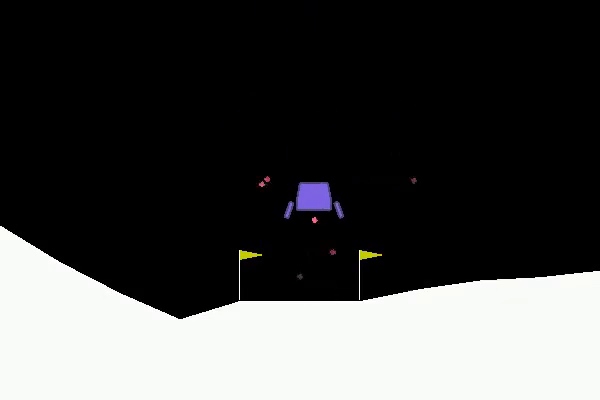
- 如何从 Hub 下载并使用一个已保存的、能玩太空侵略者游戏的模型 👾。
👉 教程链接
结论
我们非常期待看到你用 Stable-baselines3 构建的项目,并在 Hub 上试用你的模型 😍。
我们也希望能听到你的反馈 💖。📧 欢迎随时 联系我们。
最后,我们要感谢 SB3 团队,特别是 Antonin Raffin,感谢他们为该库的集成提供的宝贵帮助 🤗。
你想将自己的库集成到 Hub 吗?
这一集成之所以成为可能,要归功于 huggingface_hub 库,它包含了我们所有的组件(widgets)以及针对所有受支持库的 API。如果你想将自己的库集成到 Hub,我们为你准备了一份指南!