GitHub 发布 AI 模糊测试智能体,自动化 C/C++ 漏洞挖掘
GitHub Security Lab 推出基于 LLM 的自主模糊测试智能体“Fuzzing Taskflow”,旨在解决传统持续模糊测试中依赖人工编写测试桩和分诊崩溃的问题。该工具能自动分析构建系统、生成 AFL++ 测试桩、监控覆盖率并输出漏洞报告,实现了从代码入口点到最终报告的全流程自动化。
报道正文
本文目录8 个章节
如果你是模糊测试的新手,想先学习基础知识,请查看我们的 Fuzzing 101 课程:gh.io/fuzzing101。
持续模糊测试并不是能解决所有问题的灵丹妙药。即使那些已经加入 OSS-Fuzz 多年的项目,仍然可能隐藏着关键漏洞,而原因几乎总是相同的:需要有人持续关注覆盖率,为那些未被触及的代码编写新的测试桩(harness),并对最终产生的崩溃进行分诊。换句话说,模糊测试仍然需要“人在回路”(human in the loop)。
因此,我一直在问自己的一个自然问题是:我们究竟能将多少这样的人工工作交给 LLM agent?
这促使我构建了 Fuzzing Taskflow,这是一个针对 C/C++ 项目的自主模糊测试流水线。你只需要将其指向一个 GitHub 仓库,剩下的事情它都会自动完成:识别合适的入口点、分析构建系统、编写测试桩、运行 AFL++、读取覆盖率报告、改进测试桩、对每个崩溃进行分诊,并为每个独特的 bug 编写漏洞报告——整个过程无需人工值守。
Fuzzing Taskflow 基于 GitHub Security Lab Taskflow Agent 构建,这是我们用于编写 LLM 驱动的安全自动化的框架,因此该流水线被表达为一组由 agent 端到端执行的 taskflows。
在本文中,我将带你了解它的工作原理及其背后的设计决策。让我们开始吧!
如何运行
最简单的运行方式是访问 https://github.com/GitHubSecurityLab/seclab-taskflows-fuzzing 并启动一个 codespace。
然后,像这样运行脚本:
./scripts/fuzzing/run_fuzzing.sh PROJECT例如:
./scripts/fuzzing/run_fuzzing.sh tukaani-project/xz就这么简单。参数只是一个 GitHub owner/repo slug。随后,agent 会自行处理所有初步步骤:
- 安装诸如 AFL 之类的软件
- 克隆仓库
- 识别代码中最相关的函数
- 为这些函数创建 fuzz targets
如果你只想在投入长时间测试之前进行一次快速冒烟测试,可以指向一个小项目:
./scripts/fuzzing/run_fuzzing.sh DaveGamble/cJSON在运行之前请注意:此 taskflow 会直接在主机上运行 afl-fuzz、clang 以及 由 LLM 选择的任意构建命令,中间没有任何容器隔离。理论上,一个被提示注入的 agent 可以做任何你的用户权限允许的事情。因此,请务必仅在一次性环境中(例如 Codespace 或临时虚拟机)运行它,且不要使用提权权限。
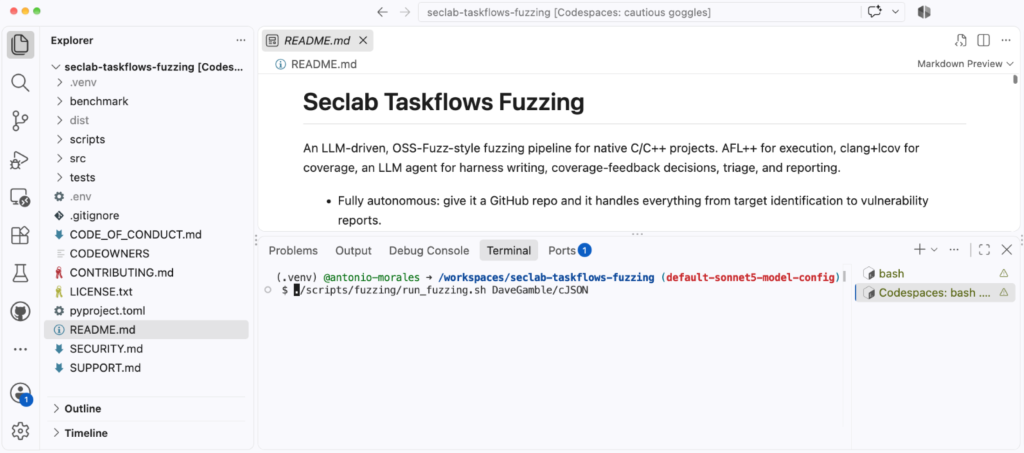
模型选择
一些前沿模型会对输出施加安全护栏。对于 fuzzing 任务流,我们默认使用 Claude Sonnet 5,因为它通过了我们所有的内部测试且没有问题。你可以通过修改以下文件来选择不同的模型:src/seclab_taskflows_fuzzing/configs/model_config.yaml。
一分钟了解架构
在进入有趣的部分之前,先了解各个组件如何协同工作会有所帮助。系统分为三层:
- 一个 shell 驱动程序 (run_fuzzing.sh),将流水线各阶段串联起来。
- 一组 taskflow YAML 文件,每个阶段对应一个,本质上就是告诉 LLM agent 在每个步骤该做什么的提示词。
- 一组 MCP 工具,agent 调用它们来实际执行工作:运行 AFL、编译 harness、存储崩溃信息、读取覆盖率报告等。
我最看重的设计原则是职责的清晰分离:LLM agent 负责决策,MCP 工具负责执行。Agent 决定要 fuzz 什么、编写什么样的 harness、以及接下来要追逐哪个覆盖率缺口。工具只暴露诸如 run_afl_for 或 compile_harness 这样的原语。Agent 从不直接调用 AFL 或 clang;它通过这些构建块组合出整个流水线。所有状态都保存在 SQLite 数据库 (fuzz_context.db) 中,因此各阶段之间不会在内存中传递数据,仅通过数据库进行交互。
一个虽小但重要的细节:每个 harness 都会被构建两次。AFL 的边缘插桩对于引导 fuzzer 非常有效,但对于人类可读的覆盖率报告却毫无用处。因此,每个 harness 都会生成两个二进制文件:一个是 .afl 二进制文件(使用 afl-clang-lto -fsanitize=address,undefined 构建),另一个是 .cov 二进制文件(使用 clang -fprofile-instr-generate -fcoverage-mapping 构建)。.afl 二进制文件用于执行 fuzzing;而 .cov 二进制文件则在之后重放 AFL 的队列,以生成真实的源代码行和分支覆盖率。
这是整个流程的核心,也是最直接自动化我开头描述的手动工作流的部分。
如果你曾尝试手动提升模糊测试覆盖率,就会知道这是一个迭代过程,其流程如下:
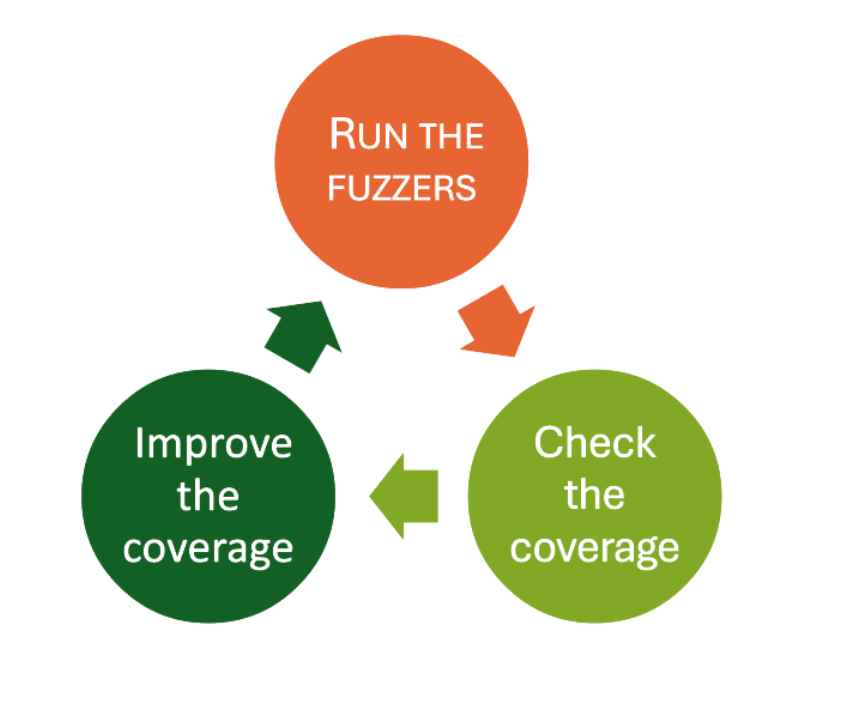
过去,“检查覆盖率”这一步由我手动完成,即阅读 LCOV 报告以寻找未覆盖的分支。“改进覆盖率”这一步同样由我手动完成,包括编写新的 harness 或构造新的输入。Fuzzing Taskflow 将这两个步骤都交给了 agent。
在每次迭代中,针对每个 harness,agent 会运行 AFL 一定的时间预算,然后重放队列中的用例到 .cov 二进制文件以获取真实的覆盖率报告,接着读取未覆盖分支列表。基于发现的内容,它会从以下几个操作中选择一个:
- 添加一个专门构造的新种子,以触达未覆盖的分支
- 编辑 harness 源码以调用额外的 API
- 自动丰富 AFL 字典,加入 guard 比较时使用的 magic constants
- 如果该缺口属于冷错误路径或不值得追踪的 vendor code,则直接跳过
时间预算每次迭代翻倍:
30s → 60s → 120s → 240s → 480s → 960s (≈ 32 min/target)
其思路是早期投入低成本、短时间的轮次(此时有大量容易获取的覆盖率),后期则使用更长的轮次(当模糊器需要更多时间来突破难以绕过的 guard 时)。
正如我在手动工作流中所做的那样,我需要回答一个问题:何时停止? 在这里,循环采用 plateau detection(平台期检测):一旦连续两次迭代各自获得的绝对行覆盖率增益低于可配置的阈值(默认为 1%),循环便判定已进入收益递减阶段并继续前进。这防止了 agent 浪费数小时的计算资源去榨取最后零点几个百分点的覆盖率。
结构感知型模糊测试
AFL 默认的字节级变异器(位翻转、算术运算、块拼接)在处理二进制格式时表现优异,但在处理结构化、文本格式的输入时却力不从心。经典的解决方案是为每种格式手写自定义变异器,但这是一项繁琐的工作。这次我希望让 pipeline 替我完成这项工作,因此它内置了 四种互补机制 来生成结构感知的输入。
1. 按格式定制的字典与自定义变异器。对于输入格式可识别的目标(如 JSON、XML、正则表达式、PNG、带长度前缀的二进制 TLV),任务流提供了预构建的 AFL 字典和 LLVMFuzzerCustomMutator C 文件。JSON 变异器执行 token 拼接和括号平衡复制;XML 变异器了解标签、实体以及 billion-laughs(十亿笑)攻击 token;正则表达式变异器则内置了真实的 ReDoS 模式。每个变异器将其一半的变异操作委托给 AFL 默认的字节变异器,从而保留引擎的随机性,而非与之对抗。
2. 源码级字典。对于流水线无法识别的格式,它通过扫描目标自身的 .c/.h 文件即时生成自定义变异器。该过程提取字符串字面量和 32 位数值常量(来自 #define、case 和 enum),过滤掉噪声数据,并将它们用作拼接 token。其直觉很简单:解析器检查的最有趣的魔术值通常都写在其自身源代码的某个地方。
3. 基于覆盖率增强动态生成的 AFL 字典。相同的源码 token 集合也会在第一次迭代之前作为经典 AFL 字典输出(包含两种字节序的数值常量,以便模糊测试器无论主机字节序如何都能满足针对 4 字节魔术值的 memcmp)。随后,在每次覆盖率步骤后,流水线会检查未覆盖行附近的守卫条件(如 strncmp、memcmp、case 0xN、== ‘X’),并追加发现的新 token。字典实际上是在向模糊测试器尚未触及的代码“生长”。
4. 语料库拼接算子。智能变异器还可以从语料库目录加载文件,并将其中的随机子区域拼接到输入中,这是一种 AFL 标准 havoc 变异难以有效实现的重组式算子。
演化语料库
悄悄扼杀模糊测试效率的因素之一是丢弃进度。如果每次运行都从原始种子开始,你就不得不反复重新支付发现相同路径的成本。
为避免这种情况,每个 harness 都会获得一个稳定的语料库目录,该目录在不同迭代之间以及整个测试活动中持续存在:
<workspace>/corpus/harness_<id>/在每次迭代结束时,AFL 的队列会被合并到此目录中,并通过 afl-cmin 处理以保持其大小可控。其效果是,昨天发现的有趣输入会带入今天的运行,上周测试活动中发现的输入也会带入本次活动。如果你停止并重启测试活动,不会丢失任何成果。
分诊与漏洞报告
发现崩溃只是工作的一半。正如任何做过根因分析的人所知,分诊(Triage)往往是整个流程中最繁琐的部分。而这正是该智能体(Agent)大显身手的另一个领域。
模糊测试循环结束后,会自动运行三个阶段。首先,使用 afl-tmin 对每个崩溃进行最小化,在 ASan 下重放以捕获堆栈跟踪,并通过 stack-top hash(顶部规范化帧,剥离模板、内联命名空间和 LTO 后缀,以便语义相同的崩溃归并在一起)进行去重。其次,针对当前二进制文件重放先前已知的崩溃,以检查上游修复是否已解决这些问题。第三,智能体读取测试框架(harness)源代码和发生崩溃的函数,从公共 API 回溯调用链,并为每个崩溃编写一份 Markdown 格式的报告。
每份报告都会给出以下判定之一:
- vulnerability
- library_hardening
- harness_bug
- OOM
- timeout
- assertion_failure
- duplicate
真正的 vulnerability(可通过公共 API 触达且可利用)与单纯的 harness_bug(缺陷存在于我们自己的测试框架中,而非库本身)之间的区别,正是那种过去需要我坐下来手动追踪代码才能做出的判断。每份报告都包含带有 file 引用的根因分析、可达性论证、可利用性评估、作为统一差异格式(unified diff)的建议修复方案以及回归测试草案。
需要澄清的是:建议的补丁被标记为“需审核”是有原因的。智能体的分析受限于模型对目标代码的理解能力,它确实会出错。请将判定结果视为供人类参考的、准备非常充分的起点,而非最终结论。
实时仪表盘
运行一个自主式攻击活动却无法看到其进展会让人不安,因此该流水线会将所有内容发布到一个实时 HTML 仪表盘上。一旦启动活动,它会在后台自动开始运行,端口号为 8765。在 Codespace 中,该端口会自动转发,因此你可以在任意浏览器中打开它,并在仪表盘上实时观看活动进度。
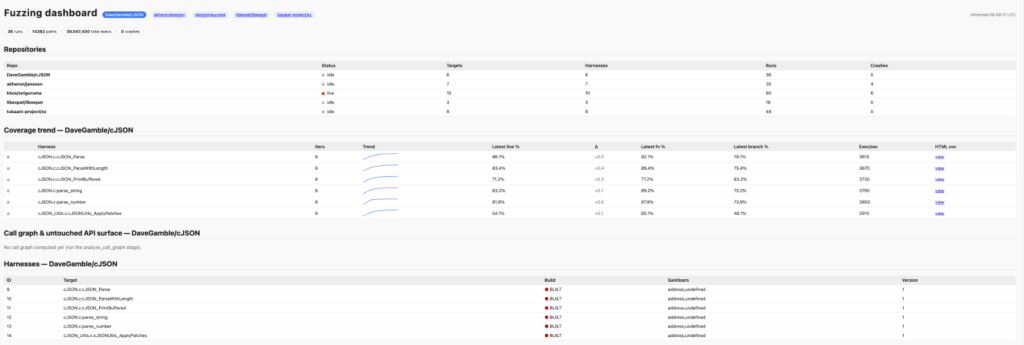
页面显示的内容包括但不限于:
- 每个测试框架的“运行中”脉冲指示
- 带有内嵌迷你图(sparklines)的覆盖率趋势表
- 崩溃热力图
- 迭代时间线
结论
我启动这个项目,源于每一位安全研究员都深知的局限性:模糊测试(fuzzing)确实有效,但若没有人工关注便难以扩展,而人工关注正是瓶颈所在。Fuzzing Taskflow 是我尝试将这一瓶颈后移的努力——把重复性工作(编写测试桩、分析覆盖率、追踪覆盖缺口、崩溃问题分诊)交给 LLM Agent 处理,同时在 Agent 的判断逻辑与执行实际工作的工具之间保持清晰的分离。
如果你是 C/C++ 项目的维护者,请试用一下。如果你的项目此前从未进行过模糊测试,该工具能帮助你快速上手;如果你的项目已经做过模糊测试,该工具或许能通过提升你的 fuzzing 覆盖率来发现新的 bug。
源代码已开源,如果你遇到任何 bug,欢迎提交 issue。我们也欢迎贡献代码!
文章 AI-powered fuzzing with the GitHub Security Lab Taskflow Agent 首发于 The GitHub Blog。