SWE-CoWork 基准发布 智能体完整交付率不足 8%
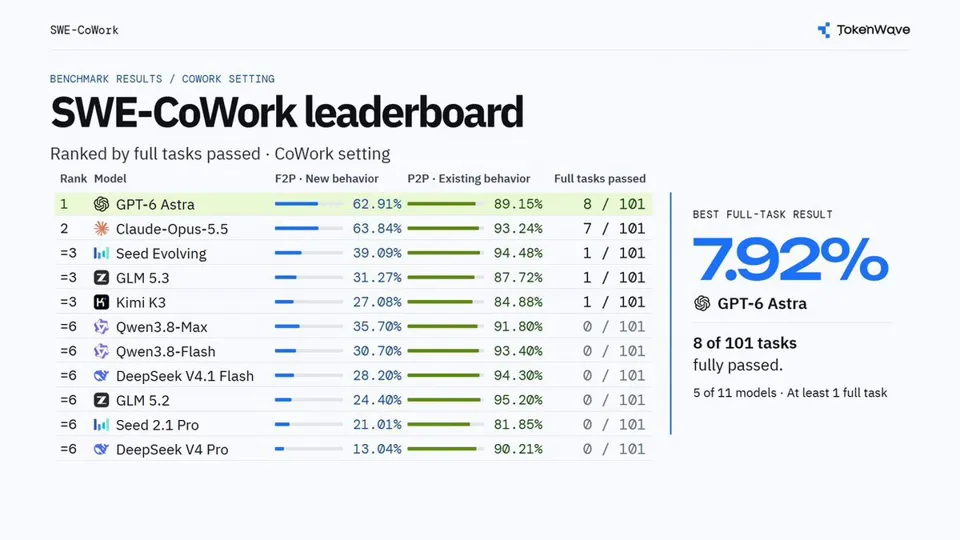
TokenWave AI 发布 SWE-CoWork 基准,将编码智能体置于模拟职场中,82% 的需求分散在队友手中,智能体必须主动询问才能获知任务内容。在 101 个真实开源仓库任务上,最强模型单项检查通过率约 63%,但完整交付的仅 8 项,暴露出长周期协作与信息获取是当前智能体的核心短板。
报道正文
Rohan Paul (@rohanpaul_ai) · 2026-11-17 16
编程智能体基准测试开始看起来像新员工入职的第一周。
TokenWave AI 发布了 SWE-CoWork,这是一个新的基准测试,用于检验 AI 编程智能体能否像真正的团队成员一样工作。
提前向 GPT-6 Astra 提供完整规格说明,使其通过的检查项提升了 16 个百分点,但它仍然只完整完成了 101 项任务中的 8 项。SWE-CoWork 将编程智能体置于一个模拟真实工作流程的职场环境中,然后将每个未通过的检查项关联到具体需求。
大多数编程基准测试会向 AI 智能体提供一份完整的书面任务,但 SWE-CoWork 将其置于一个模拟职场中,其中 82% 的需求掌握在队友手中,因此智能体只有通过询问正确的人才能了解要构建什么。表现最好的模型通过了约 63% 的单项检查,但完整完成的 101 项任务不足 8%。
↳ 引用 @TokenWaveai (TokenWave.AI): 编程智能体能否接手队友正在进行中的工作?
隆重推出 SWE-CoWork,一个面向以数字员工身份从事长周期软件工程任务的编程智能体的基准测试。
每项任务都始于一个模拟职场中的简短交接,该职场仿照真实工程工作流程建模。智能体会搜索任务板和带版本控制的文档,向队友询问缺失的细节,并在回复改变了需要构建的内容时修改代码。
未解决的问题和已确认的需求都可能在智能体交回工作之前丢失。SWE-CoWork 让我们能够通过对话、补丁和测试来追踪它们。
101 项任务,覆盖 101 个真实开源仓库。 每个职场 26 个模拟队友。 11 种编程语言。 12 个应用领域。 17 种职场工具。
🌐 网站: