Rohan Paul (@rohanpaul_ai) · 2026/10/15 01:09:06
斯坦福与 Together AI 提出 HybridAgent:潜空间推理降低 62.5% 解码算力且 GAIA 得分反超文本智能体
斯坦福大学与 Together AI 联合发布新研究,提出 HybridAgent 架构,通过让大模型在内部潜向量(latent vectors)中进行大部分推理,仅在工具调用和关键决策时切换回文本模式。该方法将解码计算量降低了 62.5% 至 72.9%,同时在 GAIA 基准测试中,14B 版本得分达到 52.4,显著高于纯文本智能体的 43.7,并实现了 2.1 倍的推理加速。这一突破证明了“沉默思考”不仅不牺牲准确性,反而能提升智能体效率与性能。
报道全文原始报道全文
Rohan Paul (@rohanpaul_ai) · 2026-10-14 17
斯坦福大学与 Together AI 的最新论文发现,更廉价的推理并不必然以牺牲准确性为代价:混合智能体(Hybrid Agents)将解码计算量降低了 62.5% 至 72.9%,同时得分反而更高。
研究表明,当大部分思考过程发生在隐藏向量中而非书面文本里时,智能体的运行速度更快且得分更高。
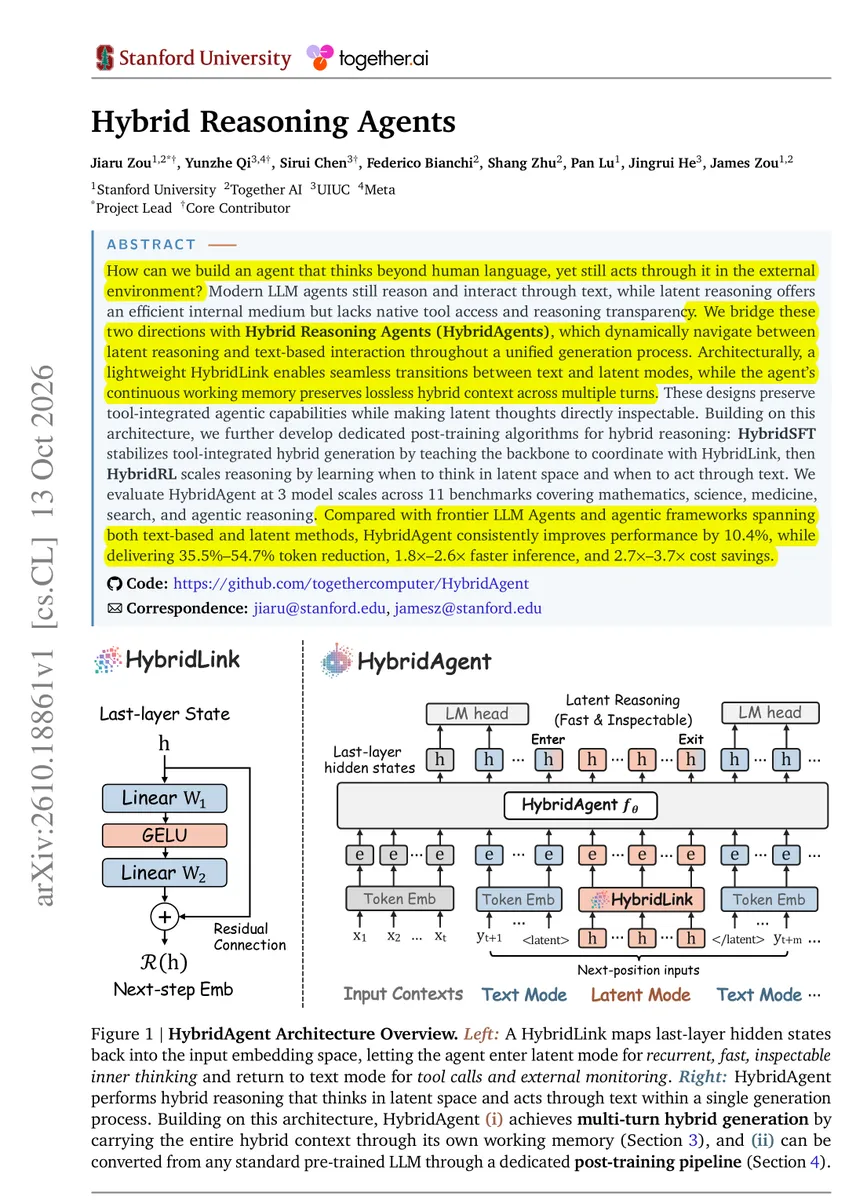
如今的智能体会将每一个推理步骤都写成文本 token,这既缓慢又昂贵。在内部向量中进行推理的模型速度更快,但它们无法调用工具,人类也无法读取其思考内容。
HybridAgent 增加了一个小型适配器,将模型的内部状态作为下一个输入反馈给模型,使其能够“不写文字”地进行思考。它在需要调用工具和做出关键决策时切换回文本模式,而其静默步骤仍可被解码为可读的文字。
在 GAIA 基准测试上,14B 版本得分为 52.4,高于使用 ARPO 训练的同款纯文本智能体的 43.7 分。此外,它的运行速度比同等配置的文本智能体快 2.1 倍。
如果你的智能体在常规推理上消耗了大量 token,不妨尝试将这些推理保留在内部,仅将文本用于工具调用和人类必须检查的步骤。
↳ 引用 @Jiaru_Zou (Jiaru "Rubin" Zou): 你的 LLM 智能体必须逐 token 地“大声思考”,才能进行搜索、运行代码或在现实世界中行动。
我们人类并非如此。我们在沉默中沉思,只在关键时刻开口。
人类语言本就不应成为机器思维的局限。
隆重推出 🌗混合推理智能体(Hybrid Reasoning Agents)
- 在潜在空间思考,通过文本行动
- 两种模式,统一的单一流转多轮对话流程
- 无黑盒,潜在思维完全可读
- 任何 LLM 均可转变为 HybridAgent