英伟达发布 Rubin HPC GPU 超 5 万 CUDA 核心
英伟达在 SC26 发布 Vera Rubin 平台新成员 Rubin HPC GPU,单卡 CUDA 核心数突破 5 万,并引入稀疏数据加速能力与第七代 NVLink 互联,专为科学计算、工程仿真与数据分析工作负载设计。该卡面向智能体驱动的科研探索场景,通过加速智能体调用的仿真任务缩短假设、仿真与迭代闭环,预计 2028 年上市。
报道正文
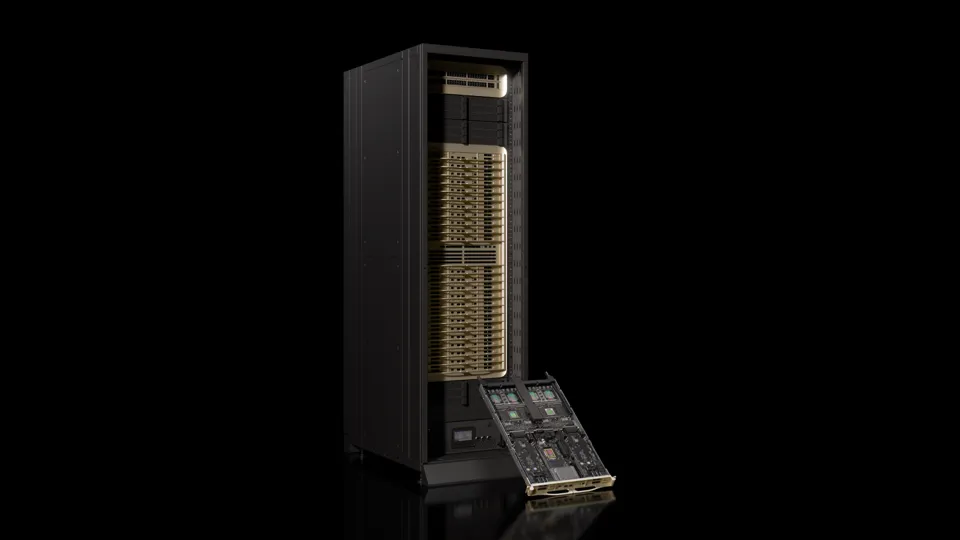
在 SC26 上今日宣布,NVIDIA Rubin HPC 是 NVIDIA Vera Rubin 平台中的一款全新 GPU,旨在加速科学、工程和分析工作流中的模拟与数据处理。
随着智能体帮助科学家和工程师探索更多候选材料、分子和设计,他们依赖模拟来验证这些想法并指导下一步工作。Rubin HPC 将加速这些模拟,缩短从探索到科学发现和工业设计的路径。
Rubin HPC GPU 拥有创纪录数量的 CUDA 核心——单颗 GPU 上超过 50,000 个——以及稀疏数据加速能力,可持续为这些核心供给数据,并通过第七代 NVIDIA NVLink 互连技术加速 GPU 之间的连接。
科学家和工程师依赖模拟来理解复杂系统,然后再进行实验或制作物理原型。借助智能体,这些团队可以探索更多候选材料、分子和设计。这增加了对 GPU 加速模拟的需求,以评估这些想法并指导下一步工作。
“对于从事科学和工程工作的智能体来说,更快的模拟意味着更快的发现,”NVIDIA 超大规模和高性能计算副总裁 Ian Buck 表示。“Rubin HPC 加速了智能体用于验证想法和指导下一步工作的模拟,帮助科学家和工程师探索更多可能性,让突破更近一步。”
将更快的计算转化为更快的发现
在气候模型、工程模拟、基因组分析和金融风险等领域,科学计算工作负载呈现出相似的模式:应用程序访问庞大的数据集,收集少量分散的数值,计算出一个结果,并以极大规模重复这一过程。
为帮助应对这一挑战,Rubin HPC 将提供均衡的设计,让数据移动与计算同步扩展,而非仅增加计算能力。
这种平衡正是 Rubin HPC 针对科学计算进行优化的关键所在。它确保 GPU 创纪录数量的 CUDA 核心能够持续获得数据供给,从而将时间用于计算而非等待。这加速了各类仿真工作负载中反复出现的模式——从稀疏矩阵运算到模板计算,再到排序与归约。
这些模式广泛存在于数据分析、科学与工程工作负载中,因此一款专为提供最广泛加速能力而打造的 GPU,能够帮助推动跨行业的突破。
NVIDIA CUDA-X 库为智能体提供了一套不断扩充的复杂算法优化实现,其中包括与仿真和分析最为相关的算法。与 Rubin HPC 配合使用,这些库能够为智能体提供通往推理结果的最快路径。
而更快的智能体调用仿真意味着更快的反馈——缩短假设、仿真与改进的循环,使研究人员和工程师能够更早地确定下一步行动,并将实验室工作指向最有前景的候选方案。
Rubin HPC 预计将于 2028 年上市。