Artificial Analysis 发布智能指数 v5 引入私有基准与进度追踪
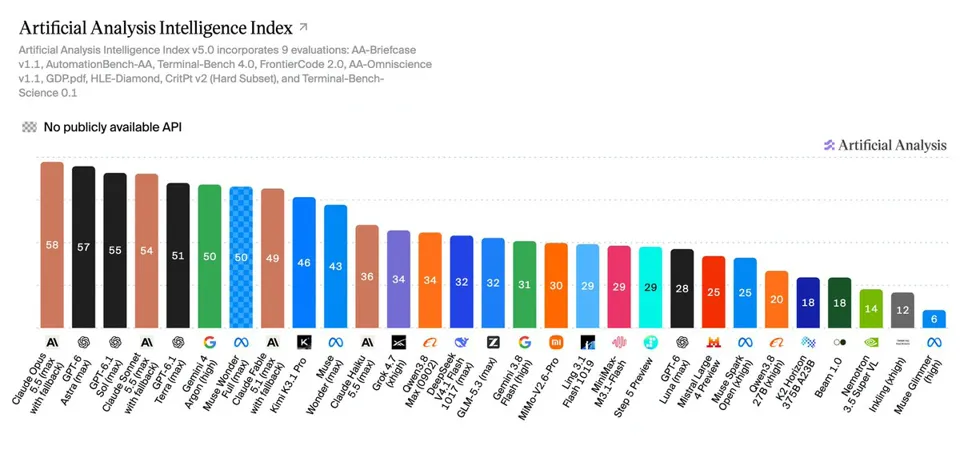
Artificial Analysis 发布智能指数 v5,这是自 v4 以来最大规模升级。新版将 60% 的评估权重转移至私有测试集或保留答案的数据集,以增强抗污染能力并反映真实世界使用情况。同时推出“进度指数”以连续追踪模型能力演变,并新增 FrontierCode 2.0 和 Terminal-Bench-Science 等前沿基准。
报道正文
Artificial Analysis (@ArtificialAnlys) · 2026-10-28 02
发布 Artificial Analysis Intelligence Index v5,包含 2 个新基准测试和 3 项升级。这是该指数首次主要基于私有数据集构建。
Artificial Analysis Intelligence Index 是我们对模型在反映当前真实世界使用场景的任务中能力的综合衡量指标。v5 是自今年一月 v4 发布以来最大的一次升级。在 v5 中,指数中 60% 的内容现在基于使用私有测试集或保留答案(held-out answers)的评估结果。
伴随 Intelligence Index v5,我们同时推出了 Artificial Analysis Progress Index v1,该指数在一个连续尺度上追踪模型能力随时间的变化。
Intelligence Index 新增内容:
➤ FrontierCode 2.0:Cognition 最新推出的私有基准测试,针对真实世界的编码任务,评分标准是仓库维护者是否会合并 Agent 提交的更改
➤ Terminal-Bench-Science:70 个在终端环境中运行的 Agentic 科学研究任务
升级内容:
➤ HLE-Diamond(取代 Humanity's Last Exam):Humanity's Last Exam 的精炼版,包含 1,000 个问题,推理题与知识题各占一半
➤ AA-Omniscience v1.1:更新后的数据集,移除了已饱和及公开的题目,增加了新题目,并修订了存在歧义或错误的题目
➤ CritPt v2:一个私有的、包含 40 个高难度问题的 CritPt v2 子集,由 CritPt 作者修订,并使用代码执行工具运行
保留在指数中的项目:AA-Briefcase、AutomationBench-AA、GDP.pdf 和 Terminal-Bench 4.0
从指数中移除的项目:GDPval-AA v2.1、SciCode 和 AA-LCR v1.1
关键结果:
➤ Claude Opus 5.5 (max) 以 58 分领先,超过 GPT-6 Astra (max, 57) 和 GPT-6.1 Sol (max, 55):Anthropic 和 OpenAI 占据了前五名模型的位置。Gemini 4 Argon (high) 紧随其后,得分为 50
➤ 开源权重模型的差距从 3 分扩大到 12 分:Kimi K3.1 Pro(权重尚未发布)以 46 分成为领先的开源权重模型。在已发布权重的模型中,DeepSeek V4.1 Flash 1017 (max) 和 GLM-5.3 (max) 以 32 分领先——落后榜首 26 分,且低于 Claude Haiku 5.5 (max, 36)
➤ 领先模型之间的单任务成本差异超过 13 倍:在展示的得分最高的 10 个模型中,GPT-6.1 Terra (max) 最便宜,每个 Intelligence Index 任务花费 $0.96;而 Claude Fable 5.1 (max) 最昂贵,花费 $13.04