斯坦福与 DeepMind 提出 TURTLE 自动进化工具调用基准
原标题:New Stanford and Google DeepMind paper shows that you can turn too-easy tool-use benchmarks into har...
78AI 研判分
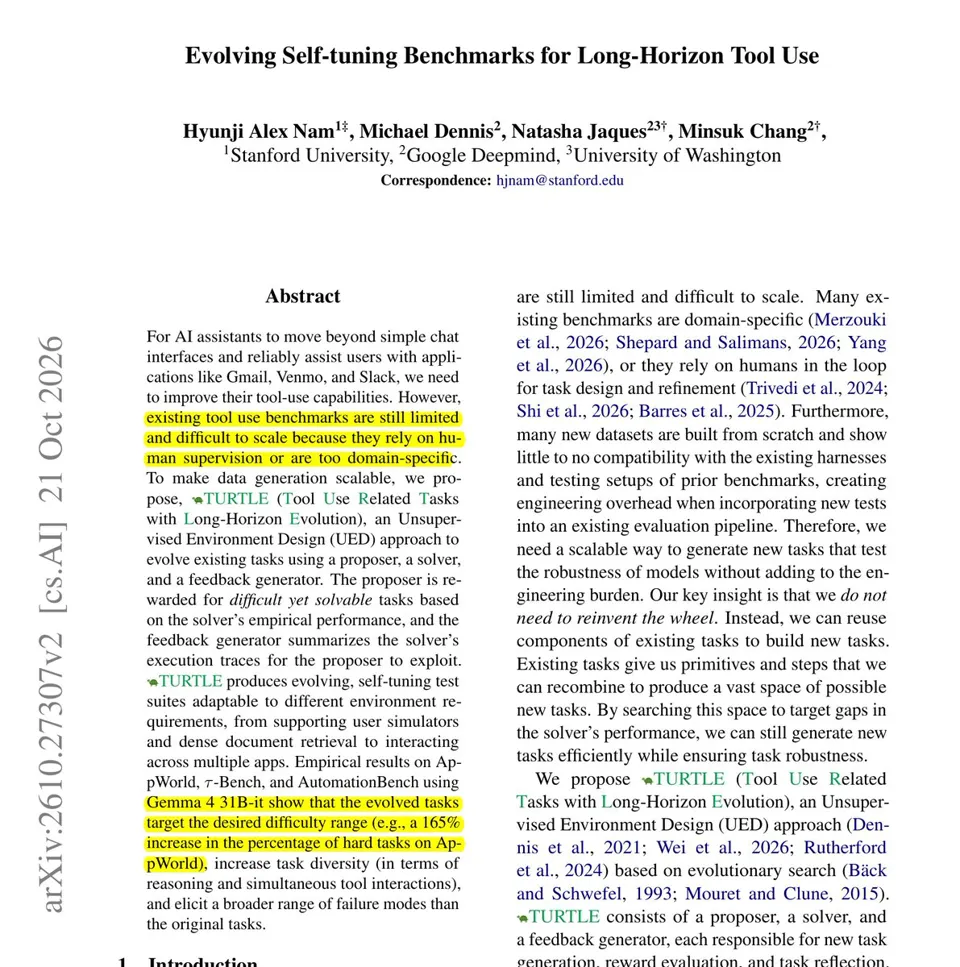
斯坦福与 Google DeepMind 的新论文提出 TURTLE 方法:利用 AlphaEvolve 对 AppWorld 等已饱和的工具调用任务进行变异,加入过滤条件、额外步骤与隐藏查询,并以求解模型约 50% 成功率作为难度目标。实验显示,Gemma 4 31B-it 原本能稳定解出 69% 的原始任务,而进化后的 735 个任务几乎都落在 40%-60% 完成率区间,LLM 评审认为 52.5% 的新任务属于困难级别,远高于原任务的 19.8%。
报道正文
Rohan Paul (@rohanpaul_ai) · 2026-11-08 23
斯坦福大学与 Google DeepMind 的新论文表明,你可以通过让现有任务针对模型进行演化,把过于简单的工具使用基准测试转化为困难但仍可求解的测试。
像 AppWorld 这样的工具使用基准测试是静态的,因此模型很快就能解决其中大多数任务,而构建新的基准测试则需要人工投入。
TURTLE 使用 AlphaEvolve 对现有任务进行变异,加入过滤器、额外步骤和隐藏查找,然后对每个任务运行求解模型 10 次。当求解模型的成功率约为 50% 时,任务得分最高,并且每个任务必须至少被成功求解一次。
在原始 AppWorld 任务中,有 69% 的任务总能被 Gemma 4 31B-it 求解,而在演化后的 735 个任务中,几乎所有任务的完成率都落在 40% 到 60% 之间。一个 LLM 评审将 52.5% 的演化任务评为困难,而原始任务中这一比例为 19.8%。
如果你的模型在某个基准测试中表现优异,不妨将其任务演化到约 50% 的成功率,而不是从零开始编写新的基准测试。