芝加哥大学研究:LLM 自述决策关键因素不可靠
原标题:New University of Chicago paper suggests that an LLM's own account of what matters to its decision i...
78AI 研判分
核心综述
芝加哥大学最新论文指出,大语言模型(LLM)对自己决策关键因素的自我陈述往往失真,无法准确反映导致答案差异的核心变量。研究发现,通过对比多次生成的答案来识别分歧点(Cruxes),比直接询问模型或查看单一回答更能揭示其真实推理逻辑,且该方法在计算成本上远低于传统评估方式。这一结论对高风险场景下的 AI 决策审计具有重要指导意义。
报道正文
Rohan Paul (@rohanpaul_ai) · 2026-10-24 09
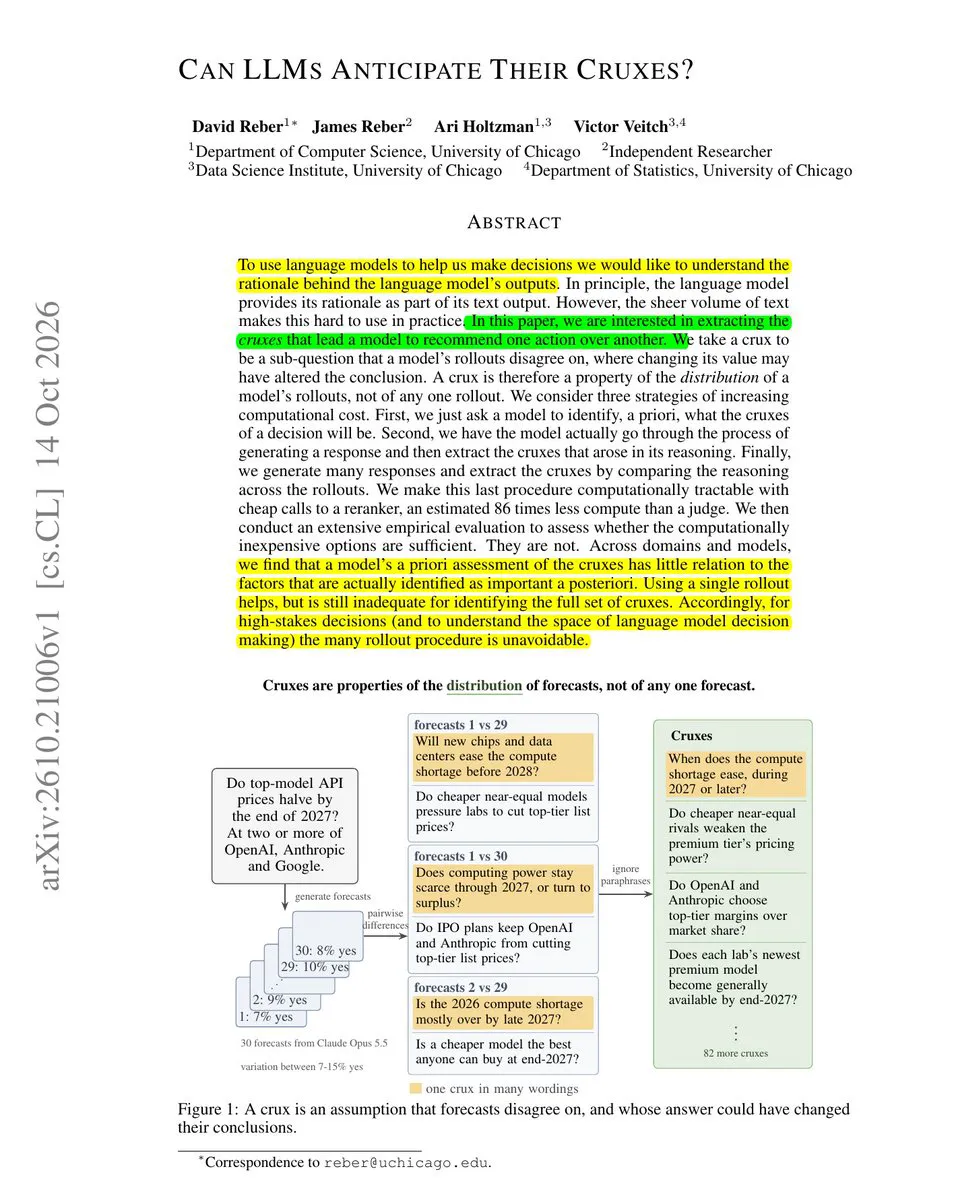
芝加哥大学最新论文指出,大语言模型(LLM)对自身决策关键因素的自述,并不能准确反映其不同回答之间实际存在的差异。
LLM 无法预测那些导致其答案出现分歧的关键问题,而只有通过对比大量答案才能揭示这些问题。
当 LLM 给出建议时,你希望了解的是其“关键支点”(cruxes),即驱动其结论的少数几个子问题。直接询问模型或仅阅读其中一个答案虽然成本低廉,但可能会遗漏真正起决定作用的因素。
研究人员让模型多次预测 59 场“疯狂三月”篮球赛和 15 个 Metaculus 事件的结果,然后通过对比成对的预测来找出存在争议的事实。使用重排序器(reranker)使得这种匹配过程变得廉价,据估计,其计算量比使用本地 LLM 作为评判者减少了约 86 倍。
在“疯狂三月”预测中,模型预测的关键支点与真实关键支点的聚类重合率仅为 13.4%,低于随机打乱顺序所能达到的 39.2%。单个答案的表现稍好,但也仅覆盖了 28.6% 的真实关键支点,而基线水平为 37.8%。
对于高风险决策,应当采样多个答案并观察它们之间的分歧点,而不是轻信模型自己列出的重要因素清单。