vLLM 推出 vllm-metal:在 Apple Silicon 实现并发推理与 OpenAI 兼容服务
vLLM 团队发布 vllm-metal,将 vLLM 的调度器、分页 KV 缓存和 OpenAI 兼容服务器引入 Apple Silicon。该工具利用 MLX 和 Metal 处理执行层,解决了 Mac 本地多请求并发时的首字延迟(TTFT)和内存管理问题。目前 v0.29.0 版本已支持 Homebrew 安装,并引入了批量多令牌预测(MTP)及 GGUF 模型支持。
报道正文
本文目录16 个章节
在 Mac 上进行本地推理起初非常简单,直到多个请求发生重叠。此时,首 Token 延迟(TTFT)、内存增长和准入控制便从模型执行问题转变为服务调度问题。vllm-metal 将 vLLM 的调度器、分页 KV 缓存以及 OpenAI 兼容服务器引入 Apple Silicon,由 MLX 和 Metal 负责底层执行。
我们的首个正式发布版本 v0.28.0 使 vllm-metal 的版本号与上游 vLLM 保持一致。该版本引入了批量多 Token 预测(MTP)、GGUF 及混合模型支持,并提升了 M5 芯片上的预填充(prefill)速度。你可以通过 Homebrew 安装 v0.29.0。
vllm-metal 如何融入 vLLM
vllm-metal 直接接入上游 vLLM。vLLM 提供 V1 调度器、分页 KV 块管理、分块预填充、采样功能,以及支持流式传输和工具调用解析的 OpenAI 兼容前端。mlx_lm 提供模型实现,而 MLX 负责执行这些实现。
在模型层面,vllm-metal 原样复用 mlx_lm 的权重加载、RMSNorm、线性层、MoE 和 MLP 层。这些层独立处理每个 Token,因此可以在打包的 Token 轴上运行,无需感知请求边界。但注意力机制需要知道这些边界,因此 vllm-metal 使用自定义的分页变长(paged varlen)Metal 内核替换了标准注意力实现。因此,该插件中大部分特定于模型的代码都集中在这一层。
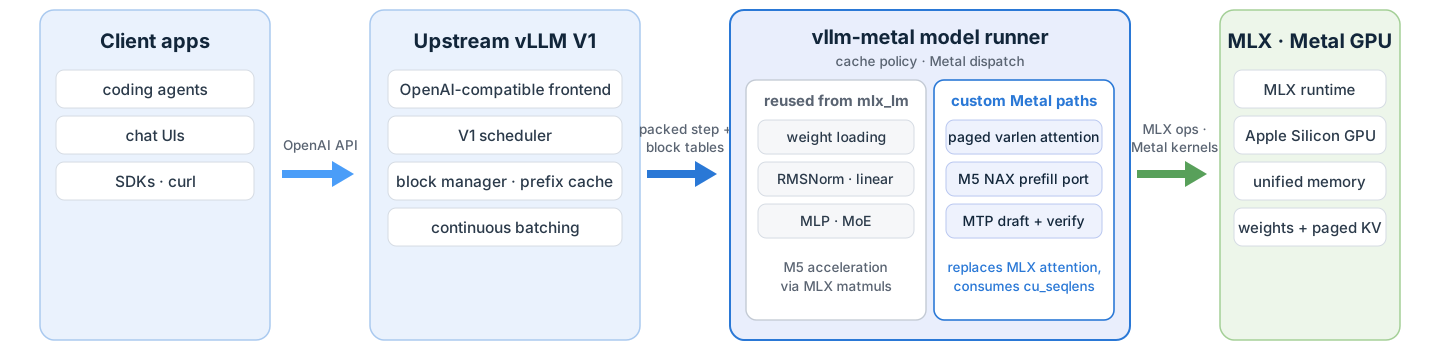
架构概览:客户端通过 OpenAI API 与上游 vLLM 的前端和 V1 调度器通信,后者将打包的步骤(packed step)及块表(block tables)传递给 vllm-metal 模型运行器;该运行器复用 mlx_lm 的逐 Token 层,并为分页变长注意力、MTP 和 M5 NAX 预填充添加了自定义 Metal 路径,所有操作均通过 MLX 和 Metal 在 Apple Silicon 统一内存上执行。
启动 OpenAI 兼容服务器
在搭载 Apple Silicon 芯片且运行 macOS 15 或更高版本的设备上,使用 Homebrew 安装稳定版本:
brew tap vllm-project/vllm-metal https://github.com/vllm-project/vllm-metal
brew install vllm-project/vllm-metal/vllm-metal
Homebrew 会自动管理 Python 及其依赖项。直接运行 vllm 即可启动模型:
# --gpu-memory-utilization 用于设置服务内存预算;详见下文。
vllm serve Qwen/Qwen3.5-0.8B --gpu-memory-utilization 0.5

# 64 GB 内存的 Mac:27B 混合模型
# vllm serve mlx-community/Qwen3.8-27B-4bit --gpu-memory-utilization 0.7

# 推测解码:Gemma 4 及其 MTP 辅助模型
# vllm serve google/gemma-4-E4B-it --gpu-memory-utilization 0.5 \
#   --max-model-len 16384 --no-async-scheduling \
# --speculative-config '{"method":"mtp","model":"mlx-community/gemma-4-E4B-it-assistant-bf16","num_speculative_tokens":1}'如需了解支持的更多模型,请查阅模型矩阵;如需了解其他安装方法,请参阅安装指南。
服务器支持 OpenAI API 协议:
curl http://localhost:8000/v1/chat/completions \
  -H "Content-Type: application/json" \
  -d '{"model": "Qwen/Qwen3.5-0.8B",
       "messages": [{"role": "user", "content": "Say hi"}]}'
任何支持配置 OpenAI 兼容基础 URL(base URL)的工具均可指向 http://localhost:8000/v1,包括各类编码代理(coding agents)。vLLM 文档中涵盖了 Claude Code 和 Codex 的配置说明。
设置可预测的内存预算
vllm-metal 的内存保护机制允许通过 --gpu-memory-utilization 参数设定推理内存预算,从而为 macOS 系统及其他应用程序预留足够的内存空间。与上游 vLLM 类似,它在启动时会执行一次预热(warmup)过程,以计算模型权重、激活值及临时缓冲区所需的内存,随后将剩余预算分配给固定大小的 KV cache。此外,它还会限制 MLX 的可复用缓冲区缓存大小,防止在服务过程中出现内存累积现象。若请求无法容纳在 KV pool 中,则会等待直到有可用页面释放出来。
打包查询与分页 KV Cache
在 mlx_lm 的填充批次(padded batches)中,注意力查询的形状为 [B, H, T_max, D]:即批次中的每个请求都会对齐到该批次中最长的查询长度。MLX 的 scaled_dot_product_attention 接口不支持变长序列(varlen)处理。
vllm-metal 保留了 vLLM V1 针对分块预填充(chunked prefill)和解码(decode)的统一模型步骤。它将所有调度的查询 token 打包为 [total_q, H, D],使用 cu_seqlens 标记请求边界,并在单次模型前向传播中运行混合步骤。
KV 缓存的处理方式有所不同:mlx_lm 维护一个连续的 [B, H, T, D] 缓存,而 vllm-metal 将 KV 存储在固定大小的页面中,通过每个请求的块表(block tables)进行寻址。已接纳的请求可以在无需重塑填充缓存的情况下增长。
预填充和解码采用不同的批处理策略:
预填充注意力描述了提示词查询进入注意力内核的方式:单独处理、填充至统一长度或拼接在一起。解码批处理在单个模型步骤中处理多个请求;“+ 预填充”表示该批次中包含提示词 token。KV 描述了逻辑存储结构:连续缓冲区、独立 token 单元或 token 块。
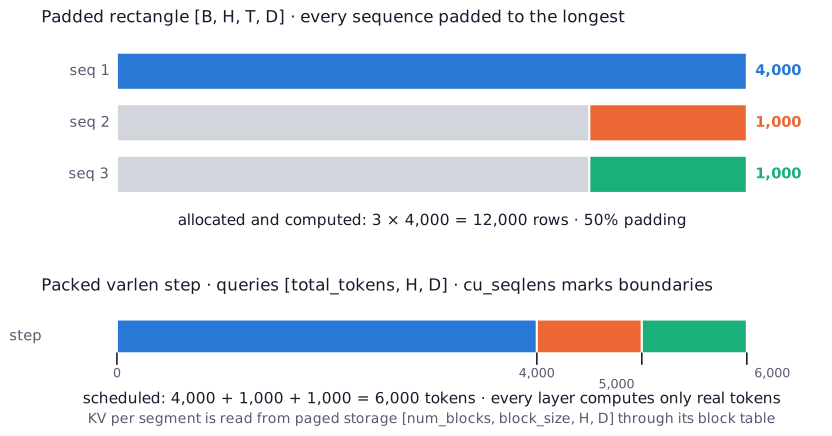
填充矩形与 vllm-metal 针对 4,000 + 1,000 + 1,000 token 批次的打包变长步骤对比,其中 KV 从分页存储中读取
在 Qwen3.6-35B-A3B 模型的 4-bit 量化版本上,我们比较了包含八个请求的批次,总提示词 token 数约为 6,000,每个请求输出 20 个 token。批次 A 具有相似的提示词长度;批次 B 包含一个较长的提示词。下表报告了以秒为单位的批次墙钟时间(wall time),提示词长度已四舍五入。
| 批次 | 提示词 token | mlx_lm | oMLX | llama.cpp | vllm-metal |
|---|---|---|---|---|---|
| A | 750 × 8 | 4.52 | 7.32 | 5.29 | 3.87 |
| B | 3,000 + 430 × 7 | 10.99 | 7.22 | 5.33 | 3.64 |
| 变化 | |||||
| +143% | −1% | +1% | −6% |
Packing 还能将不规则(ragged)工作负载整合到同一个批次中。在推测解码步骤里,一个请求可能只贡献一个 decode token,另一个请求则包含其最后一个 token 加上特定数量的 draft tokens,还有一个可能是 prefill chunk。[B, H, T_max, D] 形状的 query tensor 要么需要将这些行填充至统一宽度,要么需拆分到多次前向传播中处理。而 vllm-metal 则将这些窗口拼接为 [total_q, H, D],并在单次目标模型前向传播中进行验证。
Metal kernel 将 vLLM 的统一 Triton kernel——如论文 The Anatomy of a Triton Attention Kernel 所述——移植到了 Apple GPU 上,甚至保留了每个 threadgroup 对 cu_seqlens 执行二分查找以确定其 query token 所属请求的逻辑。
Agent 负载下的并发服务
多个 coding agent 或会话可以同时发送模型请求。我们使用 SiliconBench 的 agent split 进行了测量:在配备 64 GB 内存的 M5 Pro 上运行 100 个多轮 prompt,每个输入约 4.6K tokens。所有三个模型的对比均使用 4-bit 权重。
SiliconBench 论文 提供了对九款 Apple Silicon 推理引擎更广泛的评估,涵盖速度、内存使用和输出保真度。
每个并发级别都从全新的服务器实例开始测试。oMLX 分别展示了默认 SSD 缓存和纯 RAM 缓存配置;两者初始状态均为空。附录 列出了具体的服务配置,图表标题中报告了完成请求的数量。
Qwen3.8-27B
SiliconBench agent split 在 Qwen3.8-27B 上的表现:TTFT、端到端请求延迟以及输出 token 吞吐量随并发数的变化,对比对象包括 llama.cpp、vllm-metal 以及 oMLX(分别使用内存和前缀缓存及 SSD 缓存)。
在并发数为 2 和 4 时,vllm-metal 拥有最低的 TTFT 和端到端延迟。在并发数为 1 时,启用 SSD offload 的 oMLX 领先。
Gemma 4 E4B
对于 Gemma 4 E4B,我们将扫描范围扩展至并发数 16,并纳入了带有 MTP drafter 的 vllm-metal。
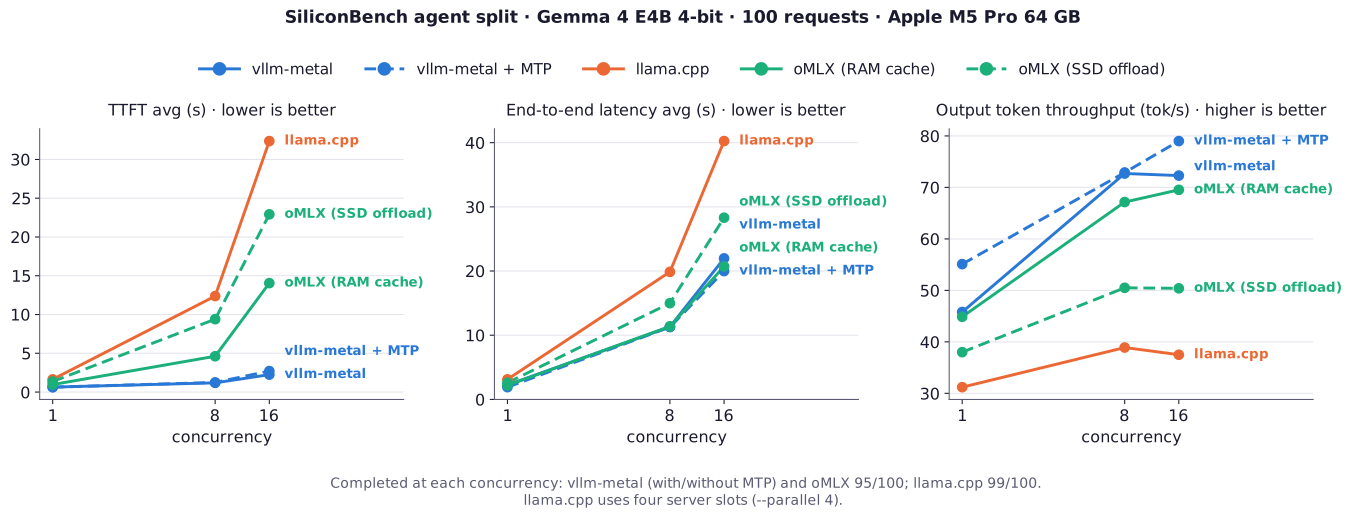
SiliconBench 智能体在 Gemma 4 E4B 上的拆分测试:TTFT、端到端请求延迟以及输出 token 吞吐量随并发量的变化,对比 llama.cpp、带与不带 MTP 草稿模型的 vllm-metal,以及启用内存和 SSD 前缀缓存的 oMLX
在整个扫描范围内,vllm-metal 始终保持较低的 TTFT。llama.cpp 使用其默认的四个服务器槽位。
Qwen3.6-35B-A3B
Qwen3.6-35B-A3B 总参数量为 35B,每个 token 激活参数为 3B。它结合了混合专家(Mixture-of-Experts, MoE)层、标准注意力机制以及门控 Delta 网络(Gated-Delta-Net, GDN)线性注意力。
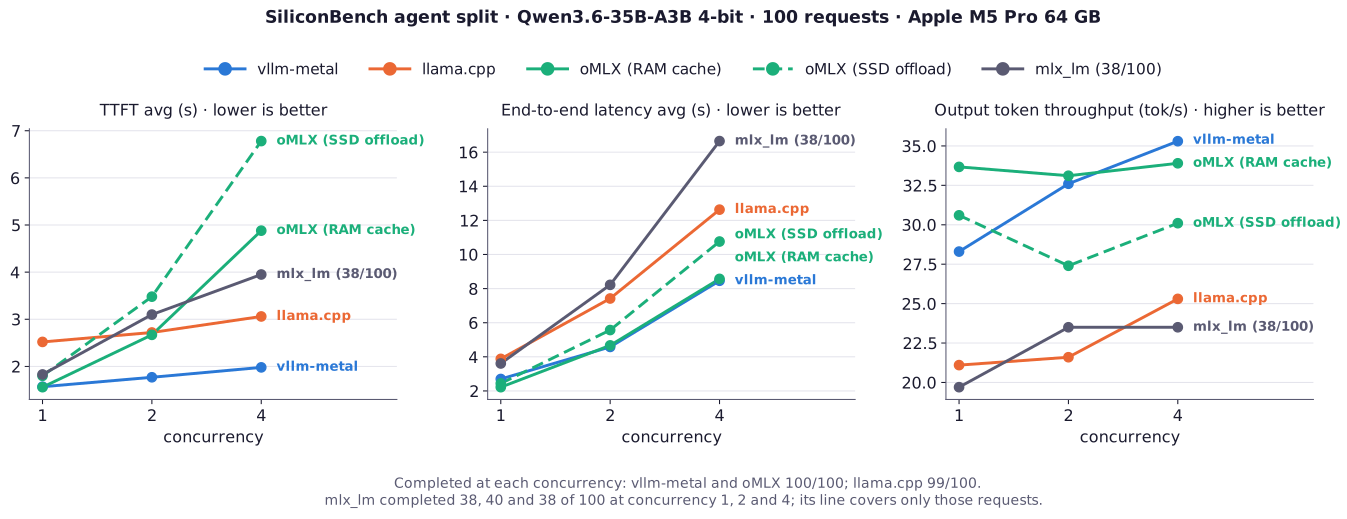
SiliconBench 智能体在 Qwen3.6-35B-A3B 上的拆分测试:TTFT、端到端请求延迟以及输出 token 吞吐量随并发量的变化,对比 llama.cpp、vllm-metal、启用内存和 SSD 前缀缓存的 oMLX,以及 mlx_lm
在并发量为 4 时,vllm-metal 和使用 RAM 缓存的 oMLX 在吞吐量和端到端延迟上表现接近,但在 TTFT 上差距较大。mlx_lm 的曲线仅涵盖其成功完成的少数请求。
并发负载下的批量 MTP
MTP(多 token 预测)使用一个辅助模型来生成草稿 token,目标模型则在连续批处理中对其进行验证。下表比较了每步生成一个草稿 token 与不使用 MTP 的生成方式在 Gemma 4 E4B 上的表现:
| 并发量 | 墙钟时间 vs. 无 MTP | 输出 tok/s vs. 无 MTP | TTFT 平均值 vs. 无 MTP |
|---|---|---|---|
| 1 | −15% | +20% | −1% |
| 8 | −1% | +0% | +4% |
| 16 | −8% | +9% | +20% |
MTP 需通过 --speculative-config 显式启用。目前 Metal 路径支持 Gemma 4 配合纯贪心采样(temperature=0)和同步调度(--no-async-scheduling)。
v0.28.0 中的其他功能
M5 上更快的预填充
在搭载 M5 芯片的 Mac 上,vllm-metal 会自动对兼容的预填充批次使用 NAX 注意力内核,该内核利用 GPU 的张量硬件加速。较早型号的 Mac 仍继续使用现有路径。此对比基于 Qwen3-0.6B:
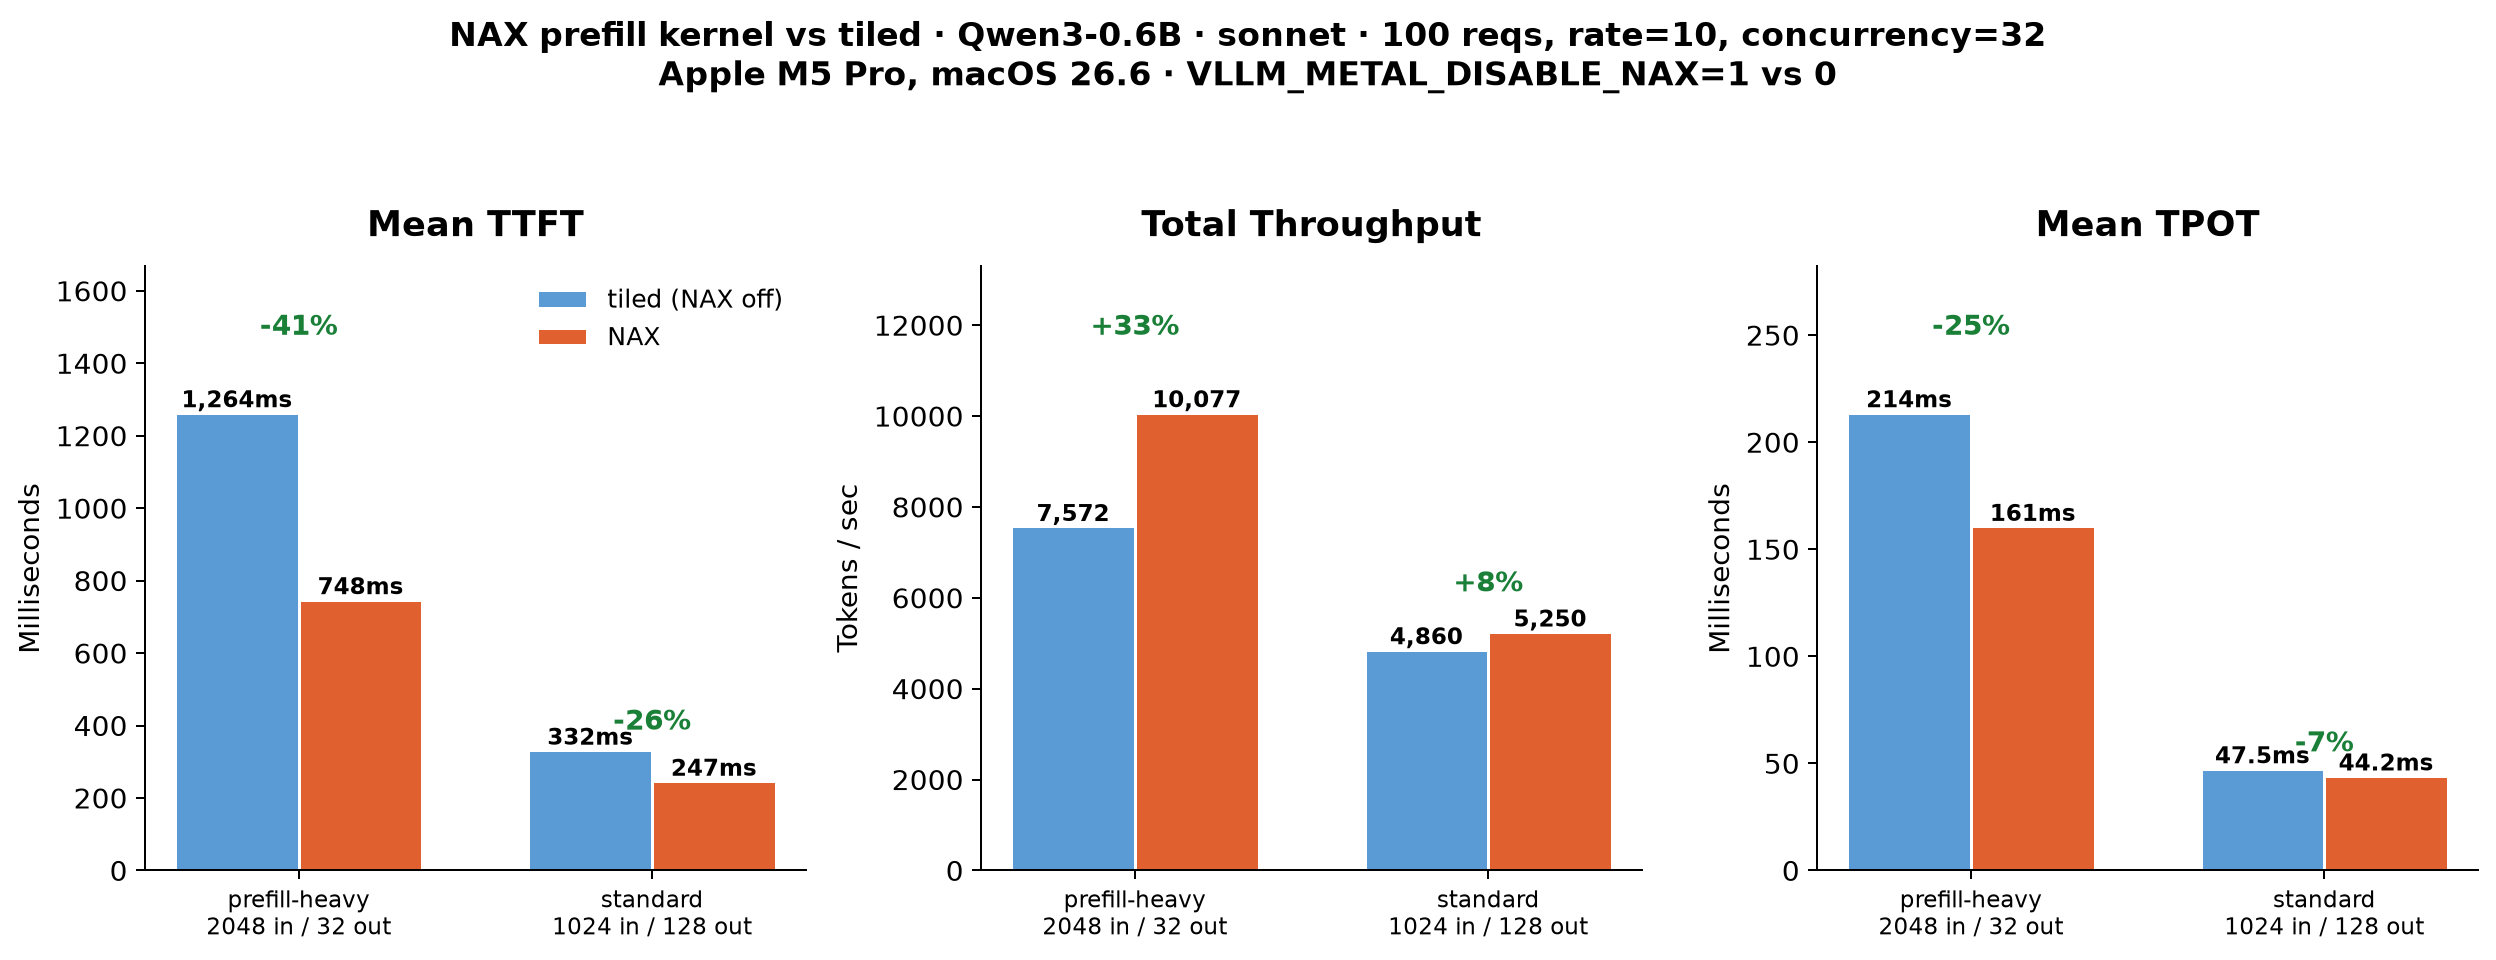
NAX 与分块注意力在 Qwen3-0.6B 上的对比:首 token 时间、总 token 吞吐量以及每输出 token 耗时
在混合模型上复用对话历史
多轮对话中的 Agent 在每一轮都会重新发送不断增长的完整对话历史。前缀缓存(Prefix caching)允许下一轮复用此前各轮已计算好的数据块,从而避免对完整历史进行重复的预填充(prefill)。
对于 Qwen3.5 风格的混合模型,vllm-metal 支持 vLLM 的 align 模式。该模式在与注意力 KV 相同的块边界处保存 GDN 循环状态,使两者均能从缓存的前缀恢复运行(PR #634)。此路径目前仍处于实验阶段,尚无法与推测解码(speculative decoding)结合使用。
模型与服务特性
v0.28.0 版本还包含以下功能:
- LoRA 适配器、结构化输出,以及三种推测解码方法:Gemma 4 MTP、独立草稿模型(draft models)和基于提示查找的 n-gram。
- GGUF 检查点,包括用于本地 GGUF 权重的 Hugging Face 配置源。
- 来自 Qwen3.5、Qwen3.6、Qwen3.8 和 Qwen3-Next 系列的混合注意力模型。
- 通过 MLX ring 后端实现跨多台 Mac 的流水线并行(Pipeline parallelism)。
- 实验性的视觉语言模型、文本嵌入与重排序(reranking),以及语音转文本功能。
支持的模型矩阵和功能指南详见 vllm-metal 文档。
从 M1 Pro 到 M5 Pro 的统一技术栈
我们在四台 Mac 上以并发数 1 和 8 运行了相同的 Gemma 4 E4B 4-bit 工作负载。
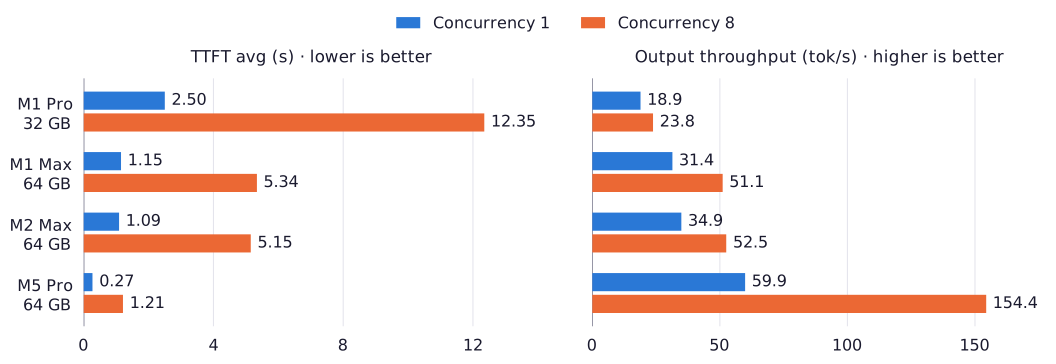
两张并排的柱状图对比了 M1 Pro 32 GB、M1 Max 64 GB、M2 Max 64 GB 和 M5 Pro 64 GB 在并发数 1 和 8 下的表现:左侧为平均首字延迟(TTFT,单位秒,越低越好),右侧为输出吞吐量(单位 token/秒,越高越好)。运行跨机器基准测试
每次运行均使用 vllm bench serve,包含 100 个 Sonnet 提示词,每个提示约含 1,024 个输入 token 和 128 个输出 token,设置 --gpu-memory-utilization 0.5,禁用前缀缓存,并为每个并发级别启动全新的服务器实例。
在所有机器上使用 vllm-metal v0.29.0 配合 vLLM 0.29.0。可通过 Homebrew 安装稳定版:
brew tap vllm-project/vllm-metal https://github.com/vllm-project/vllm-metal
brew install vllm-project/vllm-metal/vllm-metal
在一个终端中启动服务器:
vllm serve mlx-community/gemma-4-e4b-it-4bit \
  --gpu-memory-utilization 0.5 \
  --max-model-len 2048 \
  --no-enable-prefix-caching \
  --host 127.0.0.1 --port 8000
在另一个终端中,下载 Sonnet 文本并运行客户端:
curl -fsSL https://raw.githubusercontent.com/vllm-project/vllm/main/benchmarks/sonnet.txt \
  -o sonnet.txt

BENCH_MACHINE=m1pro-32gb
BENCH_CONCURRENCY=1

vllm bench serve \
  --backend vllm \
  --model mlx-community/gemma-4-e4b-it-4bit \
  --base-url http://127.0.0.1:8000 \
  --dataset-name sonnet --dataset-path sonnet.txt \
  --sonnet-input-len 1024 --sonnet-output-len 128 \
  --num-prompts 100 --num-warmups 3 \
  --request-rate 10 --max-concurrency "$BENCH_CONCURRENCY" \
  --temperature 0 --ignore-eos --seed 0 \
  --save-result --result-dir benchmark-results \
  --result-filename "${BENCH_MACHINE}-c${BENCH_CONCURRENCY}.json"
对于并发度为 8 的情况,使用 Ctrl+C 停止服务器,以相同的命令重新启动服务器,并将客户端代码块中的 BENCH_CONCURRENCY 设置为 8 后重新运行。在 M5 Pro 上,设置 BENCH_MACHINE=m5pro-64gb;为每台额外的机器使用不同的名称。
结果保存在 benchmark-results/ 目录下。图表使用 Mean TTFT(将毫秒除以 1,000 转换为秒)和 Output token throughput。请保留每个结果对应的成功请求数量。
附录:基准测试复现
跨引擎基准测试脚本和结果位于 SiliconBench。运行环境使用 vllm-metal 0.28.0.dev20260901062632 配合 vLLM 0.28.0、llama.cpp 0eadefeb 以及 oMLX dc312e6e。
运行采用贪心采样,在固定并发度下闭环执行。结果仅涵盖已完成的请求;空响应视为失败。每个引擎均使用其自身的 4-bit 量化版本。内存配置分别为:vllm-metal 默认使用 --gpu-memory-utilization 0.92,oMLX 使用平衡内存保护机制,llama.cpp 则无显式上限。
服务配置与测量细节
为每个并发级别启动全新的服务器实例,并创建空的 oMLX 缓存目录(包括 RAM 模式)。
# llama.cpp
llama-server -m <model>.gguf --host 0.0.0.0 --port 8001 \
  -ngl 99 --parallel 4 -c 65536

# vllm-metal
vllm serve <model> --host 0.0.0.0 --port 8004 \
  --enable-prefix-caching --max-model-len 16384

# vllm-metal + MTP(仅支持 Gemma)
vllm serve <model> --host 0.0.0.0 --port 8004 \
  --enable-prefix-caching --max-model-len 16384 --no-async-scheduling \
  --speculative-config '{"method":"mtp","model":"mlx-community/gemma-4-E4B-it-assistant-bf16","num_speculative_tokens":1}'

# oMLX,SSD 卸载
omlx serve --model-dir <dir> --host 0.0.0.0 --port 8005 \
  --paged-ssd-cache-dir <fresh-empty-dir> --paged-ssd-cache-max-size 100GB \
  --hot-cache-max-size 0

# oMLX,仅使用 RAM 缓存
OMLX_HOT_CACHE_ONLY=true omlx serve --model-dir <dir> --host 0.0.0.0 --port 8005 \
  --paged-ssd-cache-dir <fresh-empty-dir> --paged-ssd-cache-max-size 100GB \
  --hot-cache-max-size 8GB
填充对比报告的是每个单元格中两次全新服务器运行的中位数,每次运行包含八个请求,且每个请求生成 20 个输出 token。
NAX A/B 测试使用 Qwen3-0.6B 模型,输入/输出 token 配置分别为 2,048/32 和 1,024/128。每种配置以请求速率 10、并发数 32 运行 100 条 Sonnet 提示词。
致谢
vllm-metal 基于 Apple MLX 团队的 MLX 和 mlx_lm,用于视觉语言路径的 mlx-vlm,以及 vLLM 的引擎和硬件插件接口构建。感谢上游 vLLM 维护者一路以来的审阅与支持,也感谢所有在 v0.2 和 v0.3 版本发布期间提交问题并分享基准测试结果的用户。