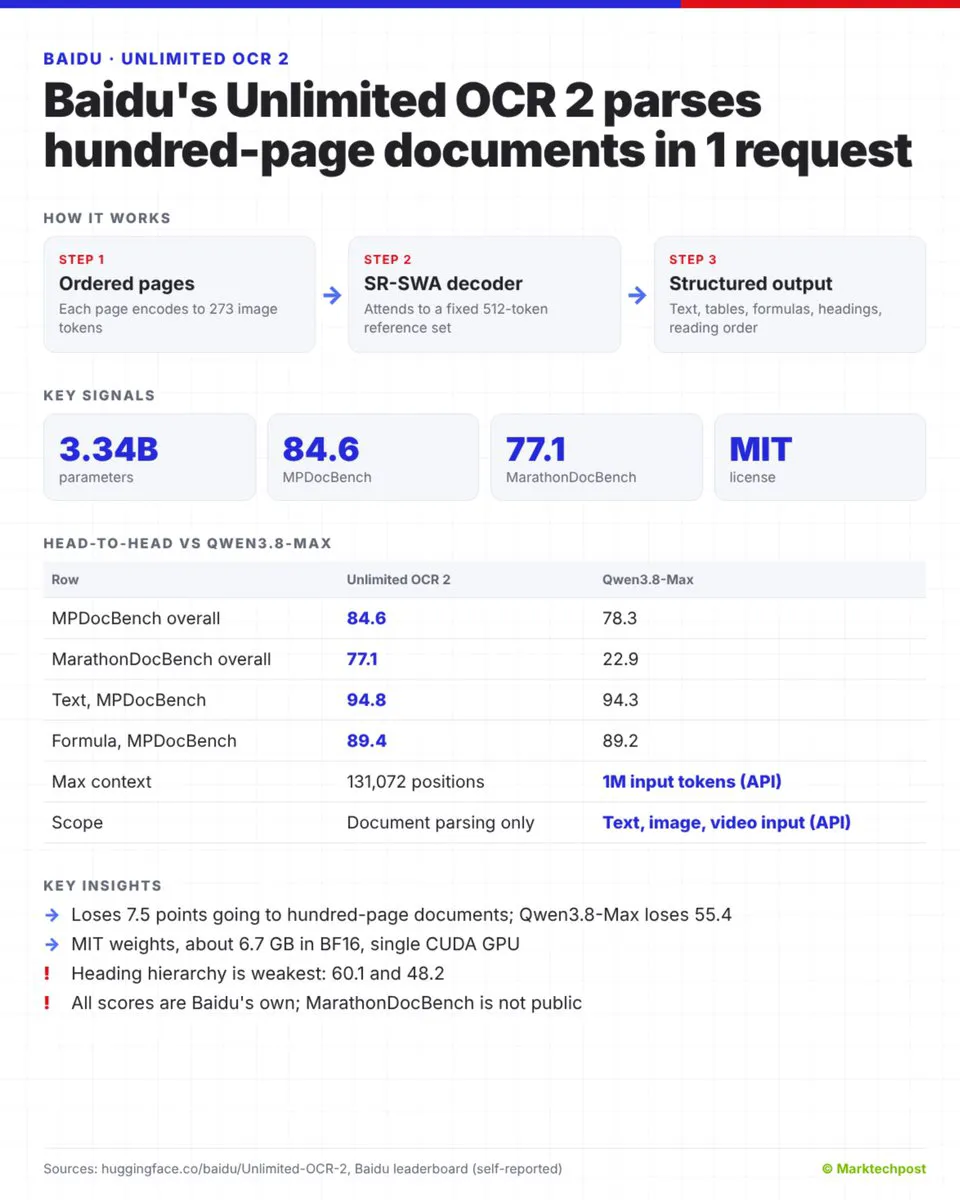
百度开源 Unlimited OCR 2 长文档解析性能大幅领先
作者:▲ Marktechpost AI (@Marktechpost)原标题:▲ Baidu just open-sourced Unlimited OCR 2, a 3B OCR model that parses books and reports of hundreds ...
85AI 研判分
百度开源了拥有33亿参数的OCR模型Unlimited OCR 2,通过引入稀疏参考滑动窗口注意力机制(SR-SWA),实现了在单次请求中高效处理数百页长文档的能力。该模型在MarathonDocBench等基准测试中显著优于Kimi-K3和Qwen3.8-Max,尽管其标题层级识别能力较弱且数据为自报,但其在保持解码延迟与内存恒定方面的技术突破极具实用价值。
报道正文
▲ Marktechpost AI · 2026-10-27 05
▲ 百度刚刚开源了 Unlimited OCR 2,这是一款拥有 3B 参数的 OCR 模型,能够在单次请求中解析数百页的书籍和报告。
其核心创新在于 SR-SWA(稀疏参考滑动窗口注意力机制)。解码器不再扫描不断增长的 KV Cache,而是关注一组固定的工作参考集——在百度的示例中为 512 个 token。随着文档长度的增加,每步解码的延迟和内存占用几乎保持恒定。
在 MarathonDocBench(数百页文档)上,该模型总体得分为 77.1,相比之下 Kimi-K3 为 33.7,Qwen3.8-Max 为 22.9。在 MPDocBench(数十页文档)上,它以 84.6 对 78.3 领先于 Qwen3.8-Max。不过这也是一种权衡:在长文档中,标题层级结构是其最弱的指标,得分仅为 48.2;参考池存在信息损失;且所有分数均为自报数据。
参数量为 3.34B,采用 MIT 许可证,BF16 权重约为 6.7 GB。可在 Transformers 上运行,并配有用于服务的定制化 SGLang 构建版本……
完整分析: