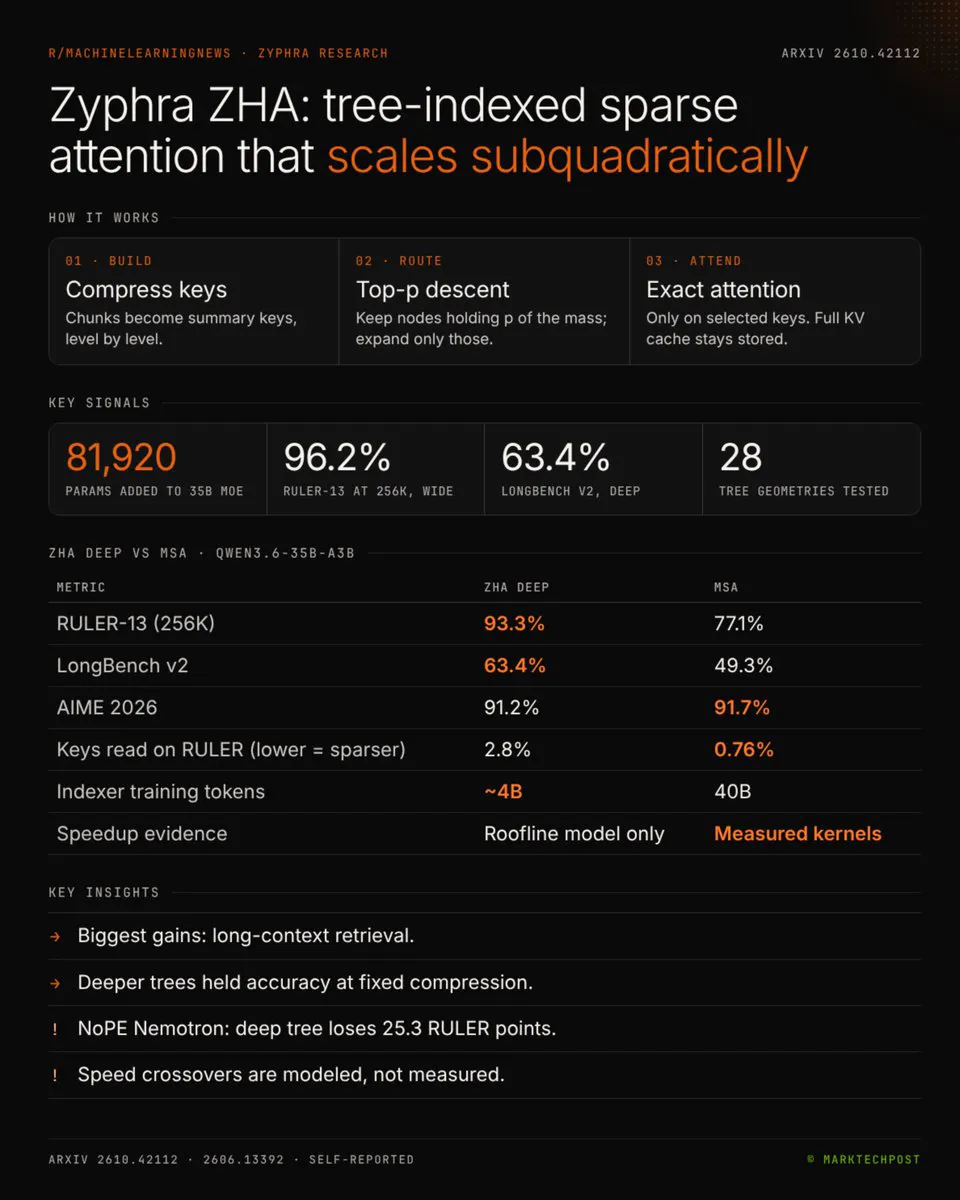
Zyphra 发布 ZHA 分层注意力机制,长上下文推理效率显著提升
Zyphra 推出 ZHA(分层注意力)稀疏注意力方法,通过构建 KV 缓存树状结构实现高效检索。该方法在 Qwen3.6-35B 模型上仅需读取约 1.1% 的键值即可在 LongBench v2 上超越密集注意力基线,且训练成本极低(仅优化 8 万参数)。尽管在特定基准测试中存在性能权衡,但其为长上下文处理提供了新的架构思路。
报道正文
▲ Marktechpost AI · 2026-11-03 01
▲ Zyphra 刚刚推出了 ZHA(Zyphra 分层注意力机制),这是一种稀疏注意力方法,其核心在于“寻找相关 token”这一过程本身也是稀疏的。
关键思想是在 KV Cache 上构建一棵树。键(keys)的分块通过 16 个可学习的参考查询被压缩为摘要键,然后逐层再次压缩。每个查询自顶向下遍历这棵树,采用 top-p 路由策略,并仅在其到达的叶子节点上执行精确注意力计算。
在冻结的 Qwen3.6-35B-A3B 模型上,宽树结构在 RULER-13 基准测试中达到 96.2% 的得分(上下文长度 256K),相比之下,密集注意力得分为 96.0%,MiniMax 稀疏注意力得分为 77.1%。在 LongBench v2 上,深树结构达到 63.4% 的得分,而密集注意力为 58.0%,且仅读取约 1.1% 的键。然而,这也是一种权衡:深树结构在 Terminal-Bench 2.1 上的得分降至 46.7%(密集注意力为 49.9%),而在 NoPE Nemotron 上则损失了 25.3 个 RULER 分数点。
转换训练仅涉及 81,920 个参数,并使用约 40 亿 token 进行 KL 蒸馏。与密集注意力和 MSA 相比,48K 和 0.48M 的交叉点来自 roofline 模型分析,而非实际发布的内核……
完整分析: