Google Research 提出“睡眠阶段”框架 解决 LLM 持续学习遗忘难题
Google Research 团队在博客中提出了针对大语言模型(LLM)的“睡眠阶段”(Sleep Phase)概念,旨在解决持续学习中的灾难性遗忘问题。该框架模拟生物睡眠机制,允许模型在部署后通过离线整合新事实来增强推理能力,同时保持原有知识稳定,突破了传统静态知识截止日期的限制。
报道正文
本文目录8 个章节
睡眠框架:大语言模型在持续学习中保留知识的新途径
2026年10月27日
Ali Behrouz,高级研究科学家;Vahab Mirrokni,副总裁兼 Google Fellow,Google Research
我们引入了持续学习中的“睡眠阶段”,使大型语言模型能够持续整合新事实并增强推理能力,同时缓解灾难性遗忘或静态知识截止问题。
现代 LLM 通过预训练和上下文内学习(ICL)实现了令人印象深刻的性能。然而,一旦部署,它们基本上保持静态,运行在一个固定的知识截止日期下,这使它们无法获得长期能力或适应新信息。
虽然使用新数据更新模型似乎是显而易见的解决方案,但持续的参数更新往往会触发灾难性遗忘,这是一个根本性问题,即学习新任务会严重损害先前已学任务的性能。或者,严格依赖 ICL 会将知识保留限制在当前的上下文窗口内:一旦上下文会话结束,所获取的短期信息就会被遗忘。
受人类大脑在休息期间处理和稳定记忆方式的启发,我们在持续学习中引入了一种睡眠框架:这是一种学习范式,赋予大型语言模型(LLM)一个连续的周期性生命周期,使其能够持续学习,将脆弱的短期上下文巩固为稳定的长期参数。通过该框架,我们证明,在主动交互和离线记忆巩固之间交替进行,可以使 LLM 持续获取新事实,保留长达 1000 万 token 的长上下文知识,并提升复杂推理能力。
重新思考机器学习:主动(清醒)阶段与睡眠阶段
传统机器学习依赖于训练和推理之间的严格分离。在持续学习框架中,这种区分变得人为化;一个智能代理必须不断学习、适应和处理信息。
在睡眠范式下,LLM 主要在两种状态下运行:
- 活跃(清醒)阶段:模型主动接收、处理输入并进行交互,同时将临时信息存储在快速、短期的记忆组件中。
- 睡眠阶段:模型暂停处理新输入,并将内部计算转向记忆整合与自我提升。
尽管“睡眠”、“做梦”和“自我提升”等术语借鉴了神经科学的概念,但我们的框架完全运行在固定的模型架构和人类定义的训练规则之内。在离线睡眠阶段,模型会解锁预先分配的混合专家(MoE)记忆块,并利用自生成的练习示例更新其数值权重。这种自动化的后训练循环有助于已部署的模型吸收新事实并提高推理准确性,同时保持其核心代码库和设计不变。
睡眠过程的关键组件
睡眠范式通过两个阶段——记忆整合和做梦——来解决灾难性遗忘和持续适应问题。
1. 记忆整合
在人脑中,非快速眼动 (NREM) 慢波睡眠通过抽象和蒸馏将脆弱的记忆巩固为长期结构。我们提出的睡眠框架通过两个关键技术机制来模拟这一自然现象:
-
参数扩展与连续记忆层级: 为了防止灾难性遗忘,模型在睡眠期间动态扩展其容量。利用 混合专家 (MoE) 和 Hope 架构,新解锁的低秩专家被集成到稳定的低频记忆块中,以存储传入的知识而不干扰旧参数。
-
知识播种(向上蒸馏): 存储在高频率层(例如上下文内记忆)中的脆弱短期记忆被转移到新扩展的长期参数中。这是通过结合 广义知识蒸馏 (GKD) 与基于 强化学习 (RL) 的 模仿学习 来实现的:
-
同策略蒸馏(On-policy distillation): 扩展后的学生模型从教师分布在自采样序列上生成的反馈中学习特定于 token 的信息。
-
模仿学习(Learning to Imitate, LTI): 当学生模型补全教师生成文本的前缀时,根据语义相似度和绝对相似度(Levenshtein 距离)获得奖励。
-
突触修剪(Synaptic pruning): 一旦记忆整合到低频模块完成,高频临时参数将被重置,从而为未来的活跃会话释放容量。
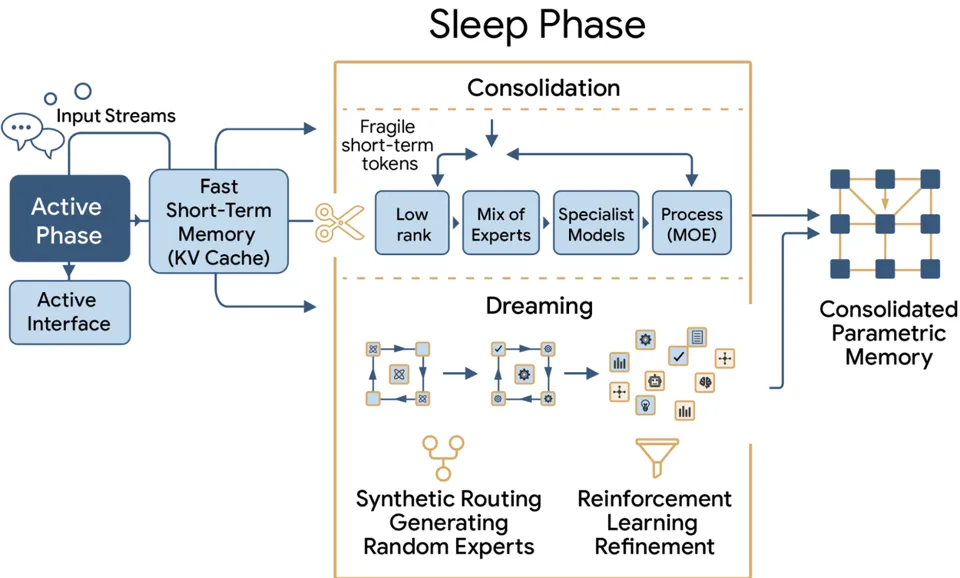
我们的睡眠框架概览:来自活跃阶段的输入流首先存储在短期记忆中,然后进入睡眠周期。该周期分为两个分支:整合(Consolidation,利用低秩结构和 MoE 将脆弱的短期 token 转移到扩展的长期参数化记忆中)和做梦(Dreaming,通过随机专家合成路由和 RL 优化实现自主自我改进)。
2. 通过“做梦”实现自我改进
在 REM 睡眠期间,人脑会主动模拟场景、巩固情感/语义连接并探索新的神经通路。与此类似,在“做梦阶段”,睡眠框架实施了一个自主的自我改进循环:
- 随机专家选择: 在合成数据生成过程中,MoE 路由器随机激活非标准专家。这迫使模型混合不同领域的知识并发现潜在模式。
- 精选排练: 模型生成合成训练样本(即“梦境”),并使用基于梯度的数据选择进行过滤,以优先处理那些最有潜力提升整体模型能力的样本。
- RL 优化: 模型对评分最高的梦境样本执行监督微调,并评估这种生成是否提高了下游任务的性能。
理论基础
除了实证结果外,我们的睡眠范式还建立在一种理论之上,该理论阐明了为什么其两个阶段(记忆整合和做梦)能够支持持续学习,而不仅仅是以牺牲旧能力为代价来换取新知识。
在记忆巩固方面,分析表明,知识播种(knowledge seeding)可以被理解为一个结构化的低秩压缩问题。模型并非被要求将其短期轨迹中的每一个细节都复制到参数中,而是识别出一组紧凑的方向,这些方向既能最好地保留模型自身的 on-policy 行为,又能保留学习目标所奖励的语义特性。
这一视角解释了两类信号的互补作用:on-policy 蒸馏使巩固过程与模型在推理时实际生成的轨迹保持一致,从而减少了仅基于教师生成分布进行训练时可能出现的失配;与此同时,语义奖励改变了值得保留的内容,优先保留那些能够维持意义和任务相关行为的方向,而不仅仅是匹配 token 概率。随后,参数扩展提供了必要的容量,以便将这些选定的记忆写入模型,同时避免覆盖先前已巩固的知识。
在“做梦”(dreaming)机制方面,理论将随机专家激活和基于奖励的样本选择描述为改善学习几何结构的机制。注入不同的 MoE(混合专家)拓宽了合成生成过程中探索的梯度方向集合,使模型接触到比仅由其常规清醒时间数据所诱导的更丰富的更新集合。随后,基于梯度的过滤强调了那些携带最有用的学习信号的合成经验,在强化信息量大的方向的同时,保留了底层梯度空间的结构。
综合来看,这些步骤产生了一个更加平衡的优化景观:学习不再由少数几个方向主导,梯度条件更好,模型在完善其能力时能够取得更稳定的进展。在这种观点下,“做梦”不仅仅是自生成数据增强;它是一个有意识的过程,用于多样化、选择和巩固模型自我改进所依赖的更新。
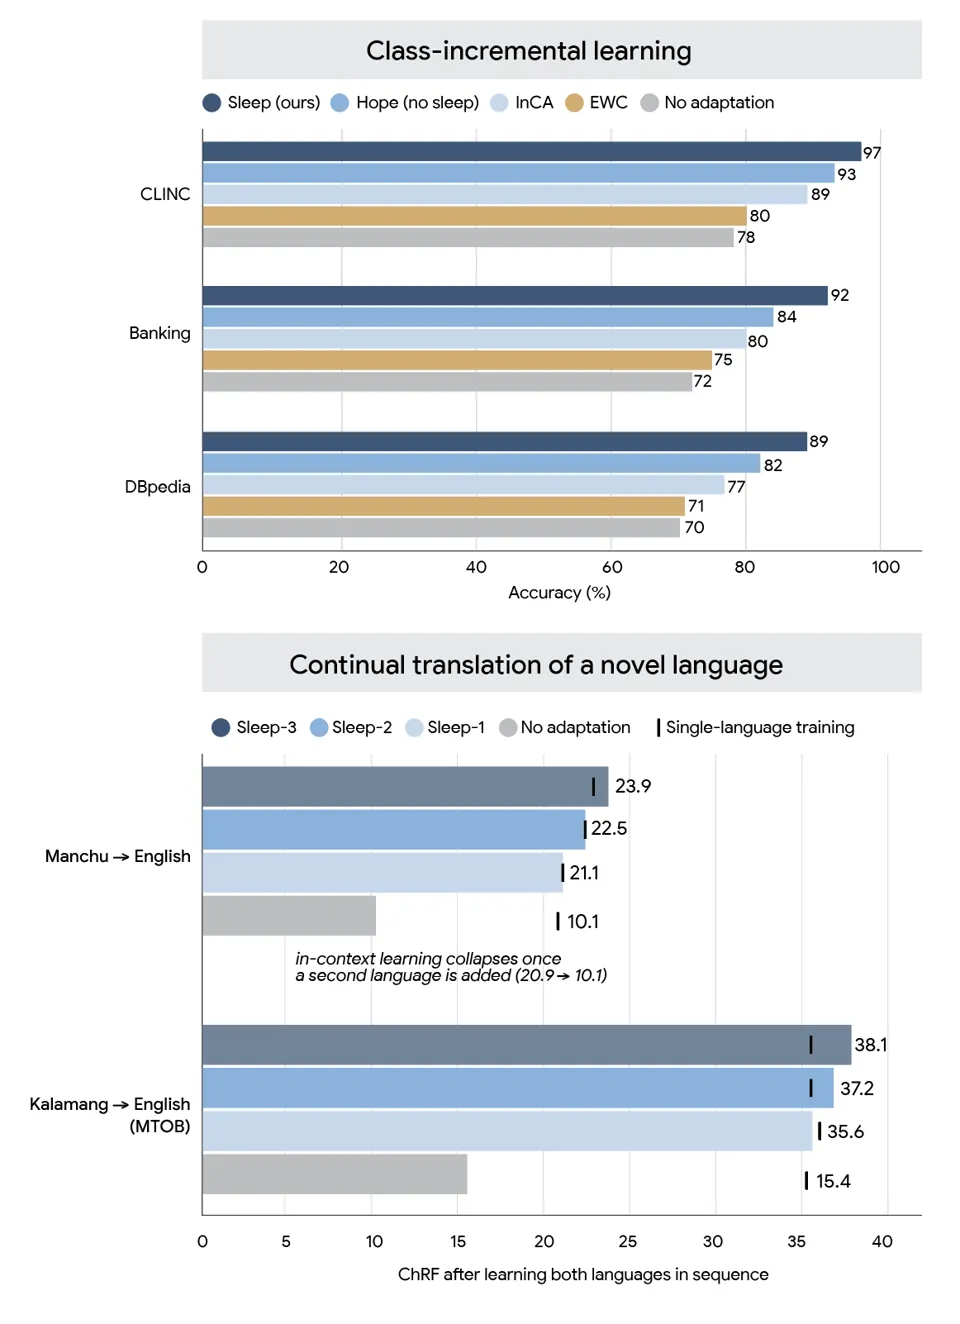
我们的“睡眠”框架与基线方法(如上下文学习和监督微调)在主要评估维度上的对比性能,包括类增量学习、持续翻译、长上下文扩展至 1000 万 token、事实知识整合以及数学推理。
对于持续翻译,在未见过语言(如满语和卡拉芒语)中,“睡眠”框架在多阶段评估中保持了近乎零的性能下降,而标准基线方法如 ICL、Cartridges 和监督微调 (SFT) 在顺序学习过程中遭受了严重的灾难性遗忘。
在 BABILong 基准测试的长上下文理解任务中,我们的“睡眠”方法展示了直至 1000 万 token 的近完美扩展能力,通过使用“睡眠时巩固”将长上下文信息直接压缩到参数化记忆中,从而超越了 GPT-4 和 Titans 等强基线模型。
在通过 SQuAD 和继续预训练 (CPT) 评估的事实知识整合方面,我们的“睡眠”方法在单任务和 CPT 评估中分别达到了 48.9% 和 46.2%,优于包括基础模型、SFT 和自适应语言模型 (SEAL) 在内的基线方法,成功整合了新的事实信息而未损害现有的模型表示。
最后,在包括 AIME 24/25 和 HMMT 25 在内的数学推理基准测试中,“睡眠”增强的基础模型分别取得了 79.2%、69.0% 和 46.1% 的准确率。这优于 SFT、组相对策略优化 (GRPO) 和在线自蒸馏 (OPSD) 等基线方法,表明将记忆巩固与模仿学习相结合能够驱动更优越的推理性能。
结论
我们的睡眠范式为构建自主、持续学习的 AI 系统提供了一条路径。通过超越静态预训练和脆弱的上下文窗口,在主动学习与离线休息之间交替进行,能够赋予大语言模型(LLM)保留短期记忆、将新技能抽象为长期参数结构的能力,并在不发生灾难性遗忘的情况下实现持续的自我改进。
致谢
本研究由 Ali Behrouz(谷歌与康奈尔大学)、Farnoosh Hashemi(康奈尔大学)、Adel Javanmard(谷歌与南加州大学)以及 Vahab Mirrokni 共同完成。感谢 Yuan Deng 和 Corinna Cortes 对本文的审阅及提出的宝贵建议。同时也感谢 Mark Simborg、Kimberly Schwede 和 Tim Herrmann 在撰写这篇博客文章时提供的帮助。