DeepSeek V4.1 Flash 在 GB300 NVL72 上单智能体推理提速 1.5 倍
原标题:DeepSeek V4.1 Flash speeds on GB300 NVL72 have increased by up to 1.5x tok/s per agent over the past...
72AI 研判分
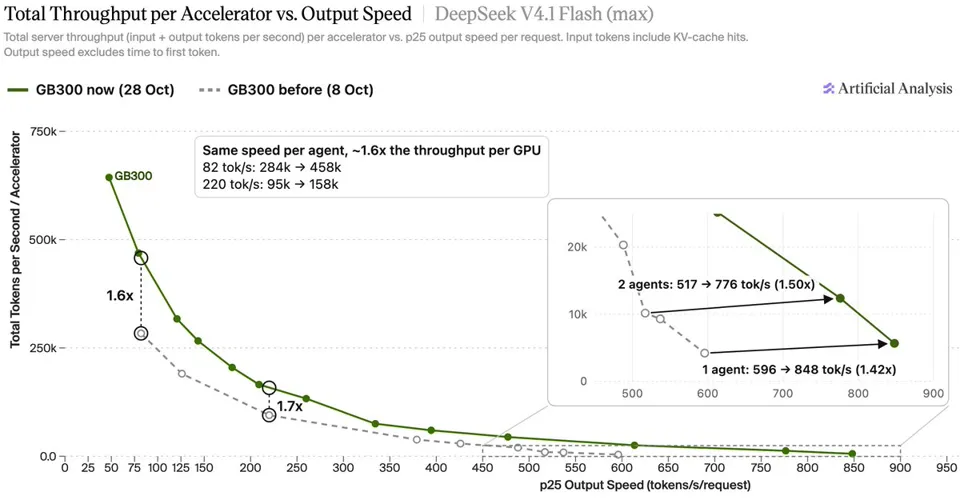
Artificial Analysis 的 AA-AgentPerf 基准显示,DeepSeek V4.1 Flash 在 GB300 NVL72 上单智能体吞吐从 596 tok/s 提升至 848 tok/s(1.42 倍),每 GPU 吞吐约提升 1.6 倍。提速主要来自新版 vLLM 及其针对 GB300 的新内核、FlashInfer 自动调优、更完整的 CUDA Graph 覆盖、调优后的投机解码,以及 NVIDIA Dynamo + vLLM 方案中预填充与解码同卡运行。
报道正文
Artificial Analysis (@ArtificialAnlys) · 2026-11-06 20
在过去一个月中,DeepSeek V4.1 Flash 在 GB300 NVL72 上的速度在 AA-AgentPerf 上每个 agent 提升最高达 1.5 倍 tok/s。AA-AgentPerf 是我们用于评测数据中心系统运行真实 agentic 编码工作负载的基准测试。
这一提升来自更新版本的 vLLM、针对 GB300 上 DeepSeek V4.1 的新 vLLM kernel、FlashInfer 自动调优、更全面的 CUDA graph 覆盖、经过调优的投机解码,以及在 NVIDIA 更新后的 Dynamo + vLLM 配置中于同一批 GPU 上运行 prefill 和 decode。
➤ 更快的速度:单 agent 达 848 tok/s,高于此前的 596(1.42 倍)
➤ 更高的吞吐量:在每 agent 约 80 tok/s 时,每 GPU 吞吐量约为原来的 1.6 倍